소개
웹의 오디오는 지금까지 상당히 원시적인 수준이었으며 매우 최근까지
Flash 및 QuickTime과 같은 플러그인을 통해 제공해야 했습니다.
HTML5에
audio
요소가 도입된 것은
기본적인 스트리밍 오디오 재생을 가능하게 한다는 점에서 매우 중요합니다. 그러나
더 복잡한 오디오 애플리케이션을 처리하기에는 충분히 강력하지 않습니다.
정교한 웹 기반 게임이나 대화형 애플리케이션에는
다른 해결책이 필요합니다. 이 명세의 목표는
최신 게임 오디오 엔진에서 제공되는 기능뿐만 아니라 최신
데스크톱 오디오 제작 애플리케이션에서 볼 수 있는 일부
믹싱, 처리 및 필터링 작업도 포함하는 것입니다.
이 API는 매우 다양한 사용 사례 [webaudio-usecases]를 염두에 두고 설계되었습니다. 이상적으로는 스크립트로 제어되고 브라우저에서 실행되는 최적화된 C++ 엔진으로 합리적으로 구현할 수 있는 모든 사용 사례를 지원할 수 있어야 합니다. 하지만 최신 데스크톱 오디오 소프트웨어는 매우 고급 기능을 제공할 수 있으며, 그중 일부는 이 시스템으로 구축하기 어렵거나 불가능할 수 있습니다. Apple의 Logic Audio가 그러한 애플리케이션 중 하나이며 외부 MIDI 컨트롤러, 임의의 플러그인 오디오 효과 및 신시사이저, 고도로 최적화된 디스크 직접 오디오 파일 읽기/쓰기, 긴밀하게 통합된 타임 스트레칭 등을 지원합니다. 그럼에도 제안된 시스템은 음악 관련 애플리케이션을 포함하여 합리적으로 복잡한 다양한 게임과 대화형 애플리케이션을 충분히 지원할 수 있습니다. 또한 WebGL에서 제공하는 더 고급 그래픽 기능을 매우 잘 보완할 수 있습니다. 이 API는 이후에 더 고급 기능을 추가할 수 있도록 설계되었습니다.
기능
이 API는 다음과 같은 주요 기능을 지원합니다:
-
단순하거나 복잡한 믹싱/효과 아키텍처를 위한 모듈식 라우팅.
-
내부 처리에 32비트 부동소수점을 사용하는 높은 동적 범위.
-
샘플 단위로 정확하게 예약된 사운드 재생과 낮은 지연 시간을 지원하여 드럼 머신 및 시퀀서처럼 매우 높은 수준의 리듬 정확도가 필요한 음악 애플리케이션에 사용할 수 있습니다. 여기에는 효과를 동적으로 생성할 수 있는 기능도 포함됩니다.
-
엔벌로프, 페이드 인 / 페이드 아웃, 그래뉼러 효과, 필터 스윕, LFO 등의 오디오 매개변수 자동화.
-
오디오 스트림의 채널을 유연하게 처리하여 분할하고 병합할 수 있습니다.
-
getUserMedia()에서 가져온MediaStream을 사용하여 라이브 오디오 입력을 처리합니다. -
WebRTC와의 통합
-
MediaStreamTrackAudioSourceNode및 [webrtc]를 사용하여 원격 피어에서 수신한 오디오를 처리합니다. -
MediaStreamAudioDestinationNode및 [webrtc]를 사용하여 생성되거나 처리된 오디오 스트림을 원격 피어로 보냅니다.
-
-
스크립트를 직접 사용한 오디오 스트림 합성 및 처리.
-
다양한 3D 게임과 몰입형 환경을 지원하는 공간화 오디오:
-
패닝 모델: equalpower, HRTF, 패스스루
-
거리 감쇠
-
사운드 콘
-
방해 / 차폐
-
소스 / 리스너 기반
-
-
특히 매우 고품질의 공간 효과를 포함하여 다양한 선형 효과를 위한 컨볼루션 엔진. 가능한 효과의 예는 다음과 같습니다:
-
작은 / 큰 방
-
대성당
-
콘서트홀
-
동굴
-
터널
-
복도
-
숲
-
원형극장
-
출입구를 통해 들리는 먼 방의 소리
-
극단적인 필터
-
기묘한 역방향 효과
-
극단적인 콤 필터 효과
-
-
전체적인 제어와 믹스 품질 향상을 위한 다이내믹스 압축
-
로우패스, 하이패스 및 기타 일반적인 필터를 위한 효율적인 바이쿼드 필터.
-
왜곡 및 기타 비선형 효과를 위한 웨이브셰이핑 효과
-
오실레이터
모듈식 라우팅
모듈식 라우팅을 사용하면 서로 다른
AudioNode
객체 사이를 임의로 연결할 수 있습니다. 각 노드에는
입력 및/또는 출력이 있을 수 있습니다.
소스 노드에는
입력이 없고 출력이 하나 있습니다.
대상 노드에는
입력이 하나 있고 출력이 없습니다. 필터와 같은 다른 노드는
소스 노드와 대상 노드 사이에 배치할 수 있습니다. 두 객체가 서로 연결될 때
개발자는 저수준 스트림 형식
세부 사항을 신경 쓸 필요가 없습니다;
적절한 처리가 자동으로 이루어집니다.
예를 들어 모노 오디오 스트림이
스테레오 입력에 연결되면 왼쪽 및 오른쪽 채널로
적절하게 믹싱됩니다.
가장 단순한 경우 하나의 소스를 출력으로 직접 라우팅할 수 있습니다.
모든 라우팅은 하나의 AudioDestinationNode를
포함하는
AudioContext
내에서 이루어집니다:
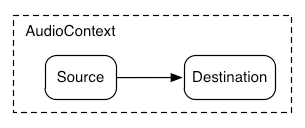
이 간단한 라우팅을 설명하기 위해, 하나의 사운드를 재생하는 간단한 예는 다음과 같습니다:
const context= new AudioContext(); function playSound() { const source= context. createBufferSource(); source. buffer= dogBarkingBuffer; source. connect( context. destination); source. start( 0 ); }
다음은 세 개의 소스와 컨볼루션 리버브 센드, 그리고 최종 출력 단계의 다이내믹스 컴프레서를 사용하는 더 복잡한 예입니다:
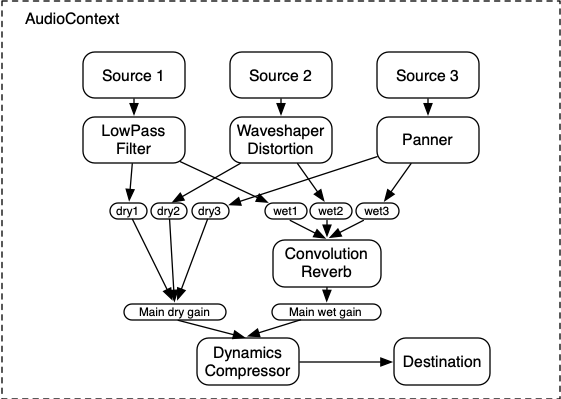
let context; let compressor; let reverb; let source1, source2, source3; let lowpassFilter; let waveShaper; let panner; let dry1, dry2, dry3; let wet1, wet2, wet3; let mainDry; let mainWet; function setupRoutingGraph() { context= new AudioContext(); // 효과 노드를 생성합니다. lowpassFilter= context. createBiquadFilter(); waveShaper= context. createWaveShaper(); panner= context. createPanner(); compressor= context. createDynamicsCompressor(); reverb= context. createConvolver(); // 메인 웨트와 드라이를 생성합니다. mainDry= context. createGain(); mainWet= context. createGain(); // 최종 컴프레서를 최종 대상으로 연결합니다. compressor. connect( context. destination); // 메인 드라이와 웨트를 컴프레서에 연결합니다. mainDry. connect( compressor); mainWet. connect( compressor); // 리버브를 메인 웨트에 연결합니다. reverb. connect( mainWet); // 몇 개의 소스를 생성합니다. source1= context. createBufferSource(); source2= context. createBufferSource(); source3= context. createOscillator(); source1. buffer= manTalkingBuffer; source2. buffer= footstepsBuffer; source3. frequency. value= 440 ; // source1을 연결합니다 dry1= context. createGain(); wet1= context. createGain(); source1. connect( lowpassFilter); lowpassFilter. connect( dry1); lowpassFilter. connect( wet1); dry1. connect( mainDry); wet1. connect( reverb); // source2를 연결합니다 dry2= context. createGain(); wet2= context. createGain(); source2. connect( waveShaper); waveShaper. connect( dry2); waveShaper. connect( wet2); dry2. connect( mainDry); wet2. connect( reverb); // source3을 연결합니다 dry3= context. createGain(); wet3= context. createGain(); source3. connect( panner); panner. connect( dry3); panner. connect( wet3); dry3. connect( mainDry); wet3. connect( reverb); // 이제 소스를 시작합니다. source1. start( 0 ); source2. start( 0 ); source3. start( 0 ); }
모듈식 라우팅을 사용하면
AudioNode의
출력을
다른 AudioNode의
동작을
제어하는 AudioParam
매개변수로 라우팅할 수도 있습니다. 이 경우
노드의 출력은 입력 신호가 아니라
변조 신호로 작동할 수 있습니다.
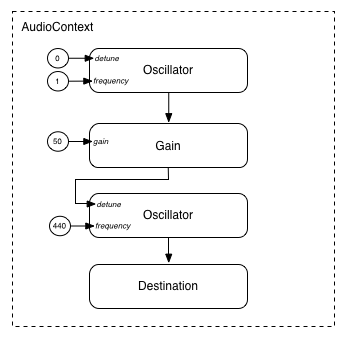
function setupRoutingGraph() { const context= new AudioContext(); // 변조 신호를 공급하는 저주파 오실레이터를 생성합니다 const lfo= context. createOscillator(); lfo. frequency. value= 1.0 ; // 변조될 고주파 오실레이터를 생성합니다 const hfo= context. createOscillator(); hfo. frequency. value= 440.0 ; // 게인이 변조 신호의 진폭을 결정하는 게인 노드를 생성합니다 const modulationGain= context. createGain(); modulationGain. gain. value= 50 ; // 그래프를 구성하고 오실레이터를 시작합니다 lfo. connect( modulationGain); modulationGain. connect( hfo. detune); hfo. connect( context. destination); hfo. start( 0 ); lfo. start( 0 ); }
API 개요
정의된 인터페이스는 다음과 같습니다:
-
AudioContext 인터페이스는
AudioNode간의 연결을 나타내는 오디오 신호 그래프를 포함합니다. -
AudioNode인터페이스는 오디오 소스, 오디오 출력 및 중간 처리 모듈을 나타냅니다.AudioNode는 모듈식 방식으로 동적으로 서로 연결할 수 있습니다.AudioNode는AudioContext컨텍스트 내에 존재합니다. -
AnalyserNode인터페이스는 음악 시각화 도구 또는 기타 시각화 애플리케이션에 사용하는AudioNode입니다. -
AudioBuffer인터페이스는 메모리에 상주하는 오디오 자산을 다루기 위한 것입니다. 이는 일회성 사운드 또는 더 긴 오디오 클립을 나타낼 수 있습니다. -
AudioBufferSourceNode인터페이스는 AudioBuffer에서 오디오를 생성하는AudioNode입니다. -
AudioDestinationNode인터페이스는 렌더링된 모든 오디오의 최종 대상을 나타내는AudioNode하위 클래스입니다. -
AudioParam인터페이스는 볼륨과 같은AudioNode동작의 개별 측면을 제어하기 위한 것입니다. -
AudioListener인터페이스는 공간화를 위해PannerNode와 함께 작동합니다. -
AudioWorklet인터페이스는 스크립트를 직접 사용하여 오디오를 처리할 수 있는 사용자 정의 노드를 생성하는 팩토리를 나타냅니다. -
AudioWorkletGlobalScope인터페이스는 AudioWorkletProcessor 처리 스크립트가 실행되는 컨텍스트입니다. -
AudioWorkletNode인터페이스는 AudioWorkletProcessor에서 처리되는 노드를 나타내는AudioNode입니다. -
AudioWorkletProcessor인터페이스는 오디오 워커 내부의 단일 노드 인스턴스를 나타냅니다. -
BiquadFilterNode인터페이스는 다음과 같은 일반적인 저차 필터를 위한AudioNode입니다:-
로우패스
-
하이패스
-
밴드패스
-
로우 셸프
-
하이 셸프
-
피킹
-
노치
-
올패스
-
-
ChannelMergerNode인터페이스는 여러 오디오 스트림의 채널을 하나의 오디오 스트림으로 결합하는AudioNode입니다. -
ChannelSplitterNode인터페이스는 라우팅 그래프에서 오디오 스트림의 개별 채널에 접근하기 위한AudioNode입니다. -
ConstantSourceNode인터페이스는 값을 자동화할 수 있도록AudioParam을 사용하여 명목상 일정한 출력 값을 생성하는AudioNode입니다. -
ConvolverNode인터페이스는 실시간 선형 효과(예: 콘서트홀의 소리)를 적용하기 위한AudioNode입니다. -
DynamicsCompressorNode인터페이스는 다이내믹스 압축을 위한AudioNode입니다. -
IIRFilterNode인터페이스는 범용 IIR 필터를 위한AudioNode입니다. -
MediaElementAudioSourceNode인터페이스는audio,video, 또는 기타 미디어 요소의 오디오 소스인AudioNode입니다. -
MediaStreamAudioSourceNode인터페이스는 라이브 오디오 입력 또는 원격 피어에서 가져온MediaStream의 오디오 소스인AudioNode입니다. -
MediaStreamTrackAudioSourceNode인터페이스는MediaStreamTrack의 오디오 소스인AudioNode입니다. -
MediaStreamAudioDestinationNode인터페이스는 원격 피어로 전송되는MediaStream의 오디오 대상인AudioNode입니다. -
PannerNode인터페이스는 3D 공간에서 오디오를 공간화 / 배치하기 위한AudioNode입니다. -
PeriodicWave인터페이스는OscillatorNode에서 사용할 사용자 정의 주기 파형을 지정하기 위한 것입니다. -
OscillatorNode인터페이스는 주기 파형을 생성하기 위한AudioNode입니다. -
StereoPannerNode인터페이스는 스테레오 스트림에서 오디오 입력을 등전력 방식으로 배치하기 위한AudioNode입니다. -
WaveShaperNode인터페이스는 왜곡 및 기타 더 미묘한 워밍 효과를 위한 비선형 웨이브셰이핑 효과를 적용하는AudioNode입니다. -
AudioPlaybackStats인터페이스는AudioContext에서 재생된 오디오에 대한 통계를 제공합니다.
Web Audio API에서 사용 중단되었지만 대체 기능의 구현 경험을 기다리며 아직 제거되지 않은 몇 가지 기능도 있습니다:
-
ScriptProcessorNode인터페이스는 스크립트를 직접 사용하여 오디오를 생성하거나 처리하기 위한AudioNode입니다. -
AudioProcessingEvent인터페이스는ScriptProcessorNode객체와 함께 사용하는 이벤트 유형입니다.
1. 오디오 API
1.1.
BaseAudioContext
인터페이스
이 인터페이스는 AudioNode
객체 집합과 그 연결을 나타냅니다.
AudioDestinationNode로
신호를 임의로 라우팅할 수 있습니다.
노드는 컨텍스트에서 생성된 다음 서로 연결됩니다.
BaseAudioContext는
직접 인스턴스화되지 않고,
대신 구체적인 인터페이스인
AudioContext
(실시간 렌더링용) 및
OfflineAudioContext
(오프라인 렌더링용)에 의해 확장됩니다.
BaseAudioContext는
초기에 비어 있는 순서가 있는 프로미스 목록인 내부 슬롯
[[pending promises]]과 함께 생성됩니다.
각 BaseAudioContext에는
고유한
미디어 요소 이벤트 태스크 소스가 있습니다.
또한 BaseAudioContext에는
AudioContextState에서
값을 취하는 여러 비공개 슬롯인 [[rendering thread state]] 및
[[control thread state]]가 있으며,
둘 다 처음에는 "suspended"
로 설정됩니다. 또한 AudioContextState에서
값을 취하고 처음에는
null로 설정되는 [[state before interruption]]
과 부호 없는 정수인 비공개 슬롯 [[render quantum
size]]도 있습니다.
enum {AudioContextState "suspended" ,"running" ,"closed" ,"interrupted" };
| 열거형 값 | 설명 |
|---|---|
"suspended"
| 이 컨텍스트는 현재 일시 중지되어 있습니다(컨텍스트 시간이 진행되지 않으며, 오디오 하드웨어가 꺼지거나 해제될 수 있습니다). |
"running"
| 오디오가 처리되고 있습니다. |
"closed"
| 이 컨텍스트는 해제되었으며 더 이상 오디오 처리에 사용할 수 없습니다. 모든 시스템 오디오 리소스가 해제되었습니다. |
"interrupted"
| 이 컨텍스트는 현재 중단되어 있으며 중단이 끝날 때까지 오디오를 처리할 수 없습니다. |
enum {AudioContextRenderSizeCategory "default" ,"hardware" };
| 열거형 설명 | |
|---|---|
"default"
| AudioContext의 렌더 퀀텀 크기는 기본값인 128 프레임입니다. |
"hardware"
|
사용자 에이전트는 현재 구성에 가장 적합한
렌더 퀀텀
크기를 선택합니다.
참고: 이는 호스트에 관한 정보를 노출하며 지문 채취에 사용될 수 있습니다. |
callback DecodeErrorCallback =undefined (DOMException );error callback DecodeSuccessCallback =undefined (AudioBuffer ); [decodedData Exposed =Window ]interface BaseAudioContext :EventTarget {readonly attribute AudioDestinationNode destination ;readonly attribute float sampleRate ;readonly attribute double currentTime ;readonly attribute AudioListener listener ;readonly attribute AudioContextState state ;readonly attribute unsigned long renderQuantumSize ; [SameObject ,SecureContext ]readonly attribute AudioWorklet audioWorklet ;attribute EventHandler onstatechange ;AnalyserNode createAnalyser ();BiquadFilterNode createBiquadFilter ();AudioBuffer createBuffer (unsigned long ,numberOfChannels unsigned long ,length float );sampleRate AudioBufferSourceNode createBufferSource ();ChannelMergerNode createChannelMerger (optional unsigned long numberOfInputs = 6);ChannelSplitterNode createChannelSplitter (optional unsigned long numberOfOutputs = 6);ConstantSourceNode createConstantSource ();ConvolverNode createConvolver ();DelayNode createDelay (optional double maxDelayTime = 1.0);DynamicsCompressorNode createDynamicsCompressor ();GainNode createGain ();IIRFilterNode createIIRFilter (sequence <double >,feedforward sequence <double >);feedback OscillatorNode createOscillator ();PannerNode createPanner ();PeriodicWave createPeriodicWave (sequence <float >,real sequence <float >,imag optional PeriodicWaveConstraints = {});constraints ScriptProcessorNode createScriptProcessor (optional unsigned long bufferSize = 0,optional unsigned long numberOfInputChannels = 2,optional unsigned long numberOfOutputChannels = 2);StereoPannerNode createStereoPanner ();WaveShaperNode createWaveShaper ();Promise <AudioBuffer >decodeAudioData (ArrayBuffer ,audioData optional DecodeSuccessCallback ?,successCallback optional DecodeErrorCallback ?); };errorCallback
1.1.1. 속성
audioWorklet, 유형은 AudioWorklet, 읽기 전용-
[HTML] 및
AudioWorklet에서 정의한 알고리즘을 통해AudioWorkletProcessor클래스 정의를 포함하는 스크립트를 가져올 수 있는Worklet객체에 접근할 수 있습니다. currentTime, 유형은 double, 읽기 전용-
이는 컨텍스트의 렌더링 그래프가 가장 최근에 처리한 오디오 블록의 마지막 샘플 프레임 바로 다음 샘플 프레임의 시간(초 단위)입니다. 컨텍스트의 렌더링 그래프가 아직 오디오 블록을 처리하지 않았다면
currentTime의 값은 0입니다.currentTime의 시간 좌표계에서 값 0은 그래프가 처리한 첫 번째 블록의 첫 번째 샘플 프레임에 해당합니다. 이 시스템에서 경과 시간은BaseAudioContext가 생성한 오디오 스트림의 경과 시간에 해당하며, 시스템의 다른 시계와 동기화되지 않을 수 있습니다. (OfflineAudioContext의 경우 스트림이 어떤 장치에서도 실제로 재생되지 않으므로 실시간에 대한 근사값조차 없습니다.)Web Audio API에서 예약된 모든 시간은
currentTime의 값을 기준으로 합니다.BaseAudioContext가 "running" 상태이면, 이 속성의 값은 단조 증가하며 하나의 렌더 퀀텀에 해당하는 일정한 증분으로 렌더링 스레드에 의해 업데이트됩니다. 따라서 실행 중인 컨텍스트의 경우 시스템이 오디오 블록을 처리함에 따라currentTime이 지속적으로 증가하고, 항상 다음에 처리할 오디오 블록의 시작 시간을 나타냅니다. 또한 현재 상태에서 예약된 변경 사항이 적용될 수 있는 가장 이른 시간이기도 합니다.currentTime은 반환되기 전에 제어 스레드에서 원자적으로 읽어야 합니다. destination, 유형은 AudioDestinationNode, 읽기 전용-
모든 오디오의 최종 대상을 나타내는 하나의 입력을 가진
AudioDestinationNode입니다. 일반적으로 실제 오디오 하드웨어를 나타냅니다. 오디오를 활발하게 렌더링하는 모든AudioNode는 직접 또는 간접적으로destination에 연결됩니다. listener, 유형은 AudioListener, 읽기 전용-
3D 공간화에 사용되는
AudioListener입니다. onstatechange, 유형은 EventHandler-
AudioContext의 상태가 변경되었을 때 (즉, 해당 프로미스가 이행되는 시점에)
BaseAudioContext로 디스패치되는 이벤트의 이벤트 핸들러를 설정하는 데 사용되는 속성입니다. 이 이벤트 핸들러의 이벤트 유형은statechange입니다.Event인터페이스를 사용하는 이벤트가 이벤트 핸들러로 디스패치되며, 핸들러는 AudioContext의 상태를 직접 조회할 수 있습니다. 새로 생성된 AudioContext는 항상suspended상태에서 시작하며, 상태가 다른 상태로 변경될 때마다 상태 변경 이벤트가 발생합니다. 이 이벤트는complete이벤트가 발생하기 전에 발생합니다. sampleRate, 유형은 float, 읽기 전용-
BaseAudioContext가 오디오를 처리하는 샘플 레이트(초당 샘플 프레임 수)입니다. 컨텍스트의 모든AudioNode가 이 레이트로 실행된다고 가정합니다. 이 가정에 따라 실시간 처리에서는 샘플 레이트 변환기 또는 "varispeed" 프로세서를 지원하지 않습니다. 나이퀴스트 주파수는 이 샘플 레이트 값의 절반입니다. state, 유형은 AudioContextState, 읽기 전용-
BaseAudioContext의 현재 상태를 설명합니다. 이 속성을 가져오면[[control thread state]]슬롯의 내용을 반환합니다. renderQuantumSize, 유형은 unsigned long, 읽기 전용-
이 속성을 가져오면
[[render quantum size]]슬롯의 값을 반환합니다.
1.1.2. 메서드
createAnalyser()-
AnalyserNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:AnalyserNode createBiquadFilter()-
여러 일반적인 필터 유형 중 하나로 구성할 수 있는 2차 필터를 나타내는
BiquadFilterNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:BiquadFilterNode createBuffer(numberOfChannels, length, sampleRate)-
지정된 크기의 AudioBuffer를 생성합니다. 버퍼의 오디오 데이터는 0으로 초기화됩니다(무음). 인수 중 하나라도 음수이거나 0이거나 명목 범위를 벗어나면
NotSupportedError예외를 반드시 발생시켜야 합니다.BaseAudioContext.createBuffer() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 numberOfChannelsunsigned long✘ ✘ 버퍼가 가질 채널 수를 결정합니다. 구현은 반드시 최소 32개 채널을 지원해야 합니다. lengthunsigned long✘ ✘ 샘플 프레임 단위로 버퍼 크기를 결정합니다. 이는 반드시 1 이상이어야 합니다. sampleRatefloat✘ ✘ 버퍼의 선형 PCM 오디오 데이터의 샘플 레이트를 초당 샘플 프레임 수로 설명합니다. 필수 지원 범위는 § 2.4 지원되는 샘플 레이트를 참조하십시오. 반환 유형:AudioBuffer createBufferSource()-
AudioBufferSourceNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:AudioBufferSourceNode createChannelMerger(numberOfInputs)-
채널 병합기를 나타내는
ChannelMergerNode를 위한 팩토리 메서드입니다.numberOfInputs가 1보다 작거나 지원되는 채널 수보다 크면IndexSizeError예외를 반드시 발생시켜야 합니다.BaseAudioContext.createChannelMerger(numberOfInputs) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 numberOfInputsunsigned long✘ ✔ 입력 수를 결정합니다. 최대 32의 값까지 반드시 지원해야 합니다. 지정하지 않으면 6을 사용합니다.반환 유형:ChannelMergerNode createChannelSplitter(numberOfOutputs)-
채널 분할기를 나타내는
ChannelSplitterNode를 위한 팩토리 메서드입니다.numberOfOutputs가 1보다 작거나 지원되는 채널 수보다 크면IndexSizeError예외를 반드시 발생시켜야 합니다.BaseAudioContext.createChannelSplitter(numberOfOutputs) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 numberOfOutputsunsigned long✘ ✔ 출력 수입니다. 최대 32의 값까지 반드시 지원해야 합니다. 지정하지 않으면 6을 사용합니다.반환 유형:ChannelSplitterNode createConstantSource()-
ConstantSourceNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:ConstantSourceNode createConvolver()-
ConvolverNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:ConvolverNode createDelay(maxDelayTime)-
DelayNode를 위한 팩토리 메서드입니다. 초기 기본 지연 시간은 0초입니다.BaseAudioContext.createDelay(maxDelayTime) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 maxDelayTimedouble✘ ✔ 지연선에 허용되는 최대 지연 시간을 초 단위로 지정합니다. 지정하는 경우 이 값은 반드시 0보다 크고 3분보다 작아야 하며, 그렇지 않으면 NotSupportedError예외를 반드시 발생시켜야 합니다. 지정하지 않으면1을 사용합니다.반환 유형:DelayNode createDynamicsCompressor()-
DynamicsCompressorNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:DynamicsCompressorNode createGain()-
매개변수 없음.반환 유형:
GainNode createIIRFilter(feedforward, feedback)-
BaseAudioContext.createIIRFilter() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 feedforwardsequence<double>✘ ✘ IIR 필터 전달 함수의 피드포워드(분자) 계수 배열입니다. 이 배열의 최대 길이는 20입니다. 모든 값이 0이면 InvalidStateError를 반드시 발생시켜야 합니다. 배열 길이가 0이거나 20보다 크면NotSupportedError를 반드시 발생시켜야 합니다.feedbacksequence<double>✘ ✘ IIR 필터 전달 함수의 피드백(분모) 계수 배열입니다. 이 배열의 최대 길이는 20입니다. 배열의 첫 번째 요소가 0이면 InvalidStateError를 반드시 발생시켜야 합니다. 배열 길이가 0이거나 20보다 크면NotSupportedError를 반드시 발생시켜야 합니다.반환 유형:IIRFilterNode createOscillator()-
OscillatorNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:OscillatorNode createPanner()-
PannerNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:PannerNode createPeriodicWave(real, imag, constraints)-
PeriodicWave를 생성하기 위한 팩토리 메서드입니다.이 메서드를 호출할 때 다음 단계를 실행합니다:-
real및imag의 길이가 같지 않으면IndexSizeError를 반드시 발생시켜야 합니다. -
o를
PeriodicWaveOptions유형의 새 객체로 둡니다. -
이 팩토리 메서드에 전달된
real및imag매개변수를 각각 o에서 같은 이름을 가진 속성에 설정합니다. -
o의
disableNormalization속성을 팩토리 메서드에 전달된constraints속성의disableNormalization속성 값으로 설정합니다. -
새
PeriodicWavep를 생성하면서, 이 팩토리 메서드가 호출된BaseAudioContext를 첫 번째 인수로 전달하고 o를 전달합니다. -
p를 반환합니다.
BaseAudioContext.createPeriodicWave() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 realsequence<float>✘ ✘ 코사인 매개변수의 시퀀스입니다. 더 자세한 설명은 해당 real생성자 인수를 참조하십시오.imagsequence<float>✘ ✘ 사인 매개변수의 시퀀스입니다. 더 자세한 설명은 해당 imag생성자 인수를 참조하십시오.constraintsPeriodicWaveConstraints✘ ✔ 지정하지 않으면 파형이 정규화됩니다. 그렇지 않으면 constraints에서 지정한 값에 따라 파형이 정규화됩니다.반환 유형:PeriodicWave -
createScriptProcessor(bufferSize, numberOfInputChannels, numberOfOutputChannels)-
ScriptProcessorNode를 위한 팩토리 메서드입니다. 이 메서드는AudioWorkletNode로 대체될 예정이므로 사용 중단되었습니다. 스크립트를 사용한 직접적인 오디오 처리를 위해ScriptProcessorNode를 생성합니다.bufferSize또는numberOfInputChannels또는numberOfOutputChannels가 유효한 범위를 벗어나면IndexSizeError예외를 반드시 발생시켜야 합니다.numberOfInputChannels및numberOfOutputChannels가 둘 다 0인 것은 유효하지 않습니다. 이 경우IndexSizeError예외를 반드시 발생시켜야 합니다.BaseAudioContext.createScriptProcessor(bufferSize, numberOfInputChannels, numberOfOutputChannels) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 bufferSizeunsigned long✘ ✔ bufferSize매개변수는 샘플 프레임 단위로 버퍼 크기를 결정합니다. 전달하지 않거나 값이 0이면 구현이 주어진 환경에 가장 적합한 버퍼 크기를 선택하며, 이 값은 노드의 수명 동안 일정한 2의 거듭제곱 값입니다. 그렇지 않고 작성자가 bufferSize를 명시적으로 지정하는 경우, 이는 반드시 다음 값 중 하나여야 합니다: 256, 512, 1024, 2048, 4096, 8192, 16384. 이 값은audioprocess이벤트가 얼마나 자주 디스패치되는지와 각 호출에서 처리해야 하는 샘플 프레임 수를 제어합니다.bufferSize값이 작으면 지연 시간이 더 낮아집니다(더 좋습니다). 값이 크면 오디오 끊김과 글리치를 방지하는 데 필요합니다. 작성자는 이 버퍼 크기를 지정하지 않고 구현이 지연 시간과 오디오 품질 사이의 균형을 맞출 수 있는 적절한 버퍼 크기를 선택하도록 하는 것이 권장됩니다. 이 매개변수의 값이 위에 나열된 허용되는 2의 거듭제곱 값 중 하나가 아니면IndexSizeError를 반드시 발생시켜야 합니다.numberOfInputChannelsunsigned long✘ ✔ 이 매개변수는 이 노드 입력의 채널 수를 결정합니다. 기본값은 2입니다. 최대 32개의 값까지 지원해야 합니다. 채널 수가 지원되지 않으면 NotSupportedError예외를 발생시켜야 합니다.numberOfOutputChannelsunsigned long✘ ✔ 이 매개변수는 이 노드 출력의 채널 수를 결정합니다. 기본값은 2입니다. 최대 32개의 값까지 지원해야 합니다. 채널 수가 지원되지 않으면 NotSupportedError예외를 발생시켜야 합니다.반환 유형:ScriptProcessorNode createStereoPanner()-
StereoPannerNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:StereoPannerNode createWaveShaper()-
비선형 왜곡을 나타내는
WaveShaperNode를 위한 팩토리 메서드입니다.매개변수 없음.반환 유형:WaveShaperNode decodeAudioData(audioData, successCallback, errorCallback)-
ArrayBuffer에 포함된 오디오 파일 데이터를 비동기적으로 디코딩합니다.ArrayBuffer는 예를 들어XMLHttpRequest의responseType을"arraybuffer"로 설정한 뒤response속성에서 로드할 수 있습니다. 오디오 파일 데이터는audio요소가 지원하는 모든 형식일 수 있습니다.decodeAudioData()에 전달되는 버퍼의 콘텐츠 유형은 [mimesniff]에 설명된 스니핑을 통해 결정됩니다.이 함수와 상호작용하는 주요 방법은 반환되는 프로미스 값을 사용하는 것이지만, 콜백 매개변수도 레거시 이유로 제공됩니다.
손상된 파일의 경우 구현이 작성자에게 경고하도록 권장합니다. 예외를 발생시키면 호환성을 깨는 변경이 되므로 예외를 발생시킬 수 없습니다.
참고: 압축된 오디오 데이터 바이트 스트림이 손상되었지만 그 외에는 디코딩을 계속할 수 있는 경우 구현은 예를 들어 개발자 도구를 통해 작성자에게 경고하는 것이 권장됩니다.decodeAudioData가 호출되면 제어 스레드에서 다음 단계를 반드시 수행해야 합니다:-
this의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면 "
InvalidStateError"DOMException으로 거부된 프로미스를 반환합니다. -
promise를 새 Promise로 둡니다.
-
audioData가 분리된 상태가 아니면 다음 단계를 실행합니다:-
promise를
[[pending promises]]에 추가합니다. -
audioDataArrayBuffer를 분리합니다. 이 작업에서 예외가 발생하면 4.1단계로 이동합니다. -
다른 스레드에서 수행할 디코딩 작업을 큐에 넣습니다.
-
-
그렇지 않으면 다음 오류 단계를 실행합니다:
-
error를
DataCloneError로 둡니다. -
promise를 error로 거부하고,
[[pending promises]]에서 제거합니다. -
errorCallback을 error와 함께 호출하도록 미디어 요소 태스크를 큐에 넣습니다.
-
-
promise를 반환합니다.
다른 스레드에서 수행할 디코딩 작업을 큐에 넣을 때, 다음 단계는 제어 스레드도 렌더링 스레드도 아닌 스레드에서 반드시 수행되어야 하며, 이를디코딩 스레드라고 합니다.참고: 여러
디코딩 스레드가 여러decodeAudioData호출을 처리하기 위해 병렬로 실행될 수 있습니다.-
can decode를 처음에 true로 설정된 불리언 플래그로 둡니다.
-
MIME 스니핑 § 6.2 오디오 또는 비디오 유형 패턴 일치를 사용하여
audioData의 MIME 유형을 확인하려고 시도합니다. 오디오 또는 비디오 유형 패턴 일치 알고리즘이undefined를 반환하면 can decode를 false로 설정합니다. -
can decode가 true이면 인코딩된
audioData를 선형 PCM으로 디코딩하려고 시도합니다. 실패하면 can decode를 false로 설정합니다.미디어 바이트 스트림에 여러 오디오 트랙이 포함되어 있으면 첫 번째 트랙만 선형 PCM으로 디코딩합니다.
참고: 디코딩 과정을 더 세밀하게 제어해야 하는 작성자는 [WEBCODECS]를 사용할 수 있습니다.
-
can decode가
false이면 다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:-
error를 이름이
EncodingError인DOMException으로 둡니다.-
promise를 error로 거부하고
[[pending promises]]에서 제거합니다.
-
-
errorCallback이 누락되지 않았다면errorCallback을 error와 함께 호출합니다.
-
-
그렇지 않으면:
-
디코딩된 선형 PCM 오디오 데이터를 나타내는 결과를 가져와, 해당 샘플 레이트가
audioData의 샘플 레이트와 다르면BaseAudioContext의 샘플 레이트로 리샘플링합니다. -
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
buffer를 최종 결과 (필요한 경우 샘플 레이트 변환을 수행한 후)를 포함하는
AudioBuffer로 둡니다. -
promise를 buffer로 이행합니다.
-
successCallback이 누락되지 않았다면successCallback을 buffer와 함께 호출합니다.
-
-
BaseAudioContext.decodeAudioData() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 audioDataArrayBuffer✘ ✘ 압축된 오디오 데이터를 포함하는 ArrayBuffer입니다. successCallbackDecodeSuccessCallback?✔ ✔ 디코딩이 완료되면 호출되는 콜백 함수입니다. 이 콜백의 유일한 인수는 디코딩된 PCM 오디오 데이터를 나타내는 AudioBuffer입니다. errorCallbackDecodeErrorCallback?✔ ✔ 오디오 파일 디코딩 중 오류가 발생하면 호출되는 콜백 함수입니다. 반환 유형:Promise<AudioBuffer> -
1.1.3.
콜백 DecodeSuccessCallback()
매개변수
decodedData, 유형은AudioBuffer-
디코딩된 오디오 데이터를 포함하는 AudioBuffer입니다.
1.1.4.
콜백 DecodeErrorCallback()
매개변수
error, 유형은DOMException-
디코딩 중 발생한 오류입니다.
1.1.5. 수명
일단 생성되면 AudioContext는
더 이상 재생할 사운드가 없거나 페이지가 사라질 때까지
사운드를 계속 재생합니다.
1.1.6. 인트로스펙션 또는 직렬화 프리미티브의 부재
Web Audio API는 오디오 소스 스케줄링에 대해 실행 후 잊기 방식을
사용합니다. 즉, 소스
노드는 AudioContext의
수명 동안 각 음표마다 생성되며,
그래프에서 명시적으로 제거되지 않습니다. 직렬화할 수 있는
안정적인 노드 집합이 없으므로 이는
직렬화 API와 호환되지 않습니다.
또한 인트로스펙션 API가 있으면 콘텐츠 스크립트가 가비지 컬렉션을 관찰할 수 있게 됩니다.
1.1.7.
BaseAudioContext
하위 클래스와 연관된 시스템 리소스
하위 클래스 AudioContext
및 OfflineAudioContext는
비용이 큰 객체로 간주해야 합니다. 이러한 객체를 생성하면
우선순위가 높은 스레드를 생성하거나 저지연
시스템 오디오 스트림을 사용할 수 있으며, 둘 다 에너지 소비에 영향을 줍니다.
일반적으로 문서에서 하나보다 많은
AudioContext를
생성할 필요는 없습니다.
BaseAudioContext
하위 클래스를 생성하거나 재개하는 것은
해당 컨텍스트를 위해 시스템
리소스를 획득하는 것을 포함합니다. AudioContext의
경우
시스템 오디오 스트림 생성도 필요합니다.
이러한 작업은 컨텍스트가 연결된 오디오 그래프에서
출력을 생성하기 시작하면 반환됩니다.
또한 사용자 에이전트는 구현에서 정의한
AudioContext의
최대 개수를 가질 수 있으며, 그 이후에는 새 AudioContext를
생성하려는 모든 시도가 실패하여 NotSupportedError가
발생합니다.
suspend
및 close를
사용하면 작성자가 스레드,
프로세스 및 오디오 스트림을 포함한 시스템
리소스를 해제할 수 있습니다. BaseAudioContext를
일시 중지하면 구현이 일부 리소스를 해제할 수 있으며,
나중에 resume을
호출하여 계속 작동할 수 있습니다.
AudioContext를
닫으면 구현이 모든
리소스를 해제할 수 있으며, 이후에는 다시 사용하거나 재개할 수 없습니다.
참고: 예를 들어 오디오 콜백이 정기적으로 발생할 때까지 기다리거나 하드웨어가 처리할 준비가 될 때까지 기다리는 것이 포함될 수 있습니다.
1.2.
AudioContext
인터페이스
이 인터페이스는 AudioDestinationNode가
사용자에게 향하는 신호를 생성하는 실시간
출력 장치로 라우팅되는 오디오 그래프를 나타냅니다. 대부분의
사용 사례에서는 문서마다 하나의 AudioContext만
사용합니다.
enum {AudioContextLatencyCategory "balanced" ,"interactive" ,"playback" };
| 열거형 값 | 설명 |
|---|---|
"balanced"
| 오디오 출력 지연 시간과 전력 소비의 균형을 맞춥니다. |
"interactive"
| 글리치가 발생하지 않는 범위에서 가능한 가장 낮은 오디오 출력 지연 시간을 제공합니다. 이것이 기본값입니다. |
"playback"
| 오디오 출력 지연 시간보다 중단 없는 지속적인 재생을 우선합니다. 전력 소비가 가장 낮습니다. |
enum {AudioSinkType "none" };
| 열거형 값 | 설명 |
|---|---|
"none"
| 오디오 그래프는 오디오 출력 장치를 통해 재생되지 않고 처리됩니다. |
[Exposed =Window ]interface AudioContext :BaseAudioContext {constructor (optional AudioContextOptions contextOptions = {});readonly attribute double baseLatency ;readonly attribute double outputLatency ; [SecureContext ]readonly attribute (DOMString or AudioSinkInfo )sinkId ;attribute EventHandler onsinkchange ;attribute EventHandler onerror ; [SameObject ]readonly attribute AudioPlaybackStats playbackStats ;AudioTimestamp getOutputTimestamp ();Promise <undefined >resume ();Promise <undefined >suspend ();Promise <undefined >close (); [SecureContext ]Promise <undefined >((setSinkId DOMString or AudioSinkOptions ));sinkId MediaElementAudioSourceNode createMediaElementSource (HTMLMediaElement );mediaElement MediaStreamAudioSourceNode createMediaStreamSource (MediaStream );mediaStream MediaStreamTrackAudioSourceNode createMediaStreamTrackSource (MediaStreamTrack );mediaStreamTrack MediaStreamAudioDestinationNode createMediaStreamDestination (); };
AudioContext는
사용자 에이전트가 컨텍스트 상태를 "suspended"에서
"running"으로
전환하도록 허용하는 경우 시작할 수 있는
상태라고 합니다.
사용자 에이전트는 이 초기 전환을 허용하지 않을 수 있으며,
AudioContext의
관련 전역 객체에
지속 활성화가 있을 때만 이를 허용할 수도 있습니다.
AudioContext에는
다음 내부 슬롯이 있습니다:
[[suspended by user]]-
컨텍스트가 사용자 코드에 의해 일시 중지되었는지를 나타내는 불리언 플래그입니다. 초기값은
false입니다. [[sink ID]]-
각각 현재 오디오 출력 장치의 식별자 또는 정보를 나타내는
DOMString또는AudioSinkInfo입니다. 초기값은""이며, 이는 기본 오디오 출력 장치를 의미합니다. [[sink ID at construction]]-
각각 생성 시 요청된 오디오 출력 장치의 식별자 또는 정보를 나타내는
DOMString또는AudioSinkInfo입니다. 초기값은""이며, 이는 기본 오디오 출력 장치를 의미합니다. [[pending resume promises]]-
resume()에서 생성된 대기 중인Promise를 저장하기 위한 순서가 있는 목록입니다. 처음에는 비어 있습니다. [[playback stats]]-
AudioPlaybackStats인스턴스가 저장되는 슬롯입니다.
1.2.1. 생성자
AudioContext(contextOptions)-
현재 설정 객체의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면 "
InvalidStateError"를 발생시키고 이 단계를 중단합니다.AudioContext를 생성할 때 다음 단계를 실행합니다:-
context를 새
AudioContext객체로 둡니다. -
context의
[[control thread state]]를suspended로 설정합니다. -
context의
[[rendering thread state]]를suspended로 설정합니다. -
context의
[[state before interruption]]를null로 설정합니다. -
messageChannel을 새
MessageChannel로 둡니다. -
controlSidePort를 messageChannel의
port1속성 값으로 둡니다. -
renderingSidePort를 messageChannel의
port2속성 값으로 둡니다. -
serializedRenderingSidePort를 StructuredSerializeWithTransfer(renderingSidePort, « renderingSidePort »)의 결과로 둡니다.
-
이
audioWorklet의port를 controlSidePort로 설정합니다. -
serializedRenderingSidePort와 함께 AudioContextGlobalScope에 MessagePort를 설정하도록 제어 메시지를 큐에 넣습니다.
-
contextOptions가 주어졌으면 다음 하위 단계를 수행합니다:-
sinkId가 지정되어 있으면 sinkId를contextOptions.의 값으로 두고 다음 하위 단계를 실행합니다:sinkId-
sinkId와
[[sink ID]]가 모두DOMString유형이고 서로 같으면 이 하위 단계를 중단합니다. -
sinkId가
AudioSinkOptions유형이고[[sink ID]]가AudioSinkInfo유형이며, sinkId의type과[[sink ID]]의type이 같으면 이 하위 단계를 중단합니다. -
sinkId가
DOMString유형이면[[sink ID at construction]]을 sinkId로 설정하고 이 하위 단계를 중단합니다. -
sinkId가
AudioSinkOptions유형이면[[sink ID at construction]]을 sinkId의type값으로 생성한 새AudioSinkInfo인스턴스로 설정합니다.
-
-
latencyHint에 설명된 대로contextOptions.에 따라 context의 내부 지연 시간을 설정합니다.latencyHint -
contextOptions.가 지정되어 있으면 context의sampleRatesampleRate를 이 값으로 설정합니다. 그렇지 않으면 다음 하위 단계를 따릅니다:-
sinkId가 빈 문자열이거나
AudioSinkOptions유형이면 기본 출력 장치의 샘플 레이트를 사용합니다. 이 하위 단계를 중단합니다. -
sinkId가
DOMString이면 sinkId로 식별되는 출력 장치의 샘플 레이트를 사용합니다. 이 하위 단계를 중단합니다.
contextOptions.가 출력 장치의 샘플 레이트와 다르면 사용자 에이전트는 오디오 출력을 출력 장치의 샘플 레이트와 일치하도록 반드시 리샘플링해야 합니다.sampleRate참고: 리샘플링이 필요한 경우 context의 지연 시간이 크게 영향을 받을 수도 있습니다.
-
-
context의
[[render quantum size]]를contextOptions.값에 따라 설정합니다:renderSizeHint-
기본값
"default"이면[[render quantum size]]비공개 슬롯을 128로 설정합니다. -
그렇지 않고 값이
"hardware"이면[[render quantum size]]비공개 슬롯을 0으로 설정합니다. -
그렇지 않고 정수가 전달되었으며 값이 § 2.5 지원되는 렌더 퀀텀 크기에 지정된 범위를 벗어나면
NotSupportedError를 반드시 발생시켜야 하며, 그렇지 않으면[[render quantum size]]비공개 슬롯을 전달된 값으로 설정합니다.
-
-
-
context가 시작할 수 있는 상태이면 처리를 시작하도록 제어 메시지를 보냅니다.
-
[[playback stats]]를 새AudioPlaybackStats인스턴스로 설정합니다. -
context를 반환합니다.
처리를 시작하도록 제어 메시지를 보낸다는 것은 다음 단계를 실행하는 것을 의미합니다:-
validationResult를
[[sink ID at construction]]의 싱크 식별자 유효성 검사 반환값으로 둡니다. -
validationResult가
false이면 다음 단계를 실행합니다:-
[[sink ID]]를 빈 문자열로 설정합니다. -
AudioContext에서error라는 이벤트를 발생시키도록 미디어 요소 태스크를 큐에 넣고, 다음 단계를 중단합니다.
-
-
렌더링에 사용할 다음 오디오 출력 장치를
[[sink ID at construction]]에 따라 사용하기 위해 시스템 리소스를 획득하려고 시도합니다:-
빈 문자열의 경우 기본 오디오 출력 장치입니다.
-
[[sink ID at construction]]으로 식별되는 오디오 출력 장치입니다.-
리소스 획득에 실패하면
AudioContext에서error라는 이벤트를 발생시키도록 미디어 요소 태스크를 큐에 넣고, 다음 단계를 중단합니다.
-
-
-
[[sink ID]]를[[sink ID at construction]]의 값으로 설정합니다. -
AudioContext에서 this의[[rendering thread state]]를running으로 설정합니다. -
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
AudioContext의[[render quantum size]]가 0이면 리소스 획득 중 선택된 실제 하드웨어 렌더 퀀텀 크기로 설정합니다. -
AudioContext의state속성을 "running"으로 설정합니다.
-
참고:
AudioContext가 인수 없이 생성되고 리소스 획득에 실패하는 경우 사용자 에이전트는 오디오 출력 장치를 에뮬레이션하는 메커니즘을 사용하여 오디오 그래프를 조용히 렌더링하려고 시도합니다.AudioWorkletGlobalScope에서MessagePort를 설정하도록 제어 메시지를 보낸다는 것은AudioWorkletGlobalScope로 전송된 serializedRenderingSidePort와 함께 렌더링 스레드에서 다음 단계를 실행하는 것을 의미합니다:-
deserializedPort를 StructuredDeserialize(serializedRenderingSidePort, 현재 Realm)의 결과로 둡니다.
-
port를 deserializedPort로 설정합니다.
AudioContext.constructor(contextOptions) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextOptionsAudioContextOptions✘ ✔ AudioContext를 어떻게 생성할지 제어하는 사용자 지정 옵션입니다. -
1.2.2. 속성
baseLatency, 유형은 double, 읽기 전용-
이는
AudioContext가 오디오를AudioDestinationNode에서 오디오 서브시스템으로 전달할 때 발생하는 처리 지연 시간을 초 단위로 나타냅니다.AudioDestinationNode의 출력과 오디오 하드웨어 사이에서 다른 처리로 인해 발생할 수 있는 추가 지연은 포함하지 않으며, 특히 오디오 그래프 자체에서 발생하는 지연은 포함하지 않습니다.예를 들어 오디오 컨텍스트가 기본 렌더 퀀텀 크기로 44.1 kHz에서 실행되고,
AudioDestinationNode가 내부적으로 더블 버퍼링을 구현하며 각 렌더 퀀텀마다 오디오를 처리하고 출력할 수 있다면, 처리 지연 시간은 약 \((2\cdot128)/44100 = 5.805 \mathrm{ ms}\)입니다. outputLatency, 유형은 double, 읽기 전용-
오디오 출력 지연 시간의 초 단위 추정값입니다. 즉, 사용자 에이전트가 호스트 시스템에 버퍼 재생을 요청한 시점과 버퍼의 첫 번째 샘플이 실제로 오디오 출력 장치에서 처리되는 시점 사이의 간격입니다. 스피커나 헤드폰처럼 음향 신호를 생성하는 장치의 경우 후자의 시점은 샘플의 소리가 생성되는 시점을 의미합니다.
outputLatency속성 값은 플랫폼과 연결된 오디오 출력 장치 하드웨어에 따라 달라집니다.outputLatency속성 값은 컨텍스트가 실행 중이거나 연결된 오디오 출력 장치가 변경되는 동안 바뀔 수 있습니다. 정확한 동기화가 필요할 때는 이 값을 자주 조회하는 것이 유용합니다. sinkId, 유형은(DOMString or AudioSinkInfo), 읽기 전용-
[[sink ID]]내부 슬롯의 값을 반환합니다. 이 속성은 업데이트 시 캐시되며, 캐시된 후에는 동일한 객체를 반환합니다. onsinkchange, 유형은 EventHandler-
setSinkId()를 위한 이벤트 핸들러입니다. 이 이벤트 핸들러의 이벤트 유형은sinkchange입니다. 이 이벤트는 출력 장치 변경이 완료되면 디스패치됩니다.참고: 이는
AudioContext생성 시 최초 장치 선택에 대해서는 디스패치되지 않습니다. 초기 출력 장치의 준비 상태를 확인하려면statechange이벤트를 사용할 수 있습니다. onerror, 유형은 EventHandler-
AudioContext에서 디스패치된Event를 위한 이벤트 핸들러입니다. 이 핸들러의 이벤트 유형은error이며, 사용자 에이전트는 다음과 같은 경우에 이 이벤트를 디스패치할 수 있습니다:-
선택된 오디오 장치를 초기화하고 활성화하는 데 실패한 경우.
-
AudioContext와 연결된 오디오 출력 장치가 컨텍스트가running상태인 동안 연결 해제된 경우. -
운영 체제가 오디오 장치 오작동을 보고한 경우.
-
playbackStats, 유형은 AudioPlaybackStats, 읽기 전용-
이
AudioContext를 위한AudioPlaybackStats인스턴스입니다.[[playback stats]]내부 슬롯의 값을 반환합니다.
1.2.3. 메서드
close()-
AudioContext를 닫아 사용 중인 시스템 리소스를 해제합니다. 이는AudioContext에서 생성된 모든 객체를 자동으로 해제하지는 않지만,AudioContext의currentTime진행을 일시 중지하고 오디오 데이터 처리를 중단합니다.close가 호출되면 다음 단계를 실행합니다:-
this의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면 "
InvalidStateError"DOMException으로 거부된 프로미스를 반환합니다. -
promise를 새 Promise로 둡니다.
-
AudioContext의[[control thread state]]플래그가closed이면 프로미스를InvalidStateError로 거부하고 이 단계를 중단한 다음 promise를 반환합니다. -
AudioContext의[[control thread state]]플래그를closed로 설정합니다. -
AudioContext를 닫도록 제어 메시지를 큐에 넣습니다. -
promise를 반환합니다.
AudioContext를 닫도록 제어 메시지를 실행한다는 것은 렌더링 스레드에서 다음 단계를 실행하는 것을 의미합니다:-
시스템 리소스를 해제하려고 시도합니다.
-
[[rendering thread state]]를suspended로 설정합니다.이렇게 하면 렌더링이 중단됩니다. -
이 제어 메시지가 문서가 언로드되는 것에 대한 반응으로 실행되는 경우 이 알고리즘을 중단합니다.
이 경우 제어 스레드에 알릴 필요가 없습니다. -
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
promise를 이행합니다.
-
AudioContext의state속성이 아직 "closed"가 아니면:-
AudioContext의state속성을 "closed"로 설정합니다. -
AudioContext에서statechange라는 이벤트를 발생시키도록 미디어 요소 태스크를 큐에 넣습니다.
-
-
AudioContext가 닫히면AudioContext에 연결되어 있던 모든MediaStream및HTMLMediaElement의 출력이 무시됩니다. 즉, 더 이상 스피커나 다른 출력 장치로 어떠한 출력도 발생시키지 않습니다. 동작을 더 유연하게 제어하려면HTMLMediaElement.captureStream()사용을 고려하십시오.참고:
AudioContext가 닫힌 경우 구현은 일시 중지할 때보다 더 많은 리소스를 적극적으로 해제하도록 선택할 수 있습니다.매개변수 없음. -
createMediaElementSource(mediaElement)-
HTMLMediaElement가 주어지면MediaElementAudioSourceNode를 생성합니다. 이 메서드를 호출하면 결과적으로HTMLMediaElement의 오디오 재생이AudioContext의 처리 그래프로 다시 라우팅됩니다.AudioContext.createMediaElementSource() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 mediaElementHTMLMediaElement✘ ✘ 다시 라우팅할 미디어 요소입니다. 반환 유형:MediaElementAudioSourceNode createMediaStreamDestination()-
MediaStreamAudioDestinationNode를 생성합니다.매개변수 없음. createMediaStreamSource(mediaStream)-
MediaStreamAudioSourceNode를 생성합니다.AudioContext.createMediaStreamSource() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 mediaStreamMediaStream✘ ✘ 소스로 작동할 미디어 스트림입니다. 반환 유형:MediaStreamAudioSourceNode createMediaStreamTrackSource(mediaStreamTrack)-
MediaStreamTrackAudioSourceNode를 생성합니다.AudioContext.createMediaStreamTrackSource() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 mediaStreamTrackMediaStreamTrack✘ ✘ 소스로 작동할 MediaStreamTrack입니다. 그kind속성 값은"audio"와 같아야 하며, 그렇지 않으면InvalidStateError예외를 반드시 발생시켜야 합니다. getOutputTimestamp()-
컨텍스트에 대해 서로 관련된 두 개의 오디오 스트림 위치 값을 포함하는 새
AudioTimestamp인스턴스를 반환합니다.contextTime멤버에는 오디오 출력 장치가 현재 렌더링하고 있는 샘플 프레임의 시간(즉, 출력 오디오 스트림 위치)이 컨텍스트의currentTime과 동일한 단위 및 원점을 사용하여 포함됩니다;performanceTime멤버에는 저장된contextTime값에 해당하는 샘플 프레임이 오디오 출력 장치에서 렌더링된 순간을 추정한 시간이performance.now()와 동일한 단위 및 원점을 사용하여 포함됩니다 ([hr-time-3]에 설명되어 있습니다).컨텍스트의 렌더링 그래프가 아직 오디오 블록을 처리하지 않았다면
getOutputTimestamp호출은 두 멤버 모두 0을 포함하는AudioTimestamp인스턴스를 반환합니다.컨텍스트의 렌더링 그래프가 오디오 블록 처리를 시작한 후에는
currentTime속성 값이 항상getOutputTimestamp메서드 호출에서 얻은contextTime값보다 큽니다.getOutputTimestamp메서드에서 반환된 값은 약간 더 늦은 컨텍스트의 시간 값에 대한 성능 시간 추정값을 얻는 데 사용할 수 있습니다:function outputPerformanceTime( contextTime) { const timestamp= context. getOutputTimestamp(); const elapsedTime= contextTime- timestamp. contextTime; return timestamp. performanceTime+ elapsedTime* 1000 ; } 위 예에서 추정의 정확도는 인수 값이 현재 출력 오디오 스트림 위치에 얼마나 가까운지에 따라 달라집니다. 주어진
contextTime이timestamp.contextTime에 가까울수록 얻은 추정값의 정확도가 높아집니다.참고: 컨텍스트의
currentTime값과getOutputTimestamp메서드 호출에서 얻은contextTime값의 차이는 신뢰할 수 있는 출력 지연 시간 추정값으로 간주할 수 없습니다.currentTime이 일정하지 않은 시간 간격으로 증가할 수 있기 때문입니다. 따라서 대신outputLatency속성을 사용해야 합니다.매개변수 없음.반환 유형:AudioTimestamp resume()-
AudioContext가 일시 중지되었을 때 그currentTime의 진행을 재개합니다.resume이 호출되면 다음 단계를 실행합니다:-
this의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면 "
InvalidStateError"DOMException으로 거부된 프로미스를 반환합니다. -
promise를 새 Promise로 둡니다.
-
AudioContext의[[control thread state]]가closed이면 프로미스를InvalidStateError로 거부하고 이 단계를 중단한 다음 promise를 반환합니다. -
[[suspended by user]]를false로 설정합니다. -
컨텍스트의
state속성이 "suspended"이고 컨텍스트의[[control thread state]]가 "interrupted"이면:-
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
AudioContext의state속성을 "interrupted"로 설정합니다. -
[[state before interruption]]슬롯을 "running"으로 설정합니다. -
AudioContext에서statechange라는 이벤트를 발생시키도록 미디어 요소 태스크를 큐에 넣습니다.
-
-
프로미스를
InvalidStateError로 거부하고 이 단계를 중단한 다음 promise를 반환합니다.
-
-
컨텍스트가 시작할 수 있는 상태가 아니면 promise를
[[pending promises]]및[[pending resume promises]]에 추가하고 이 단계를 중단한 다음 promise를 반환합니다. -
AudioContext의[[control thread state]]를running으로 설정합니다. -
promise와 함께
AudioContext를 재개하도록 제어 메시지를 큐에 넣습니다. -
promise를 반환합니다.
AudioContext를 재개하도록 제어 메시지를 실행한다는 것은 렌더링 스레드에서 다음 단계를 실행하는 것을 의미합니다:-
promise를 이 알고리즘에 전달된 프로미스로 둡니다.
-
시스템 리소스를 획득하려고 시도합니다.
-
AudioContext의[[rendering thread state]]를running으로 설정합니다. -
오디오 그래프 렌더링을 시작합니다.
-
실패한 경우 다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
[[pending resume promises]]의 모든 프로미스를 순서대로 거부한 다음[[pending resume promises]]를 비웁니다. -
또한 이러한 프로미스를
[[pending promises]]에서 제거합니다.
-
-
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
AudioContext의[[render quantum size]]가 0이면 리소스 획득 중 선택된 실제 하드웨어 렌더 퀀텀 크기로 설정합니다. -
[[pending resume promises]]의 모든 프로미스를 순서대로 이행합니다. -
[[pending resume promises]]를 비웁니다. 또한 이러한 프로미스를[[pending promises]]에서 제거합니다. -
promise를 이행합니다.
-
AudioContext의state속성이 아직 "running"이 아니면:-
AudioContext의state속성을 "running"으로 설정합니다. -
AudioContext에서statechange라는 이벤트를 발생시키도록 미디어 요소 태스크를 큐에 넣습니다.
-
-
매개변수 없음. -
suspend()-
AudioContext의currentTime진행을 일시 중지하고, 이미 처리된 현재 컨텍스트 처리 블록이 대상에서 재생되도록 한 다음 시스템이 오디오 하드웨어에 대한 점유를 해제할 수 있도록 합니다. 이는 일반적으로 애플리케이션이 한동안AudioContext가 필요하지 않을 것을 알고 있고,AudioContext와 연관된 시스템 리소스를 일시적으로 해제하려는 경우에 유용합니다. 프로미스는 프레임 버퍼가 비워지면(하드웨어에 전달되면) 이행되며, 컨텍스트가 이미suspended상태이면 즉시 (다른 효과 없이) 이행됩니다. 컨텍스트가 닫힌 경우 프로미스는 거부됩니다.suspend가 호출되면 다음 단계를 실행합니다:-
this의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면 "
InvalidStateError"DOMException으로 거부된 프로미스를 반환합니다. -
promise를 새 Promise로 둡니다.
-
AudioContext의[[control thread state]]가closed이면 프로미스를InvalidStateError로 거부하고 이 단계를 중단한 다음 promise를 반환합니다. -
promise를
[[pending promises]]에 추가합니다. -
[[suspended by user]]를true로 설정합니다. -
AudioContext의[[control thread state]]를suspended로 설정합니다. -
promise와 함께
AudioContext를 일시 중지하도록 제어 메시지를 큐에 넣습니다. -
promise를 반환합니다.
AudioContext를 일시 중지하도록 제어 메시지를 실행한다는 것은 렌더링 스레드에서 다음 단계를 실행하는 것을 의미합니다:-
promise를 이 알고리즘에 전달된 프로미스로 둡니다.
-
시스템 리소스를 해제하려고 시도합니다.
-
AudioContext의[[rendering thread state]]가 "interrupted"이면,[[state before interruption]]슬롯을 "suspended"로 설정하도록 미디어 요소 태스크를 큐에 넣습니다. -
AudioContext의[[rendering thread state]]를 "suspended"로 설정합니다. -
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
promise를 이행합니다.
-
AudioContext의state속성이 아직 "suspended"가 아니면:-
AudioContext의state속성을 "suspended"로 설정합니다. -
AudioContext에서statechange라는 이벤트를 발생시키도록 미디어 요소 태스크를 큐에 넣습니다.
-
-
AudioContext가 일시 중지되어 있는 동안MediaStream의 출력은 무시됩니다. 즉, 미디어 스트림의 실시간 특성으로 인해 데이터가 손실됩니다.HTMLMediaElement역시 시스템이 재개될 때까지 출력이 무시됩니다.AudioWorkletNode및ScriptProcessorNode는 일시 중지되어 있는 동안 처리 핸들러 호출이 중단되지만, 컨텍스트가 재개되면 다시 호출됩니다.AnalyserNode윈도 함수의 관점에서는 데이터가 연속적인 스트림으로 간주됩니다. 즉,resume()/suspend()으로 인해AnalyserNode의 데이터 스트림에 무음이 나타나지 않습니다. 특히AudioContext가 일시 중지되어 있을 때AnalyserNode함수를 반복해서 호출하면 반드시 동일한 데이터를 반환해야 합니다.매개변수 없음. -
setSinkId((DOMString or AudioSinkOptions) sinkId)-
출력 장치의 식별자를 설정합니다. 이 메서드가 호출되면 사용자 에이전트는 반드시 다음 단계를 실행해야 합니다:
-
sinkId를 메서드의 첫 번째 인수로 둡니다.
-
sinkId가
[[sink ID]]와 같으면 프로미스를 반환하고 즉시 이행한 다음 이 단계를 중단합니다. -
validationResult를 sinkId의 싱크 식별자 유효성 검사 반환값으로 둡니다.
-
validationResult가
false이면 이름이 "NotAllowedError"인 새DOMException으로 거부된 프로미스를 반환합니다. 이 단계를 중단합니다. -
p를 새 프로미스로 둡니다.
-
p 및 sinkId와 함께 처리를 시작하도록 제어 메시지를 보냅니다.
-
p를 반환합니다.
setSinkId()중 처리를 시작하도록 제어 메시지를 보낸다는 것은 다음 단계를 실행하는 것을 의미합니다:-
p를 이 알고리즘에 전달된 프로미스로 둡니다.
-
sinkId를 이 알고리즘에 전달된 싱크 식별자로 둡니다.
-
sinkId와
[[sink ID]]가 모두DOMString유형이고 서로 같으면 p를 이행하도록 미디어 요소 태스크를 큐에 넣고 이 단계를 중단합니다. -
sinkId가
AudioSinkOptions유형이고[[sink ID]]가AudioSinkInfo유형이며, sinkId의type과[[sink ID]]의type이 같으면 p를 이행하도록 미디어 요소 태스크를 큐에 넣고 이 단계를 중단합니다. -
wasRunning을 true로 둡니다.
-
AudioContext의[[rendering thread state]]가"suspended"이면 wasRunning을 false로 설정합니다. -
현재 렌더 퀀텀을 처리한 후 렌더러를 일시 중지합니다.
-
시스템 리소스를 해제하려고 시도합니다.
-
wasRunning이 true이면:
-
AudioContext의[[rendering thread state]]를"suspended"로 설정합니다. -
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
AudioContext의state속성이 아직 "suspended"가 아니면:-
AudioContext의state속성을 "suspended"로 설정합니다. -
연결된
AudioContext에서statechange라는 이벤트를 발생시킵니다.
-
-
-
-
렌더링에 사용할 다음 오디오 출력 장치를
[[sink ID]]에 따라 사용하기 위해 시스템 리소스를 획득하려고 시도합니다:-
빈 문자열의 경우 기본 오디오 출력 장치입니다.
-
[[sink ID]]로 식별되는 오디오 출력 장치입니다.
실패하면 p를 "
InvalidAccessError"로 거부하고 다음 단계를 중단합니다. -
-
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
sinkId가
DOMString유형이면[[sink ID]]를 sinkId로 설정합니다. 이 단계를 중단합니다. -
sinkId가
AudioSinkOptions유형이고[[sink ID]]가DOMString유형이면[[sink ID]]를 sinkId의type값으로 생성한 새AudioSinkInfo인스턴스로 설정합니다. -
sinkId가
AudioSinkOptions유형이고[[sink ID]]가AudioSinkInfo유형이면type의[[sink ID]]를 sinkId의type값으로 설정합니다. -
p를 이행합니다.
-
연결된
AudioContext에서sinkchange라는 이벤트를 발생시킵니다.
-
-
wasRunning이 true이면:
-
AudioContext의[[rendering thread state]]를"running"으로 설정합니다. -
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
AudioContext의state속성이 아직 "running"이 아니면:-
AudioContext의state속성을 "running"으로 설정합니다. -
연결된
AudioContext에서statechange라는 이벤트를 발생시킵니다.
-
-
-
-
1.2.4.
sinkId
유효성 검사
이 알고리즘은 sinkId를
수정하기 위해 제공된 정보의 유효성을 검사하는 데 사용됩니다:
-
document를 현재 설정 객체의 연결된 Document로 둡니다.
-
sinkIdArg를 이 알고리즘에 전달된 값으로 둡니다.
-
document가
"speaker-selection"으로 식별되는 기능을 사용하도록 허용되지 않았으면false를 반환합니다. -
sinkIdArg가
DOMString유형이지만 빈 문자열과 같지 않거나,enumerateDevices()가 제공할 결과로 식별되는 어떤 오디오 출력 장치와도 일치하지 않으면false를 반환합니다. -
true를 반환합니다.
1.2.5.
AudioContextOptions
AudioContextOptions
딕셔너리는 AudioContext에
대한 사용자 지정 옵션을 지정하는 데 사용됩니다.
dictionary AudioContextOptions { (AudioContextLatencyCategory or double )latencyHint = "interactive";float sampleRate ; (DOMString or AudioSinkOptions )sinkId ; (AudioContextRenderSizeCategory or unsigned long )renderSizeHint = "default"; };
1.2.5.1.
AudioContextOptions
딕셔너리 멤버
latencyHint, 유형은(AudioContextLatencyCategory or double), 기본값은"interactive"-
재생 유형을 식별하며, 이는 오디오 출력 지연 시간과 전력 소비 간의 절충에 영향을 줍니다.
latencyHint의 기본적으로 선호되는 값은AudioContextLatencyCategory의 값입니다. 그러나 지연 시간과 전력 소비의 균형을 더 세밀하게 제어하기 위해 지연 시간의 초 수를 나타내는 double을 지정할 수도 있습니다. 숫자를 적절하게 해석하는 것은 브라우저의 재량입니다. 실제로 사용되는 지연 시간은 AudioContext의baseLatency속성으로 제공됩니다. sampleRate, 유형은 float-
생성될
AudioContext의sampleRate를 이 값으로 설정합니다. 필수 지원 범위는 § 2.4 지원되는 샘플 레이트를 참조하십시오.sampleRate가 지정되지 않으면 이AudioContext에 대해 출력 장치가 선호하는 샘플 레이트를 사용합니다. sinkId, 유형은(DOMString or AudioSinkOptions)-
오디오 출력 장치의 식별자 또는 연관된 정보입니다. 자세한 내용은
sinkId를 참조하십시오. renderSizeHint, 유형은(AudioContextRenderSizeCategory or unsigned long), 기본값은"default"-
정수가 전달되면 특정 렌더 퀀텀 크기를 요청할 수 있고, 아무것도 전달하지 않거나
"default"를 전달하면 기본값인 128프레임을 사용하며,"hardware"가 지정되면 사용자 에이전트가 적절한 렌더 퀀텀 크기를 선택하도록 요청할 수 있습니다.필수 지원 범위는 § 2.5 지원되는 렌더 퀀텀 크기를 참조하십시오.
이는 반드시 반영된다고 보장되지 않는 힌트입니다.
1.2.6.
AudioSinkOptions
AudioSinkOptions
딕셔너리는 sinkId의
옵션을 지정하는 데 사용됩니다.
dictionary AudioSinkOptions {required AudioSinkType type ; };
1.2.6.1.
AudioSinkOptions
딕셔너리 멤버
type, 유형은 AudioSinkType-
장치 유형을 지정하는
AudioSinkType값입니다.
1.2.7.
AudioSinkInfo
AudioSinkInfo
인터페이스는 sinkId를
통해 현재 오디오 출력 장치에 관한 정보를 가져오는 데 사용됩니다.
[Exposed =Window ]interface AudioSinkInfo {readonly attribute AudioSinkType type ; };
1.2.7.1. 속성
type, 유형은 AudioSinkType, 읽기 전용-
장치 유형을 나타내는
AudioSinkType값입니다.
1.2.8.
AudioTimestamp
dictionary AudioTimestamp {double contextTime ;DOMHighResTimeStamp performanceTime ; };
1.2.8.1.
AudioTimestamp
딕셔너리 멤버
contextTime, 유형은 double-
BaseAudioContext의
currentTime시간 좌표계의 한 지점을 나타냅니다. performanceTime, 유형은 DOMHighResTimeStamp-
Performance인터페이스 구현의 시간 좌표계에서 한 지점을 나타냅니다 ([hr-time-3]에 설명되어 있습니다).
1.3.
OfflineAudioContext
인터페이스
OfflineAudioContext는
실시간보다 (잠재적으로) 빠르게 렌더링/믹스다운하기 위한 특수한 유형의
BaseAudioContext입니다.
오디오 하드웨어로 렌더링하지 않고 가능한 한 빠르게 렌더링하며, 반환된
프로미스를 렌더링 결과인
AudioBuffer로
이행합니다.
[Exposed =Window ]interface OfflineAudioContext :BaseAudioContext {constructor (OfflineAudioContextOptions contextOptions );constructor (unsigned long numberOfChannels ,unsigned long length ,float sampleRate );Promise <AudioBuffer >startRendering (optional unsigned long ?chunkSize =null );Promise <undefined >resume ();Promise <undefined >suspend (double );suspendTime Promise <undefined >close ();readonly attribute unsigned long ?length ;attribute EventHandler oncomplete ; };
OfflineAudioContext에는
다음 내부 슬롯이 있습니다:
[[rendering started]]-
렌더링이 시작되었는지를 나타내는 불리언 플래그입니다. 초기값은
false입니다. [[rendered buffers]]-
렌더링 중인
AudioBuffer의 순서가 있는 목록입니다. 초기값은 빈 목록입니다. [[committed frames]]-
OfflineAudioContext가 렌더링하도록 커밋한 프레임 수를 추적합니다. 초기값은0입니다. [[rendered frames]]-
렌더링된 프레임 수를 추적합니다. 초기값은
0입니다.
1.3.1. 생성자
OfflineAudioContext(contextOptions)-
현재 설정 객체의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면,
c를 새InvalidStateError를 발생시키고 이 단계를 중단합니다.OfflineAudioContext객체로 둡니다. c를 다음과 같이 초기화합니다:-
c의
[[control thread state]]를"suspended"로 설정합니다. -
c의
[[rendering thread state]]를"suspended"로 설정합니다. -
contextOptions.의 값을 바탕으로 c의sampleRatesampleRate를 설정합니다. -
contextOptions.의 값을 바탕으로 c의renderSizeHint[[render quantum size]]를 결정합니다:-
기본값
"default"또는"hardware이면[[render quantum size]]비공개 슬롯을 128로 설정합니다. -
그렇지 않고 정수가 전달되었다면 값이 § 2.5 지원되는 렌더 퀀텀 크기에 지정된 범위를 벗어난 경우
NotSupportedError를 반드시 발생시켜야 하며, 그렇지 않으면[[render quantum size]]비공개 슬롯을 전달된 값으로 설정합니다.
-
-
channelCount가contextOptions.numberOfChannels로 설정된AudioDestinationNode를 생성합니다. -
messageChannel을 새
MessageChannel로 둡니다. -
controlSidePort를 messageChannel의
port1속성 값으로 둡니다. -
renderingSidePort를 messageChannel의
port2속성 값으로 둡니다. -
serializedRenderingSidePort를 StructuredSerializeWithTransfer(renderingSidePort, « renderingSidePort »)의 결과로 둡니다.
-
이
audioWorklet의port를 controlSidePort로 설정합니다. -
serializedRenderingSidePort와 함께 AudioContextGlobalScope에 MessagePort를 설정하도록 제어 메시지를 큐에 넣습니다.
OfflineAudioContext.constructor(contextOptions) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextOptions이 컨텍스트를 생성하는 데 필요한 초기 매개변수입니다. -
OfflineAudioContext(numberOfChannels, length, sampleRate)-
OfflineAudioContext는 AudioContext.createBuffer와 동일한 인수로 생성할 수 있습니다. 인수 중 하나라도 음수, 0 또는 명목 범위를 벗어나면NotSupportedError예외를 반드시 발생시켜야 합니다.OfflineAudioContext는 다음을
new OfflineAudioContext({ numberOfChannels: numberOfChannels, length: length, sampleRate: sampleRate}) 대신 호출한 것처럼 생성됩니다.
OfflineAudioContext.constructor(numberOfChannels, length, sampleRate) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 numberOfChannelsunsigned long✘ ✘ 버퍼가 가질 채널 수를 결정합니다. 지원되는 채널 수는 createBuffer()를 참조하십시오.lengthunsigned long✘ ✘ 오디오 렌더링의 전체 크기를 샘플 프레임 단위로 결정합니다. sampleRatefloat✘ ✘ 버퍼의 선형 PCM 오디오 데이터의 샘플 레이트를 초당 샘플 프레임 수로 설명합니다. 필수 지원 범위는 § 2.4 지원되는 샘플 레이트를 참조하십시오.
1.3.2. 속성
length, 유형은 unsigned long, 읽기 전용, 널 허용-
오디오 렌더링의 전체 크기를 샘플 프레임 단위로 나타냅니다. 이는 생성자의
length매개변수 값과 같습니다.길이가 정의되지 않은 렌더링의 경우 이 속성을
null로 설정하는 것이 좋습니다. oncomplete, 유형은 EventHandler-
이 이벤트 핸들러의 이벤트 유형은
complete입니다. 이벤트 핸들러로 디스패치되는 이벤트는OfflineAudioCompletionEvent인터페이스를 사용합니다. 이는OfflineAudioContext에서 마지막으로 발생하는 이벤트입니다.
1.3.3. 메서드
startRendering(chunkSize)-
현재 연결 및 예약된 변경 사항을 바탕으로 오디오 렌더링을 시작합니다.
렌더링된 오디오 데이터를 얻는 주요 방법은 반환되는 프로미스 값이지만, 레거시 이유로 인스턴스에서
complete라는 이벤트도 발생합니다.startRendering이 호출되면 다음 단계를 제어 스레드에서 반드시 수행해야 합니다:- this의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면 "
InvalidStateError"DOMException으로 거부된 프로미스를 반환합니다. - promise를 새 프로미스로 둡니다.
-
OfflineAudioContext의[[control thread state]]가closed이면 promise를InvalidStateError로 거부하고 이 단계를 중단합니다. -
OfflineAudioContext의length가null이 아니고[[committed frames]]가OfflineAudioContext의length보다 크거나 같으면 promise를InvalidStateError로 거부하고 이 단계를 중단합니다. -
bufferLength를
chunkSize의 값으로 초기화된 숫자로 둡니다.-
OfflineAudioContext의length가null이면: -
그렇지 않고
OfflineAudioContext의length가null이 아니면:-
chunkSize가null이 아니고[[committed frames]]+chunkSize가OfflineAudioContext의length보다 작으면 bufferLength를chunkSize로 설정합니다. - 그렇지 않으면 bufferLength를
length-[[committed frames]]로 설정합니다.
-
-
- bufferLength가 렌더 퀀텀 크기의 배수가 아니면 다음 렌더 퀀텀 크기의 배수로 올림합니다.
- 채널 수와 샘플 레이트가 각각 이 인스턴스의
생성자에
contextOptions매개변수로 전달된numberOfChannels및sampleRate값과 같고, 길이가 bufferLength와 같은 새AudioBufferbuffer를 생성합니다. - 앞의
AudioBuffer생성자 호출 중 예외가 발생하면 promise를 해당 예외로 거부하고 promise를 반환합니다. [[rendering started]]를 true로 설정합니다.[[committed frames]]를[[committed frames]]와 buffer의length의 합으로 설정합니다.- buffer를
[[rendered buffers]]에 추가하고 buffer에 대한 오프라인 렌더링을 시작합니다. - promise를
[[pending promises]]에 추가합니다. - promise를 반환합니다.
AudioBufferbuffer에 대해 오프라인 렌더링을 시작하려면 다음 단계를 해당 작업을 위해 생성된 렌더링 스레드에서 반드시 수행해야 합니다.- 현재 연결 및 예약된 변경 사항을 바탕으로
buffer의
length샘플 프레임의 오디오를 buffer에 렌더링하기 시작합니다. - 각 렌더
퀀텀마다 확인하고 필요한 경우
렌더링을
suspend합니다. - 일시 중지된 컨텍스트가 재개되면 버퍼 렌더링을 계속합니다.
-
렌더링이 완료되면
다음 단계를 실행하도록
미디어 요소 태스크를 큐에 넣습니다:
startRendering()에서 생성된 promise를 buffer로 이행합니다.[[pending promises]]에서 promise를 제거합니다.[[rendered buffers]]에서 buffer를 제거합니다.[[rendered frames]]를[[rendered frames]]와 buffer의length의 합으로 설정합니다.-
length가null이 아니면:-
[[rendered frames]]가length보다 크거나 같으면OfflineAudioContext를 닫도록 제어 메시지를 큐에 넣습니다. -
OfflineAudioCompletionEvent를 사용하고 그renderedBuffer속성이 buffer로 설정된OfflineAudioContext에서complete라는 이벤트를 발생시키도록 미디어 요소 태스크를 큐에 넣습니다.
-
OfflineAudioContext.startRendering(chunkSize) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 chunkSizeunsigned long?✔ ✔ 이 호출 중 렌더링할 샘플 프레임 수입니다. 반환 유형:Promise<AudioBuffer> - this의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면 "
resume()-
OfflineAudioContext가 일시 중지되었을 때 그currentTime의 진행을 재개합니다.resume이 호출되면, 다음 단계를 실행합니다:-
this의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면 "
InvalidStateError"DOMException으로 거부된 프로미스를 반환합니다. -
promise를 새 Promise로 둡니다.
-
다음 조건 중 하나라도 참이면 이 단계를 중단하고 promise를
InvalidStateError로 거부합니다:-
OfflineAudioContext의[[control thread state]]가closed입니다. -
OfflineAudioContext의[[rendering started]]슬롯이 false입니다.
-
-
OfflineAudioContext의[[control thread state]]플래그를running으로 설정합니다. -
OfflineAudioContext를 재개하도록 제어 메시지를 큐에 넣습니다. -
promise를 반환합니다.
OfflineAudioContext를 재개하도록 제어 메시지를 실행한다는 것은 렌더링 스레드에서 다음 단계를 실행하는 것을 의미합니다:-
OfflineAudioContext의[[rendering thread state]]를running으로 설정합니다. -
오디오 그래프 렌더링을 시작합니다.
-
실패한 경우 promise를 거부하고 나머지 단계를 중단하도록 미디어 요소 태스크를 큐에 넣습니다.
-
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
promise를 이행합니다.
-
OfflineAudioContext의state속성이 아직 "running"이 아니면:-
OfflineAudioContext의state속성을 "running"으로 설정합니다. -
OfflineAudioContext에서statechange라는 이벤트를 발생시키도록 미디어 요소 태스크를 큐에 넣습니다.
-
-
매개변수 없음. -
suspend(suspendTime)-
지정된 시간에 오디오 컨텍스트의 시간 진행을 일시 중지하도록 예약하고 프로미스를 반환합니다. 이는 일반적으로
OfflineAudioContext에서 오디오 그래프를 동기적으로 조작할 때 유용합니다.일시 중지의 최대 정밀도는 렌더 퀀텀의 크기이며 지정된 일시 중지 시간은 가장 가까운 렌더 퀀텀 경계로 올림됩니다. 따라서 동일한 양자화된 프레임에 여러 일시 중지를 예약할 수 없습니다. 또한 정확한 일시 중지를 보장하려면 컨텍스트가 실행 중이지 않을 때 예약해야 합니다.
OfflineAudioContext.suspend() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 suspendTimedouble✘ ✘ 지정된 시간에 렌더링을 일시 중지하도록 예약하며, 이 시간은 양자화되어 렌더 퀀텀 크기로 올림됩니다. 양자화된 프레임 번호가 - 음수이거나
- 현재 시간보다 작거나 같거나
- 전체 렌더링 지속 시간보다 크거나 같거나
- 같은 시간에 다른 suspend에 의해 예약되어 있으면,
InvalidStateError로 거부됩니다. close()-
OfflineAudioContext를 닫습니다. 이는AudioContext에서 생성된 모든 객체를 자동으로 해제하지는 않지만,AudioContext의currentTime의 진행을 일시 중지하고 오디오 데이터 처리를 중단합니다.close가 호출되면 다음 단계를 실행합니다:-
this의 관련 전역 객체의 연결된 Document가 완전히 활성 상태가 아니면 "
InvalidStateError"DOMException으로 거부된 프로미스를 반환합니다. -
promise를 새 Promise로 둡니다.
-
OfflineAudioContext의[[control thread state]]플래그가closed이면 프로미스를InvalidStateError로 거부하고 이 단계를 중단한 다음 promise를 반환합니다. -
OfflineAudioContext의[[control thread state]]플래그를closed로 설정합니다. -
promise를 반환합니다.
OfflineAudioContext를 닫도록 제어 메시지를 실행한다는 것은 렌더링 스레드에서 다음 단계를 실행하는 것을 의미합니다:-
[[rendering thread state]]를suspended로 설정합니다.이렇게 하면 렌더링이 중단됩니다. -
이 제어 메시지가 문서가 언로드되는 것에 대한 반응으로 실행되는 경우 이 알고리즘을 중단합니다.
이 경우 제어 스레드에 알릴 필요가 없습니다. -
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
promise를 이행합니다.
-
OfflineAudioContext의state속성이 아직 "closed"가 아니면:-
OfflineAudioContext의state속성을 "closed"로 설정합니다.
-
-
-
1.3.4.
OfflineAudioContextOptions
이는 OfflineAudioContext를
생성할 때 사용할 옵션을 지정합니다.
dictionary OfflineAudioContextOptions {unsigned long numberOfChannels = 1;unsigned long ?length =null ;required float sampleRate ; (AudioContextRenderSizeCategory or unsigned long )renderSizeHint = "default"; };
1.3.4.1.
OfflineAudioContextOptions
딕셔너리 멤버
length, 유형은 unsigned long, 널 허용, 기본값은null-
렌더링된
AudioBuffer의 길이를 샘플 프레임 단위로 나타냅니다. numberOfChannels, 유형은 unsigned long, 기본값은1-
이
OfflineAudioContext의 채널 수입니다. sampleRate, 유형은 float-
이
OfflineAudioContext의 샘플 레이트입니다. 필수 지원 범위는 § 2.4 지원되는 샘플 레이트를 참조하십시오. renderSizeHint, 유형은(AudioContextRenderSizeCategory or unsigned long), 기본값은"default"-
이
OfflineAudioContext의 렌더 퀀텀 크기에 대한 힌트입니다. 필수 지원 범위는 § 2.5 지원되는 렌더 퀀텀 크기를 참조하십시오.
1.3.5.
OfflineAudioCompletionEvent
인터페이스
이는 레거시 이유로
OfflineAudioContext에
디스패치되는 Event
객체입니다.
[Exposed =Window ]interface OfflineAudioCompletionEvent :Event {(constructor DOMString ,type OfflineAudioCompletionEventInit );eventInitDict readonly attribute AudioBuffer renderedBuffer ; };
1.3.5.1. 속성
renderedBuffer, 유형은 AudioBuffer, 읽기 전용-
렌더링된 오디오 데이터를 포함하는
AudioBuffer입니다.
1.3.5.2.
OfflineAudioCompletionEventInit
dictionary OfflineAudioCompletionEventInit :EventInit {required AudioBuffer renderedBuffer ; };
1.3.5.2.1.
OfflineAudioCompletionEventInit
딕셔너리 멤버
renderedBuffer, 유형은 AudioBuffer-
이벤트의
renderedBuffer속성에 할당할 값입니다.
1.4.
AudioBuffer
인터페이스
이 인터페이스는 메모리에 상주하는 오디오 자산을 나타냅니다. 하나 이상의
채널을 포함할 수 있으며 각 채널은 명목 범위가 \([-1,1]\)인 32비트 부동소수점
선형 PCM 값으로 보이지만,
값은 이 범위로 제한되지 않습니다. 일반적으로
PCM 데이터의 길이는 비교적 짧을 것으로 예상됩니다
(보통 1분보다 다소 짧습니다).
음악 사운드트랙과 같이 더 긴 사운드에는
audio
요소와
MediaElementAudioSourceNode를
사용한 스트리밍을 사용해야 합니다.
AudioBuffer는
하나 이상의
AudioContext에서
사용할 수 있으며,
OfflineAudioContext와
AudioContext
사이에서 공유할 수 있습니다.
AudioBuffer에는
네 개의 내부 슬롯이 있습니다:
[[number of channels]]-
이
AudioBuffer의 오디오 채널 수이며, unsigned long입니다. [[length]]-
이
AudioBuffer의 각 채널 길이이며, unsigned long입니다. [[sample rate]]-
이
AudioBuffer의 샘플 레이트(Hz)이며, float입니다. [[internal data]]-
오디오 샘플 데이터를 보관하는 데이터 블록입니다.
[Exposed =Window ]interface AudioBuffer {constructor (AudioBufferOptions );options readonly attribute float sampleRate ;readonly attribute unsigned long length ;readonly attribute double duration ;readonly attribute unsigned long numberOfChannels ;Float32Array getChannelData (unsigned long );channel undefined copyFromChannel (Float32Array ,destination unsigned long ,channelNumber optional unsigned long = 0);bufferOffset undefined copyToChannel (Float32Array ,source unsigned long ,channelNumber optional unsigned long = 0); };bufferOffset
1.4.1. 생성자
AudioBuffer(options)-
-
options의 값 중 하나라도 명목 범위를 벗어나면NotSupportedError예외를 발생시키고 다음 단계를 중단합니다. -
b를 새
AudioBuffer객체로 둡니다. -
생성자에 전달된
AudioBufferOptions의numberOfChannels,length,sampleRate속성 값을 각각 내부 슬롯[[number of channels]],[[length]],[[sample rate]]에 할당합니다. -
이
AudioBuffer의 내부 슬롯[[internal data]]를CreateByteDataBlock(호출 결과로 설정합니다.[[length]]*[[number of channels]])참고: 이는 기본 저장소를 0으로 초기화합니다.
-
b를 반환합니다.
AudioBuffer.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 optionsAudioBufferOptions✘ ✘ 이 AudioBuffer의 속성을 결정하는AudioBufferOptions입니다. -
1.4.2. 속성
duration, 유형은 double, 읽기 전용-
PCM 오디오 데이터의 지속 시간(초)입니다.
이는
AudioBuffer의[[length]]를[[sample rate]]로 나누어[[sample rate]]와[[length]]로부터 계산합니다. length, 유형은 unsigned long, 읽기 전용-
PCM 오디오 데이터의 길이를 샘플 프레임 단위로 나타냅니다. 이는 반드시
[[length]]값을 반환해야 합니다. numberOfChannels, 유형은 unsigned long, 읽기 전용-
개별 오디오 채널의 수입니다. 이는 반드시
[[number of channels]]값을 반환해야 합니다. sampleRate, 유형은 float, 읽기 전용-
PCM 오디오 데이터의 초당 샘플 수로 나타낸 샘플 레이트입니다. 이는 반드시
[[sample rate]]값을 반환해야 합니다.
1.4.3. 메서드
copyFromChannel(destination, channelNumber, bufferOffset)-
copyFromChannel()메서드는AudioBuffer의 지정된 채널에서 샘플을destination배열로 복사합니다.buffer를 \(N_b\) 프레임을 가진AudioBuffer로 두고, \(N_f\)를destination배열의 요소 수로, \(k\)를bufferOffset의 값으로 둡니다. 그러면buffer에서destination으로 복사되는 프레임 수는 \(\max(0, \min(N_b - k, N_f))\)입니다. 이 값이 \(N_f\)보다 작으면destination의 나머지 요소는 수정되지 않습니다.AudioBuffer.copyFromChannel() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 destinationFloat32Array✘ ✘ 채널 데이터를 복사할 대상 배열입니다. channelNumberunsigned long✘ ✘ 데이터를 복사할 원본 채널의 인덱스입니다. channelNumber가AudioBuffer의 채널 수보다 크거나 같으면IndexSizeError예외를 반드시 발생시켜야 합니다.bufferOffsetunsigned long✘ ✔ 선택적 오프셋이며 기본값은 0입니다. AudioBuffer의 이 오프셋부터 시작하는 데이터가destination으로 복사됩니다.반환 유형:undefined copyToChannel(source, channelNumber, bufferOffset)-
copyToChannel()메서드는source배열의 샘플을AudioBuffer의 지정된 채널로 복사합니다.source를 버퍼로 복사할 수 없는 경우UnknownError가 발생할 수 있습니다.buffer를 \(N_b\) 프레임을 가진AudioBuffer로 두고, \(N_f\)를source배열의 요소 수로, \(k\)를bufferOffset의 값으로 둡니다. 그러면source에서buffer로 복사되는 프레임 수는 \(\max(0, \min(N_b - k, N_f))\)입니다. 이 값이 \(N_f\)보다 작으면buffer의 나머지 요소는 수정되지 않습니다.AudioBuffer.copyToChannel() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 sourceFloat32Array✘ ✘ 채널 데이터를 복사할 원본 배열입니다. channelNumberunsigned long✘ ✘ 데이터를 복사할 대상 채널의 인덱스입니다. channelNumber가AudioBuffer의 채널 수보다 크거나 같으면IndexSizeError예외를 반드시 발생시켜야 합니다.bufferOffsetunsigned long✘ ✔ 선택적 오프셋이며 기본값은 0입니다. source의 데이터가 이 오프셋부터 시작하여AudioBuffer로 복사됩니다.반환 유형:undefined getChannelData(channel)-
콘텐츠 획득에 설명된 규칙에 따라
[[internal data]]에 저장된 바이트에 쓰기를 허용하거나 새Float32Array에서 바이트의 복사본을 가져올 수 있도록 합니다.[[internal data]]또는 새Float32Array를 생성할 수 없는 경우UnknownError가 발생할 수 있습니다.AudioBuffer.getChannelData() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 channelunsigned long✘ ✘ 이 매개변수는 데이터를 가져올 특정 채널을 나타내는 인덱스입니다. 인덱스 값 0은 첫 번째 채널을 나타냅니다. 이 인덱스 값은 반드시 [[number of channels]]보다 작아야 하며, 그렇지 않으면IndexSizeError예외를 반드시 발생시켜야 합니다.반환 유형:Float32Array
참고: copyToChannel()
및
copyFromChannel()
메서드는 더 큰 배열을 바라보는 Float32Array
뷰를 전달하여 배열의 일부를 채우는 데 사용할 수 있습니다.
AudioBuffer의
채널에서 데이터를 읽고 데이터를 청크 단위로 처리할 수 있는 경우,
불필요한 메모리 할당 및 복사를 피할 수 있으므로
getChannelData()를
호출하여 결과 배열에 접근하는 것보다 copyFromChannel()을
사용하는 것이 좋습니다.
일부 API 구현에서 AudioBuffer의
콘텐츠가 필요할 때 내부 작업인 AudioBuffer의
콘텐츠 획득이 호출됩니다. 이 작업은 호출자에게
변경할 수 없는 채널 데이터를 반환합니다.
AudioBuffer에서
콘텐츠 획득
작업이 발생하면 다음 단계를 실행합니다:
-
AudioBuffer의ArrayBuffer중 하나라도 분리된 상태이면true를 반환하고 이 단계를 중단한 다음, 호출자에게 길이가 0인 채널 데이터 버퍼를 반환합니다. -
이
AudioBuffer에서getChannelData()가 이전에 반환한 배열의 모든ArrayBuffer를 분리합니다.참고:
AudioBuffer는createBuffer()또는AudioBuffer생성자를 통해서만 생성할 수 있으므로 이는 예외를 발생시킬 수 없습니다. -
이러한
ArrayBuffer의 기본[[internal data]]를 유지하고 이에 대한 참조를 호출자에게 반환합니다. -
데이터 복사본을 포함하는
ArrayBuffer를AudioBuffer에 연결하여 다음getChannelData()호출에서 반환되도록 합니다.
AudioBuffer의 콘텐츠 획득 작업은 다음 경우에 호출됩니다:
-
AudioBufferSourceNode.start가 호출되면 노드의buffer의 콘텐츠를 획득합니다. 작업에 실패하면 아무것도 재생되지 않습니다. -
AudioBufferSourceNode의buffer가 설정되고AudioBufferSourceNode.start가 이전에 호출된 경우, setter는AudioBuffer의 콘텐츠를 획득합니다. 작업에 실패하면 아무것도 재생되지 않습니다. -
ConvolverNode의buffer가AudioBuffer로 설정되면AudioBuffer의 콘텐츠를 획득합니다. -
AudioProcessingEvent의 디스패치가 완료되면 그outputBuffer의 콘텐츠를 획득합니다.
참고: 이는 copyToChannel()을
사용하여 현재 AudioBuffer의
콘텐츠를 획득한
AudioNode가
사용 중인 AudioBuffer의
콘텐츠를 변경할 수 없다는 의미입니다. 해당 AudioNode는
이전에 획득한 데이터를 계속 사용하기 때문입니다.
1.4.4.
AudioBufferOptions
이는 AudioBuffer를
생성할 때 사용할 옵션을 지정합니다.
length
및 sampleRate
멤버는 필수입니다.
dictionary AudioBufferOptions {unsigned long numberOfChannels = 1;required unsigned long length ;required float sampleRate ; };
1.4.4.1.
AudioBufferOptions
딕셔너리 멤버
이 딕셔너리 멤버에 허용되는 값에는 제약이 있습니다. createBuffer()를
참조하십시오.
length, 유형은 unsigned long-
버퍼의 샘플 프레임 단위 길이입니다. 제약 조건은
length를 참조하십시오. numberOfChannels, 유형은 unsigned long, 기본값은1-
버퍼의 채널 수입니다. 제약 조건은
numberOfChannels를 참조하십시오. sampleRate, 유형은 float-
버퍼의 샘플 레이트(Hz)입니다. 필수 지원 범위는 § 2.4 지원되는 샘플 레이트를 참조하십시오.
1.5.
AudioNode
인터페이스
AudioNode는
AudioContext의
구성 요소입니다. 이 인터페이스는
오디오 소스, 오디오 대상 및 중간 처리 모듈을 나타냅니다.
이러한 모듈은 서로 연결하여 오디오 하드웨어로 오디오를 렌더링하는
처리 그래프를 구성할 수 있습니다.
각 노드에는 입력 및/또는
출력이 있을 수 있습니다. 소스 노드에는 입력이 없고
출력이 하나 있습니다. 필터와 같은 대부분의 처리 노드는 입력 하나와
출력 하나를 가집니다. 각 유형의 AudioNode는
오디오를 처리하거나 합성하는 세부 방식이 서로 다릅니다. 그러나 일반적으로
AudioNode는
입력이 있으면 입력을 처리하고 출력이 있으면 출력용 오디오를 생성합니다.
각 출력에는 하나 이상의 채널이 있습니다. 정확한 채널 수는
특정 AudioNode의 세부
사항에
따라 달라집니다.
출력은 하나 이상의 AudioNode
입력에 연결될 수 있으므로 팬아웃이 지원됩니다. 입력에는 처음에
연결이 없지만 하나 이상의 AudioNode
출력에서 연결될 수 있으므로 팬인이 지원됩니다.
connect() 메서드를 호출하여 AudioNode의
출력을 AudioNode의
입력에 연결하면 이를 해당 입력에 대한
연결이라고 합니다.
각 AudioNode
입력은 특정 시점에
특정 수의 채널을 가집니다. 이 수는 입력에 만들어진
연결에 따라 달라질 수 있습니다.
입력에 연결이 없으면 무음인 하나의 채널을 가집니다.
각 입력에 대해 AudioNode는
해당 입력에 대한 모든 연결을 믹싱합니다.
규범적 요구 사항 및 자세한 내용은
§ 4 채널 업 믹싱 및 다운 믹싱을 참조하십시오.
AudioNode의
입력 처리 및 내부 작업은 노드에 연결된 출력이 있는지,
그리고 이러한 출력이 궁극적으로 AudioContext의
AudioDestinationNode에
도달하는지와 관계없이
AudioContext
시간을 기준으로 지속적으로 이루어집니다.
[Exposed =Window ]interface AudioNode :EventTarget {AudioNode connect (AudioNode destinationNode ,optional unsigned long output = 0,optional unsigned long input = 0);undefined connect (AudioParam destinationParam ,optional unsigned long output = 0);undefined disconnect ();undefined disconnect (unsigned long output );undefined disconnect (AudioNode destinationNode );undefined disconnect (AudioNode destinationNode ,unsigned long output );undefined disconnect (AudioNode destinationNode ,unsigned long output ,unsigned long input );undefined disconnect (AudioParam destinationParam );undefined disconnect (AudioParam destinationParam ,unsigned long output );readonly attribute BaseAudioContext context ;readonly attribute unsigned long numberOfInputs ;readonly attribute unsigned long numberOfOutputs ;attribute unsigned long channelCount ;attribute ChannelCountMode channelCountMode ;attribute ChannelInterpretation channelInterpretation ; };
1.5.1. AudioNode 생성
AudioNode는
두 가지 방법으로 생성할 수 있습니다. 이 특정 인터페이스의
생성자를 사용하거나 BaseAudioContext
또는
AudioContext의
팩토리 메서드를
사용할 수 있습니다.
AudioNode의
생성자 첫 번째 인수로 전달된 BaseAudioContext를
생성될 AudioNode의
연관된 BaseAudioContext라고
합니다. 마찬가지로 팩토리 메서드를 사용할 때
AudioNode의
연관된
BaseAudioContext는 이 팩토리 메서드가
호출된 BaseAudioContext입니다.
AudioNode를
상속하는 객체 o를 초기화한다는 것은
이 인터페이스의 생성자에 전달된 인수 context 및 dict가
주어졌을 때 다음 단계를 실행하는 것을 의미합니다.
-
o의 연관된
BaseAudioContext를 context로 설정합니다. -
numberOfInputs,numberOfOutputs,channelCount,channelCountMode,channelInterpretation의 값을 각AudioNode절에서 설명한 이 특정 인터페이스의 기본값으로 설정합니다. -
전달된 dict의 각 멤버에 대해 k를 멤버의 키, v를 해당 값으로 두고 다음 단계를 실행합니다. 이 단계를 실행하는 동안 예외가 발생하면 반복을 중단하고 예외를 알고리즘 호출자(생성자 또는 팩토리 메서드)에게 전파합니다.
-
k가 이 인터페이스의
AudioParam이름이면 이AudioParam의value속성을 v로 설정합니다. -
그렇지 않고 k가 이 인터페이스의 속성 이름이면 이 속성과 연관된 객체를 v로 설정합니다.
-
팩토리 메서드의 연관된 인터페이스는 이 메서드에서 반환되는 객체의 인터페이스입니다. 인터페이스의 연관된 옵션 객체는 이 인터페이스의 생성자에 전달할 수 있는 옵션 객체입니다.
AudioNode는
[DOM]에
설명된 EventTarget입니다.
이는 다른 EventTarget이
이벤트를 받는 것과 같은 방식으로
AudioNode에
이벤트를 디스패치할 수 있음을 의미합니다.
enum {ChannelCountMode "max" ,"clamped-max" ,"explicit" };
ChannelCountMode는
노드의 channelCount
및 channelInterpretation
값과 함께 사용되어 노드의 입력을 어떻게 믹싱할지 제어하는
computedNumberOfChannels를 결정합니다.
computedNumberOfChannels는
아래와 같이 결정됩니다. 믹싱 방법에 대한 자세한 내용은
§ 4 채널 업 믹싱 및
다운 믹싱을 참조하십시오.
| 열거형 값 | 설명 |
|---|---|
"max"
|
computedNumberOfChannels는
입력에 대한 모든 연결의 채널 수 중 최댓값입니다. 이 모드에서는
channelCount가
무시됩니다.
|
"clamped-max"
|
computedNumberOfChannels는
"max"와
같은 방식으로 결정된 다음 주어진
channelCount를
최댓값으로 하여 제한됩니다.
|
"explicit"
|
computedNumberOfChannels는
channelCount로
지정된 정확한 값입니다.
|
enum {ChannelInterpretation "speakers" ,"discrete" };
| 열거형 값 | 설명 |
|---|---|
"speakers"
|
업 믹스 방정식 또는 다운 믹스 방정식을
사용합니다. 채널 수가 이러한 기본 스피커 레이아웃 중
어느 것과도 일치하지 않는 경우 "discrete"로
되돌아갑니다.
|
"discrete"
| 채널이 소진될 때까지 채운 다음 남은 채널을 0으로 설정하여 업 믹스합니다. 가능한 한 많은 채널을 채운 다음 남은 채널을 버려 다운 믹스합니다. |
1.5.2. AudioNode 테일 타임
AudioNode에는
테일 타임이 있을 수 있습니다.
이는 AudioNode에
무음이 입력되더라도 출력은 무음이 아닐 수 있음을 의미합니다.
AudioNode는
과거의 입력이 미래의 출력에 영향을 주는 내부 처리 상태를
가지고 있는 경우 0이 아닌 테일 타임을 가집니다. AudioNode는
입력이 무음이 아닌 상태에서 무음 상태로 전환된 후에도 계산된 테일 타임 동안
무음이 아닌 출력을 계속 생성할 수 있습니다.
1.5.3. AudioNode 수명
AudioNode는
다음 조건 중 하나라도 충족되면 렌더 퀀텀
동안 활성
처리 중일 수 있습니다.
-
AudioScheduledSourceNode는 현재 렌더 퀀텀의 적어도 일부 동안 재생 중인 경우에만 활성 처리 중입니다. -
MediaElementAudioSourceNode는 그mediaElement가 현재 렌더 퀀텀의 적어도 일부 동안 재생 중인 경우에만 활성 처리 중입니다. -
MediaStreamAudioSourceNode또는MediaStreamTrackAudioSourceNode는 연관된MediaStreamTrack객체의readyState속성이"live"이고,muted속성이false이며enabled속성이true일 때 활성 처리 중입니다. -
사이클 내의
DelayNode는 현재 렌더 퀀텀의 출력 샘플 중 하나라도 절댓값이 \( 2^{-126} \)보다 크거나 같은 경우에만 활성 처리 중입니다. -
ScriptProcessorNode는 입력 또는 출력이 연결되어 있을 때 활성 처리 중입니다. -
AudioWorkletNode는 그AudioWorkletProcessor의[[callable process]]가true를 반환하고, 그 활성 소스 플래그가true이거나 입력 중 하나에 연결된AudioNode중 하나가 활성 처리 중일 때 활성 처리 중입니다. -
그 밖의 모든
AudioNode는 입력 중 하나에 연결된AudioNode가 활성 처리 중이 되면 활성 처리을 시작하고, 다른 활성 처리 중인AudioNode에서 받은 입력이 더 이상 출력에 영향을 주지 않으면 활성 처리를 중단합니다.
참고: 여기에는
테일 타임을 가진
AudioNode도
고려됩니다.
활성
처리 중이 아닌 AudioNode는
무음인 단일 채널을 출력합니다.
1.5.4. 속성
channelCount, 유형은 unsigned long-
channelCount는 노드의 모든 입력에 대한 연결을 업 믹싱 및 다운 믹싱할 때 사용하는 채널 수입니다. 값이 특별히 결정되는 특정 노드를 제외하면 기본값은 2입니다. 이 속성은 입력이 없는 노드에는 영향을 주지 않습니다. 이 값을 0 또는 구현의 최대 채널 수보다 큰 값으로 설정하면 구현은 반드시NotSupportedError예외를 발생시켜야 합니다.또한 일부 노드에는 채널 수에 가능한 값에 대한 추가 channelCount 제약 조건이 있습니다:
AudioDestinationNode-
동작은 대상 노드가
AudioContext또는OfflineAudioContext의 대상인지에 따라 달라집니다:AudioContext-
채널 수는 반드시 1 이상
maxChannelCount이하여야 합니다. 이 범위를 벗어난 값으로 채널 수를 설정하려는 모든 시도에는IndexSizeError예외를 반드시 발생시켜야 합니다. OfflineAudioContext-
채널 수는 변경할 수 없습니다. 값을 변경하려는 모든 시도에는
InvalidStateError예외를 반드시 발생시켜야 합니다.
AudioWorkletNode-
§ 1.32.4.3.2 AudioWorkletNodeOptions를 사용한 채널 구성
AudioWorkletNodeOptions를 사용한 채널 구성을 참조하십시오. ChannelMergerNode-
채널 수는 변경할 수 없으며 값을 변경하려는 모든 시도에는
InvalidStateError예외를 반드시 발생시켜야 합니다. ChannelSplitterNode-
채널 수는 변경할 수 없으며 값을 변경하려는 모든 시도에는
InvalidStateError예외를 반드시 발생시켜야 합니다. ConvolverNode-
채널 수는 2보다 클 수 없으며, 2보다 큰 값으로 변경하려는 모든 시도에는
NotSupportedError예외를 반드시 발생시켜야 합니다. DynamicsCompressorNode-
채널 수는 2보다 클 수 없으며, 2보다 큰 값으로 변경하려는 모든 시도에는
NotSupportedError예외를 반드시 발생시켜야 합니다. PannerNode-
채널 수는 2보다 클 수 없으며, 2보다 큰 값으로 변경하려는 모든 시도에는
NotSupportedError예외를 반드시 발생시켜야 합니다. ScriptProcessorNode-
채널 수는 변경할 수 없으며 값을 변경하려는 모든 시도에는
NotSupportedError예외를 반드시 발생시켜야 합니다. StereoPannerNode-
채널 수는 2보다 클 수 없으며, 2보다 큰 값으로 변경하려는 모든 시도에는
NotSupportedError예외를 반드시 발생시켜야 합니다.
이 속성에 대한 자세한 내용은 § 4 채널 업 믹싱 및 다운 믹싱을 참조하십시오.
channelCountMode, 유형은 ChannelCountMode-
channelCountMode는 노드의 모든 입력에 대한 연결을 업 믹싱 및 다운 믹싱할 때 채널 수를 어떻게 계산할지 결정합니다. 기본값은 "max"입니다. 이 속성은 입력이 없는 노드에는 영향을 주지 않습니다.또한 일부 노드에는 채널 수 모드에 가능한 값에 대한 추가 channelCountMode 제약 조건이 있습니다:
AudioDestinationNode-
AudioDestinationNode가OfflineAudioContext의destination노드이면 채널 수 모드를 변경할 수 없습니다. 값을 변경하려는 모든 시도에는InvalidStateError예외를 반드시 발생시켜야 합니다. ChannelMergerNode-
채널 수 모드는 "
explicit"에서 변경할 수 없으며, 값을 변경하려는 모든 시도에는InvalidStateError예외를 반드시 발생시켜야 합니다. ChannelSplitterNode-
채널 수 모드는 "
explicit"에서 변경할 수 없으며, 값을 변경하려는 모든 시도에는InvalidStateError예외를 반드시 발생시켜야 합니다. ConvolverNode-
채널 수 모드는 "
max"로 설정할 수 없으며, "max"로 설정하려는 모든 시도에는NotSupportedError예외를 반드시 발생시켜야 합니다. DynamicsCompressorNode-
채널 수 모드는 "
max"로 설정할 수 없으며, "max"로 설정하려는 모든 시도에는NotSupportedError예외를 반드시 발생시켜야 합니다. PannerNode-
채널 수 모드는 "
max"로 설정할 수 없으며, "max"로 설정하려는 모든 시도에는NotSupportedError예외를 반드시 발생시켜야 합니다. ScriptProcessorNode-
채널 수 모드는 "
explicit"에서 변경할 수 없으며, 값을 변경하려는 모든 시도에는NotSupportedError예외를 반드시 발생시켜야 합니다. StereoPannerNode-
채널 수 모드는 "
max"로 설정할 수 없으며, "max"로 설정하려는 모든 시도에는NotSupportedError예외를 반드시 발생시켜야 합니다.
이 속성에 대한 자세한 내용은 § 4 채널 업 믹싱 및 다운 믹싱 절을 참조하십시오.
channelInterpretation, 유형은 ChannelInterpretation-
channelInterpretation은 노드의 모든 입력에 대한 연결을 업 믹싱 및 다운 믹싱할 때 개별 채널을 어떻게 처리할지 결정합니다. 기본값은 "speakers"입니다. 이 속성은 입력이 없는 노드에는 영향을 주지 않습니다.또한 일부 노드에는 채널 해석에 가능한 값에 대한 추가 channelInterpretation 제약 조건이 있습니다:
ChannelSplitterNode-
채널 해석은 "
discrete"에서 변경할 수 없으며, 값을 변경하려는 모든 시도에는InvalidStateError예외를 반드시 발생시켜야 합니다.
이 속성에 대한 자세한 내용은 § 4 채널 업 믹싱 및 다운 믹싱을 참조하십시오.
context, 유형은 BaseAudioContext, 읽기 전용-
이
AudioNode를 소유하는BaseAudioContext입니다. numberOfInputs, 유형은 unsigned long, 읽기 전용-
AudioNode로 들어오는 입력 수입니다. 소스 노드의 경우 0입니다. 이 속성은 많은AudioNode유형에서 미리 결정되어 있지만,ChannelMergerNode및AudioWorkletNode와 같은 일부AudioNode는 입력 수가 가변적입니다. numberOfOutputs, 유형은 unsigned long, 읽기 전용-
AudioNode에서 나오는 출력 수입니다. 이 속성은 일부AudioNode유형에서 미리 결정되어 있지만,ChannelSplitterNode및AudioWorkletNode처럼 가변적일 수 있습니다.
1.5.5. 메서드
connect(destinationNode, output, input)-
특정 노드의 주어진 출력과 다른 특정 노드의 주어진 입력 사이에는 하나의 연결만 존재할 수 있습니다. 끝점이 동일한 여러 연결은 무시됩니다.
이 메서드는
destinationAudioNode객체를 반환합니다.AudioNode.connect(destinationNode, output, input) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 destinationNodedestination매개변수는 연결할AudioNode입니다.destination매개변수가 다른AudioContext를 사용하여 생성된AudioNode이면InvalidAccessError를 반드시 발생시켜야 합니다. 즉,AudioNode는 여러AudioContext사이에서 공유할 수 없습니다. 여러AudioNode를 동일한AudioNode에 연결할 수 있으며, 이는 채널 업 믹싱 및 다운 믹싱 절에 설명되어 있습니다.outputunsigned long✘ ✔ output매개변수는AudioNode의 어느 출력에서 연결할지를 나타내는 인덱스입니다. 이 매개변수가 범위를 벗어나면IndexSizeError예외를 반드시 발생시켜야 합니다. connect()를 여러 번 호출하여 하나의AudioNode출력을 둘 이상의 입력에 연결할 수 있습니다. 따라서 "팬아웃"이 지원됩니다.inputinput매개변수는 대상AudioNode의 어느 입력에 연결할지를 나타내는 인덱스입니다. 이 매개변수가 범위를 벗어나면IndexSizeError예외를 반드시 발생시켜야 합니다.AudioNode를 다른AudioNode에 연결하여 사이클을 만들 수 있습니다. 즉, 하나의AudioNode가 다른AudioNode에 연결되고, 다시 그 노드가 첫 번째AudioNode의 입력 또는AudioParam으로 연결될 수 있습니다.반환 유형:AudioNode connect(destinationParam, output)-
AudioNode를AudioParam에 연결하고 a-rate 신호로 매개변수 값을 제어합니다.connect()를 여러 번 호출하여 하나의
AudioNode출력을 둘 이상의AudioParam에 연결할 수 있습니다. 따라서 "팬아웃"이 지원됩니다.connect()를 여러 번 호출하여 둘 이상의
AudioNode출력을 하나의AudioParam에 연결할 수 있습니다. 따라서 "팬인"이 지원됩니다.AudioParam은 연결된 모든AudioNode출력에서 렌더링된 오디오 데이터를 받아, 이미 모노가 아니라면 다운 믹싱하여 모노로 변환한 다음 다른 이러한 출력과 함께 믹싱하고, 마지막으로 매개변수에 예약된 타임라인 변경 사항을 포함하여 고유 매개변수 값(오디오 연결이 없는 경우AudioParam이 일반적으로 가지는value)과 믹싱합니다.모노로의 다운 믹싱은
channelCount= 1,channelCountMode= "explicit", 그리고channelInterpretation= "speakers"인AudioNode의 다운 믹싱과 동일합니다.특정 노드의 주어진 출력과 특정
AudioParam사이에는 하나의 연결만 존재할 수 있습니다. 끝점이 동일한 여러 연결은 무시됩니다.AudioNode.connect(destinationParam, output) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 destinationParamAudioParam✘ ✘ destination매개변수는 연결할AudioParam입니다. 이 메서드는destinationAudioParam객체를 반환하지 않습니다.destinationParam이 이 메서드가 호출된AudioNode를 생성한BaseAudioContext와 다른BaseAudioContext에 속한AudioNode에 속하면InvalidAccessError를 반드시 발생시켜야 합니다.outputunsigned long✘ ✔ output매개변수는AudioNode의 어느 출력에서 연결할지를 나타내는 인덱스입니다.parameter가 범위를 벗어나면IndexSizeError예외를 반드시 발생시켜야 합니다.반환 유형:undefined disconnect()-
AudioNode의 모든 나가는 연결을 끊습니다.매개변수 없음.반환 유형:undefined disconnect(output)-
AudioNode의 단일 출력을 연결되어 있는 다른 모든AudioNode또는AudioParam객체에서 연결 해제합니다.AudioNode.disconnect(output) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 outputunsigned long✘ ✘ 이 매개변수는 AudioNode의 어느 출력을 연결 해제할지를 나타내는 인덱스입니다. 주어진 출력의 모든 나가는 연결을 끊습니다. 이 매개변수가 범위를 벗어나면IndexSizeError예외를 반드시 발생시켜야 합니다.반환 유형:undefined disconnect(destinationNode)-
AudioNode의 출력 중 특정 대상AudioNode로 향하는 모든 출력을 연결 해제합니다.AudioNode.disconnect(destinationNode) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 destinationNodedestinationNode매개변수는 연결 해제할AudioNode입니다. 주어진destinationNode로 향하는 모든 나가는 연결을 끊습니다.destinationNode에 대한 연결이 없으면InvalidAccessError예외를 반드시 발생시켜야 합니다.반환 유형:undefined disconnect(destinationNode, output)-
AudioNode의 특정 출력을 어떤 대상AudioNode의 모든 입력에서 연결 해제합니다.AudioNode.disconnect(destinationNode, output) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 destinationNodedestinationNode매개변수는 연결 해제할AudioNode입니다. 주어진 출력에서destinationNode로의 연결이 없으면InvalidAccessError예외를 반드시 발생시켜야 합니다.outputunsigned long✘ ✘ output매개변수는AudioNode의 어느 출력에서 연결 해제할지를 나타내는 인덱스입니다. 이 매개변수가 범위를 벗어나면IndexSizeError예외를 반드시 발생시켜야 합니다.반환 유형:undefined disconnect(destinationNode, output, input)-
AudioNode의 특정 출력을 어떤 대상AudioNode의 특정 입력에서 연결 해제합니다.AudioNode.disconnect(destinationNode, output, input) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 destinationNodedestinationNode매개변수는 연결 해제할AudioNode입니다. 주어진 출력에서 주어진 입력으로의destinationNode연결이 없으면InvalidAccessError예외를 반드시 발생시켜야 합니다.outputunsigned long✘ ✘ output매개변수는AudioNode의 어느 출력에서 연결 해제할지를 나타내는 인덱스입니다. 이 매개변수가 범위를 벗어나면IndexSizeError예외를 반드시 발생시켜야 합니다.inputinput매개변수는 대상AudioNode의 어느 입력에서 연결 해제할지를 나타내는 인덱스입니다. 이 매개변수가 범위를 벗어나면IndexSizeError예외를 반드시 발생시켜야 합니다.반환 유형:undefined disconnect(destinationParam)-
AudioNode의 출력 중 특정 대상AudioParam으로 향하는 모든 출력을 연결 해제합니다. 이 작업이 적용되면 이AudioNode가 계산된 매개변수 값에 기여하는 값은 0이 됩니다. 고유 매개변수 값은 이 작업의 영향을 받지 않습니다.AudioNode.disconnect(destinationParam) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 destinationParamAudioParam✘ ✘ destinationParam매개변수는 연결 해제할AudioParam입니다.destinationParam에 대한 연결이 없으면InvalidAccessError예외를 반드시 발생시켜야 합니다.반환 유형:undefined disconnect(destinationParam, output)-
AudioNode의 특정 출력을 특정 대상AudioParam에서 연결 해제합니다. 이 작업이 적용되면 이AudioNode가 계산된 매개변수 값에 기여하는 값은 0이 됩니다. 고유 매개변수 값은 이 작업의 영향을 받지 않습니다.AudioNode.disconnect(destinationParam, output) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 destinationParamAudioParam✘ ✘ destinationParam매개변수는 연결 해제할AudioParam입니다.destinationParam에 대한 연결이 없으면InvalidAccessError예외를 반드시 발생시켜야 합니다.outputunsigned long✘ ✘ output매개변수는AudioNode의 어느 출력에서 연결 해제할지를 나타내는 인덱스입니다.parameter가 범위를 벗어나면IndexSizeError예외를 반드시 발생시켜야 합니다.반환 유형:undefined
1.5.6.
AudioNodeOptions
이는 모든
AudioNode를
생성할 때 사용할 수 있는 옵션을 지정합니다.
모든 멤버는 선택 사항입니다. 그러나 각 노드에 사용되는 구체적인
값은 실제 노드에 따라 달라집니다.
dictionary AudioNodeOptions {unsigned long channelCount ;ChannelCountMode channelCountMode ;ChannelInterpretation channelInterpretation ; };
1.5.6.1.
AudioNodeOptions
딕셔너리 멤버
channelCount, 유형은 unsigned long-
channelCount속성에 대해 원하는 채널 수입니다. channelCountMode, 유형은 ChannelCountMode-
channelCountMode속성에 대해 원하는 모드입니다. channelInterpretation, 유형은 ChannelInterpretation-
channelInterpretation속성에 대해 원하는 모드입니다.
1.6.
AudioParam
인터페이스
AudioParam은
볼륨과 같은 AudioNode 기능의
개별 측면을 제어합니다. 매개변수는
value 속성을 사용하여 특정 값으로 즉시 설정할 수 있습니다.
또는 엔벌로프, 볼륨 페이드, LFO, 필터 스윕, 그레인 윈도우 등에 대해
값 변경이 매우 정밀한 시간(AudioContext의
currentTime
속성의 좌표계)에서 발생하도록 예약할 수 있습니다. 이러한 방식으로
임의의 타임라인 기반 자동화 곡선을 어떤 AudioParam에도
설정할 수 있습니다. 또한 AudioNode의
출력에서 나오는 오디오 신호를 AudioParam에
연결하여 고유 매개변수 값과 합산할 수 있습니다.
일부 합성 및 처리 AudioNode에는
값이 각 오디오 샘플 단위로 반드시 고려되어야 하는
AudioParam이
속성으로 있습니다. 다른 AudioParam의
경우 샘플 단위의 정확성은 중요하지 않으며 값 변경을 더 거친 간격으로
샘플링할 수 있습니다. 각 개별 AudioParam은
그 값이 각 오디오 샘플 단위로 반드시 고려되어야 함을 의미하는
a-rate 매개변수이거나,
k-rate
매개변수임을 지정합니다.
구현은 반드시 블록 처리를 사용해야 하며, 각
AudioNode는
하나의 렌더
퀀텀을 처리해야 합니다.
각 렌더 퀀텀에 대해
k-rate 매개변수의 값은
첫 번째 샘플 프레임 시점에 반드시 샘플링되어야 하며, 그 값은 전체
블록에 반드시 사용되어야 합니다. a-rate 매개변수는
블록의
각 샘플 프레임마다 반드시 샘플링되어야 합니다.
AudioParam에
따라 그 레이트는 automationRate
속성을 "a-rate"
또는 "k-rate"로
설정하여 제어할 수 있습니다.
자세한 내용은 각 개별 AudioParam의
설명을 참조하십시오.
각 AudioParam에는
함께 매개변수의 단순 명목
범위를 구성하는 minValue
및 maxValue
속성이 포함됩니다. 실질적으로 매개변수 값은
\([\mathrm{minValue}, \mathrm{maxValue}]\) 범위로 제한됩니다.
자세한 내용은 § 1.6.3 값 계산을 참조하십시오.
많은 AudioParam에서
minValue
및 maxValue는
가능한 최대 범위로 설정하기 위한 것입니다. 이 경우 maxValue는
값이 3.4028235e38인
가장 큰 양의 단정밀도
부동소수점 값으로 설정해야 합니다.
(그러나 IEEE-754 배정밀도 부동소수점 값만 지원하는 JavaScript에서는
이를 3.4028234663852886e38로 작성해야 합니다.)
마찬가지로 minValue는
가장 큰 양의
단정밀도 부동소수점 값의 음수인
가장 작은 음의 단정밀도
부동소수점 값,
즉 -3.4028235e38로 설정해야 합니다.
(마찬가지로 JavaScript에서는 이를
-3.4028234663852886e38로 작성해야 합니다.)
AudioParam은
0개 이상의 자동화 이벤트
목록을 유지합니다. 각 자동화 이벤트는
AudioContext의
currentTime
속성의 시간 좌표계에서 해당 이벤트의
자동화 이벤트 시간을 기준으로
특정 시간
범위에 걸친 매개변수 값의 변경을 지정합니다.
자동화 이벤트 목록은 자동화 이벤트 시간의 오름차순으로 유지됩니다.
주어진 자동화 이벤트의 동작은 AudioContext의
현재 시간뿐 아니라 이 이벤트와 목록의 인접한 이벤트의 자동화 이벤트
시간에 따라 달라집니다. 다음 자동화 메서드는 해당 메서드에 고유한 유형의
새 이벤트를 이벤트 목록에 추가하여 이벤트 목록을 변경합니다:
-
setValueAtTime()-SetValue -
linearRampToValueAtTime()-LinearRampToValue -
exponentialRampToValueAtTime()-ExponentialRampToValue -
setTargetAtTime()-SetTarget -
setValueCurveAtTime()-SetValueCurve
이러한 메서드를 호출할 때는 다음 규칙이 적용됩니다:
-
자동화 이벤트 시간은 현재 샘플 레이트에 대해 양자화되지 않습니다. 곡선 및 램프를 결정하는 공식은 이벤트를 예약할 때 주어진 정확한 수치 시간에 적용됩니다.
-
이러한 이벤트 중 하나가 이미 하나 이상의 이벤트가 있는 시간에 추가되면 기존 이벤트들 뒤에 배치되지만, 해당 이벤트보다 시간이 뒤인 이벤트들보다는 앞에 배치됩니다.
-
setValueCurveAtTime()이 시간 \(T\)와 지속 시간 \(D\)에 대해 호출되고 시간이 \(T\)보다 엄격히 크면서 \(T + D\)보다 엄격히 작은 이벤트가 하나라도 있다면
NotSupportedError예외를 반드시 발생시켜야 합니다. 즉, 다른 이벤트가 포함된 시간 구간에 값 곡선을 예약하는 것은 허용되지 않지만, 다른 이벤트와 정확히 같은 시간에 값 곡선을 예약하는 것은 허용됩니다. -
마찬가지로 자동화 메서드가 \([T, T+D)\)에 포함되는 시간에 호출되는 경우
NotSupportedError예외를 반드시 발생시켜야 합니다. 여기서 \(T\)는 곡선의 시간이고 \(D\)는 그 지속 시간입니다.
참고: AudioParam
속성은 value
속성을 제외하고 읽기 전용입니다.
AudioParam의
자동화 레이트는 automationRate
속성을 다음 값 중 하나로 설정하여 선택할 수 있습니다.
그러나 일부 AudioParam에는
자동화 레이트를 변경할 수 있는지에 대한 제약이 있습니다.
enum {AutomationRate "a-rate" ,"k-rate" };
| 열거형 값 | 설명 |
|---|---|
"a-rate"
|
이 AudioParam은
a-rate
처리를 사용하도록 설정됩니다.
|
"k-rate"
|
이 AudioParam은
k-rate
처리를 사용하도록 설정됩니다.
|
각 AudioParam에는
내부 슬롯 [[current value]]이 있으며,
처음에는 AudioParam의
defaultValue로
설정됩니다.
[Exposed =Window ]interface AudioParam {attribute float value ;attribute AutomationRate automationRate ;readonly attribute float defaultValue ;readonly attribute float minValue ;readonly attribute float maxValue ;AudioParam setValueAtTime (float ,value double );startTime AudioParam linearRampToValueAtTime (float ,value double );endTime AudioParam exponentialRampToValueAtTime (float ,value double );endTime AudioParam setTargetAtTime (float ,target double ,startTime float );timeConstant AudioParam setValueCurveAtTime (sequence <float >,values double ,startTime double );duration AudioParam cancelScheduledValues (double );cancelTime AudioParam cancelAndHoldAtTime (double ); };cancelTime
1.6.1. 속성
automationRate, 유형은 AutomationRate-
AudioParam의 자동화 레이트입니다. 기본값은 실제AudioParam에 따라 달라집니다. 기본값은 각 개별AudioParam의 설명을 참조하십시오.일부 노드에는 다음과 같은 추가 자동화 레이트 제약 조건이 있습니다:
AudioBufferSourceNode-
AudioParamplaybackRate및detune는 반드시 "k-rate"여야 합니다. 레이트가 "a-rate"로 변경되면InvalidStateError를 반드시 발생시켜야 합니다. DynamicsCompressorNode-
AudioParamthreshold,knee,ratio,attack, 그리고release는 반드시 "k-rate"여야 합니다. 레이트가 "a-rate"로 변경되면InvalidStateError를 반드시 발생시켜야 합니다. PannerNode-
panningModel이 "HRTF"이면,PannerNode의 모든AudioParam에 대한automationRate설정은 무시됩니다. 마찬가지로AudioListener의 모든AudioParam에 대한automationRate설정도 무시됩니다. 이 경우AudioParam은automationRate가 "k-rate"로 설정된 것처럼 동작합니다.
defaultValue, 유형은 float, 읽기 전용-
value속성의 초기값입니다. maxValue, 유형은 float, 읽기 전용-
매개변수가 가질 수 있는 명목상 최댓값입니다.
minValue와 함께 이 매개변수의 명목 범위를 구성합니다. minValue, 유형은 float, 읽기 전용-
매개변수가 가질 수 있는 명목상 최솟값입니다.
maxValue와 함께 이 매개변수의 명목 범위를 구성합니다. value, 유형은 float-
매개변수의 부동소수점 값입니다. 이 속성은
defaultValue로 초기화됩니다.이 속성을 가져오면
[[current value]]슬롯의 내용을 반환합니다. 반환되는 값의 알고리즘은 § 1.6.3 값 계산을 참조하십시오.이 속성을 설정하면 요청된 값을
[[current value]]슬롯에 할당하고, 현재AudioContext의currentTime과[[current value]]를 사용하여 setValueAtTime() 메서드를 호출하는 효과가 있습니다.setValueAtTime()에서 발생할 예외는 이 속성을 설정할 때에도 발생합니다.
1.6.2. 메서드
cancelAndHoldAtTime(cancelTime)-
이는 시간이
cancelTime보다 크거나 같은 모든 예약된 매개변수 변경을 취소한다는 점에서cancelScheduledValues()와 유사합니다. 그러나 추가로cancelTime에 발생했을 자동화 값은 다른 자동화 이벤트가 추가될 때까지 이후의 모든 시간에 전파됩니다.자동화가 실행 중이고
cancelAndHoldAtTime()을 호출한 후cancelTime에 도달하기 전 언제든 자동화를 추가할 수 있는 상황에서cancelAndHoldAtTime()에 대한 타임라인의 동작은 상당히 복잡합니다. 따라서cancelAndHoldAtTime()의 동작은 다음 알고리즘에 지정되어 있습니다.\(t_c\)를cancelTime의 값으로 둡니다. 그런 다음-
\(E_1\)을 시간 \(t_1\)의 이벤트가 있으면 그 이벤트로 두며, 여기서 \(t_1\)은 \(t_1 \le t_c\)를 만족하는 가장 큰 수입니다.
-
\(E_2\)를 시간 \(t_2\)의 이벤트가 있으면 그 이벤트로 두며, 여기서 \(t_2\)는 \(t_c \lt t_2\)를 만족하는 가장 작은 수입니다.
-
\(E_2\)가 존재하면:
-
\(E_2\)가 선형 또는 지수 램프이면,
-
\(E_2\)를 시간 \(t_c\)에서 끝나고, 끝값이 시간 \(t_c\)에서 원래 램프가 가졌을 값인 동일한 종류의 램프로 실질적으로 다시 작성합니다.
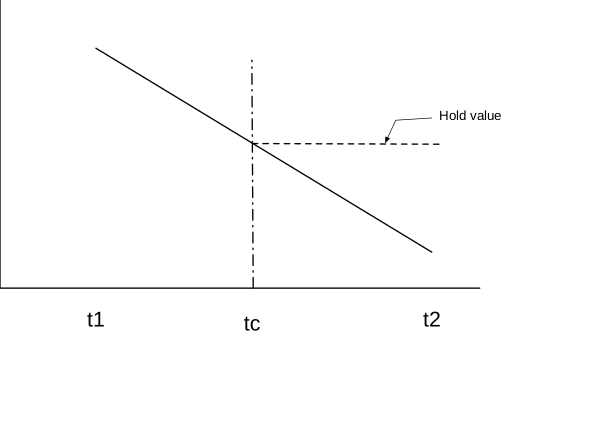
-
5단계로 이동합니다.
-
-
그렇지 않으면 4단계로 이동합니다.
-
-
\(E_1\)이 존재하면:
-
\(E_1\)이
setTarget이벤트이면,-
시간 \(t_c\)에
setTarget이 가졌을 값을 사용하여 시간 \(t_c\)에setValueAtTime이벤트를 암묵적으로 삽입합니다.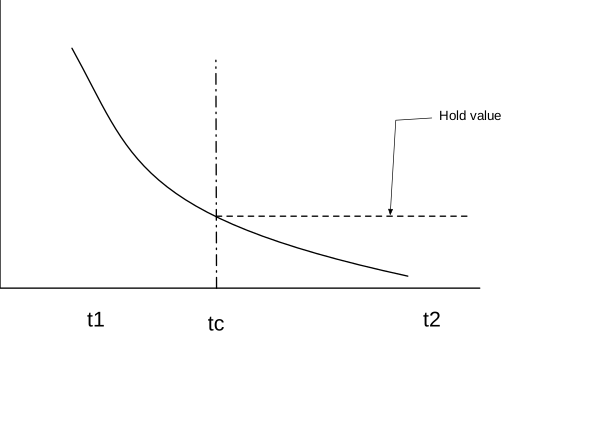
-
5단계로 이동합니다.
-
-
\(E_1\)이 시작 시간이 \(t_3\)이고 지속 시간이 \(d\)인
setValueCurve이면-
\(t_c \gt t_3 + d\)이면 5단계로 이동합니다.
-
그렇지 않으면,
-
이 이벤트를 시작 시간이 \(t_3\)이고 새로운 지속 시간이 \(t_c-t_3\)인
setValueCurve이벤트로 실질적으로 대체합니다. 그러나 이는 실제 대체가 아닙니다. 이 자동화는 다른 지속 시간을 사용하여 계산된 출력이 아니라 원본과 동일한 출력을 생성하도록 반드시 주의해야 합니다. (그렇게 하면 값 곡선을 약간 다른 방식으로 샘플링하여 다른 결과가 생성됩니다.)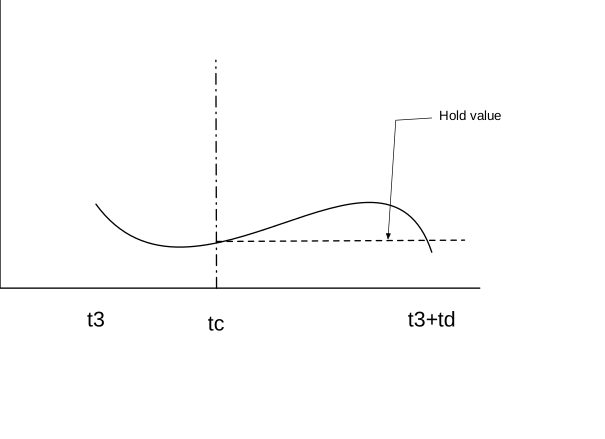
-
5단계로 이동합니다.
-
-
-
-
시간이 \(t_c\)보다 큰 모든 이벤트를 제거합니다.
이벤트가 추가되지 않으면
cancelAndHoldAtTime()이후의 자동화 값은 원래 타임라인이 시간 \(t_c\)에서 가졌을 상수 값입니다.AudioParam.cancelAndHoldAtTime() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 cancelTimedouble✘ ✘ 이전에 예약된 모든 매개변수 변경이 취소되는 기준 시간입니다. AudioContext의currentTime속성과 동일한 시간 좌표계의 시간입니다.cancelTime이 음수이면RangeError예외를 반드시 발생시켜야 합니다.cancelTime이currentTime보다 작으면currentTime으로 제한됩니다.반환 유형:AudioParam -
cancelScheduledValues(cancelTime)-
시간이
cancelTime보다 크거나 같은 모든 예약된 매개변수 변경을 취소합니다. 예약된 매개변수 변경을 취소한다는 것은 예약된 이벤트를 이벤트 목록에서 제거하는 것을 의미합니다. 자동화 이벤트 시간이cancelTime보다 작은 모든 활성 자동화도 취소되며, 이러한 취소는 원래 값(해당 자동화 이전의 값)이 즉시 복원되므로 불연속을 일으킬 수 있습니다.cancelAndHoldAtTime()에 의해 예약된 모든 유지 값 역시 유지 시간이cancelTime이후에 발생하면 제거됩니다.setValueCurveAtTime()의 경우 \(T_0\)와 \(T_D\)를 각각 이 이벤트에 해당하는startTime및duration으로 둡니다. 그러면cancelTime이 \([T_0, T_0 + T_D]\) 범위에 있으면 이벤트가 타임라인에서 제거됩니다.AudioParam.cancelScheduledValues() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 cancelTimedouble✘ ✘ 이전에 예약된 모든 매개변수 변경이 취소되는 기준 시간입니다. AudioContext의currentTime속성과 동일한 시간 좌표계의 시간입니다.cancelTime이 음수이면RangeError예외를 반드시 발생시켜야 합니다.cancelTime이currentTime보다 작으면currentTime으로 제한됩니다.반환 유형:AudioParam exponentialRampToValueAtTime(value, endTime)-
이전에 예약된 매개변수 값에서 주어진 값까지 매개변수 값이 지수적으로 연속 변경되도록 예약합니다. 필터 주파수와 재생 속도를 나타내는 매개변수는 인간이 소리를 인지하는 방식 때문에 지수적으로 변경하는 것이 가장 적합합니다.
시간 구간 \(T_0 \leq t < T_1\) (여기서 \(T_0\)는 이전 이벤트의 시간이고 \(T_1\)은 이 메서드에 전달된
endTime매개변수임) 동안의 값은 다음과 같이 계산됩니다:$$ v(t) = V_0 \left(\frac{V_1}{V_0}\right)^\frac{t - T_0}{T_1 - T_0} $$여기서 \(V_0\)는 시간 \(T_0\)에서의 값이고 \(V_1\)은 이 메서드에 전달된
value매개변수입니다. \(V_0\)와 \(V_1\)의 부호가 반대이거나 \(V_0\)가 0이면 \(T_0 \le t \lt T_1\)에서 \(v(t) = V_0\)입니다.이는 0까지의 지수 램프가 불가능하다는 의미이기도 합니다. 적절한 시간 상수와 함께
setTargetAtTime()을 사용하면 좋은 근삿값을 얻을 수 있습니다.이 ExponentialRampToValue 이벤트 이후에 더 이상 이벤트가 없으면 \(t \geq T_1\)에서 \(v(t) = V_1\)입니다.
이 이벤트에 선행하는 이벤트가 없으면 지수 램프는
setValueAtTime(value, currentTime)을 호출한 것처럼 동작합니다. 여기서value는 속성의 현재 값이고,currentTime은exponentialRampToValueAtTime()이 호출되는 시점의 컨텍스트currentTime입니다.선행 이벤트가
SetTarget이벤트이면 \(T_0\)와 \(V_0\)는SetTarget자동화의 현재 시간과 값에서 선택됩니다. 즉,SetTarget이벤트가 시작되지 않았다면 \(T_0\)는 이벤트의 시작 시간이고 \(V_0\)는SetTarget이벤트가 시작되기 직전의 값입니다. 이 경우ExponentialRampToValue이벤트가SetTarget이벤트를 실질적으로 대체합니다.SetTarget이벤트가 이미 시작되었다면 \(T_0\)는 현재 컨텍스트 시간이고 \(V_0\)는 시간 \(T_0\)에서 현재SetTarget자동화 값입니다. 두 경우 모두 자동화 곡선은 연속적입니다.AudioParam.exponentialRampToValueAtTime() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 valuefloat✘ ✘ 주어진 시간에 매개변수가 지수적으로 램프하여 도달할 값입니다. 이 값이 0이면 RangeError예외를 반드시 발생시켜야 합니다.endTimedouble✘ ✘ 지수 램프가 끝나는, AudioContext의currentTime속성과 동일한 시간 좌표계의 시간입니다.endTime이 음수이거나 유한한 수가 아니면RangeError예외를 반드시 발생시켜야 합니다. endTime이currentTime보다 작으면currentTime으로 제한됩니다.반환 유형:AudioParam linearRampToValueAtTime(value, endTime)-
이전에 예약된 매개변수 값에서 주어진 값까지 매개변수 값이 선형으로 연속 변경되도록 예약합니다.
시간 구간 \(T_0 \leq t < T_1\) (여기서 \(T_0\)는 이전 이벤트의 시간이고 \(T_1\)은 이 메서드에 전달된
endTime매개변수임) 동안의 값은 다음과 같이 계산됩니다:$$ v(t) = V_0 + (V_1 - V_0) \frac{t - T_0}{T_1 - T_0} $$여기서 \(V_0\)는 시간 \(T_0\)에서의 값이고 \(V_1\)은 이 메서드에 전달된
value매개변수입니다.이 LinearRampToValue 이벤트 이후에 더 이상 이벤트가 없으면 \(t \geq T_1\)에서 \(v(t) = V_1\)입니다.
이 이벤트에 선행하는 이벤트가 없으면 선형 램프는
setValueAtTime(value, currentTime)을 호출한 것처럼 동작합니다. 여기서value는 속성의 현재 값이고currentTime은linearRampToValueAtTime()이 호출되는 시점의 컨텍스트currentTime입니다.선행 이벤트가
SetTarget이벤트이면 \(T_0\)와 \(V_0\)는SetTarget자동화의 현재 시간과 값에서 선택됩니다. 즉,SetTarget이벤트가 시작되지 않았다면 \(T_0\)는 이벤트의 시작 시간이고 \(V_0\)는SetTarget이벤트가 시작되기 직전의 값입니다. 이 경우LinearRampToValue이벤트가SetTarget이벤트를 실질적으로 대체합니다.SetTarget이벤트가 이미 시작되었다면 \(T_0\)는 현재 컨텍스트 시간이고 \(V_0\)는 시간 \(T_0\)에서 현재SetTarget자동화 값입니다. 두 경우 모두 자동화 곡선은 연속적입니다.AudioParam.linearRampToValueAtTime() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 valuefloat✘ ✘ 주어진 시간에 매개변수가 선형으로 램프하여 도달할 값입니다. endTimedouble✘ ✘ 자동화가 끝나는, AudioContext의currentTime속성과 동일한 시간 좌표계의 시간입니다.endTime이 음수이거나 유한한 수가 아니면RangeError예외를 반드시 발생시켜야 합니다. endTime이currentTime보다 작으면currentTime으로 제한됩니다.반환 유형:AudioParam setTargetAtTime(target, startTime, timeConstant)-
주어진 시간에 주어진 시간 상수를 가진 레이트로 대상 값에 지수적으로 접근하기 시작합니다. 다른 용도 중에서도 이는 ADSR 엔벌로프의 "감쇠" 및 "릴리스" 부분을 구현하는 데 유용합니다. 매개변수 값은 주어진 시간에 대상 값으로 즉시 변경되는 것이 아니라 대상 값으로 점진적으로 변경된다는 점에 유의하십시오.
시간 구간 \(T_0 \leq t\) 동안, 여기서 \(T_0\)는
startTime매개변수입니다:$$ v(t) = V_1 + (V_0 - V_1)\, e^{-\left(\frac{t - T_0}{\tau}\right)} $$여기서 \(V_0\)는 \(T_0\)(
startTime매개변수)에서의 초기값([[current value]]속성)이고, \(V_1\)은target매개변수와 같으며, \(\tau\)는timeConstant매개변수입니다.이 이벤트 뒤에
LinearRampToValue또는ExponentialRampToValue이벤트가 오면 동작은 각각linearRampToValueAtTime()또는exponentialRampToValueAtTime()에 설명되어 있습니다. 그 밖의 모든 이벤트에서는SetTarget이벤트가 다음 이벤트의 시간에 끝납니다.AudioParam.setTargetAtTime() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 targetfloat✘ ✘ 주어진 시간에 매개변수가 변경되기 시작할 대상 값입니다. startTimedouble✘ ✘ 지수적 접근이 시작되는, AudioContext의currentTime속성과 동일한 시간 좌표계의 시간입니다.start가 음수이거나 유한한 수가 아니면RangeError예외를 반드시 발생시켜야 합니다. startTime이currentTime보다 작으면currentTime으로 제한됩니다.timeConstantfloat✘ ✘ 대상 값에 대한 1차 필터(지수적) 접근의 시간 상수 값입니다. 이 값이 클수록 전환이 느려집니다. 값은 반드시 음수가 아니어야 하며, 그렇지 않으면 RangeError예외를 반드시 발생시켜야 합니다.timeConstant가 0이면 출력 값은 즉시 최종 값으로 점프합니다. 더 정확히 말하면 timeConstant는 1차 선형 연속 시불변 시스템이 계단 입력 응답(0에서 1로의 값 전환)이 주어졌을 때 \(1 - 1/e\)(약 63.2%) 값에 도달하는 데 걸리는 시간입니다.반환 유형:AudioParam setValueAtTime(value, startTime)-
주어진 시간에 매개변수 값이 변경되도록 예약합니다.
이
SetValue이벤트 이후에 더 이상 이벤트가 없으면 \(t \geq T_0\)에 대해 \(v(t) = V\)입니다. 여기서 \(T_0\)는startTime매개변수이고 \(V\)는value매개변수입니다. 즉, 값은 일정하게 유지됩니다.이
SetValue이벤트 이후의 다음 이벤트(시간 \(T_1\))가LinearRampToValue또는ExponentialRampToValue유형이 아니면 \(T_0 \leq t < T_1\)에서:$$ v(t) = V $$즉, 이 시간 구간 동안 값이 일정하게 유지되어 "계단" 함수를 만들 수 있습니다.
이
SetValue이벤트 이후의 다음 이벤트가LinearRampToValue또는ExponentialRampToValue유형이면 각각linearRampToValueAtTime()또는exponentialRampToValueAtTime()을 참조하십시오.AudioParam.setValueAtTime() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 valuefloat✘ ✘ 주어진 시간에 매개변수가 변경될 값입니다. startTimedouble✘ ✘ 매개변수가 주어진 값으로 변경되는, BaseAudioContext의currentTime속성과 동일한 시간 좌표계의 시간입니다.startTime이 음수이거나 유한한 수가 아니면RangeError예외를 반드시 발생시켜야 합니다. startTime이currentTime보다 작으면currentTime으로 제한됩니다.반환 유형:AudioParam setValueCurveAtTime(values, startTime, duration)-
주어진 시간부터 주어진 지속 시간 동안 임의의 매개변수 값 배열을 설정합니다. 값의 수는 원하는 지속 시간에 맞게 조정됩니다.
\(T_0\)를
startTime, \(T_D\)를duration, \(V\)를values배열, \(N\)을values배열의 길이로 둡니다. 그러면 시간 구간 \(T_0 \le t < T_0 + T_D\) 동안 다음과 같이 둡니다$$ \begin{align*} k &= \left\lfloor \frac{N - 1}{T_D}(t-T_0) \right\rfloor \\ \end{align*} $$그러면 \(v(t)\)는 \(V[k]\)와 \(V[k+1]\) 사이를 선형 보간하여 계산됩니다.
곡선 시간 구간이 끝난 후(\(t \ge T_0 + T_D\))에는 다른 자동화 이벤트가 있을 때까지 값이 최종 곡선 값으로 일정하게 유지됩니다.
뒤따르는 자동화가
setValueCurveAtTime()이벤트의 끝에서 시작하도록 하기 위해 시간 \(T_0 + T_D\)에 값 \(V[N-1]\)을 사용하여setValueAtTime()이 암묵적으로 호출됩니다.AudioParam.setValueCurveAtTime() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 valuessequence<float>✘ ✘ 매개변수 값 곡선을 나타내는 float 값의 시퀀스입니다. 이러한 값은 주어진 시간부터 적용되어 주어진 지속 시간 동안 유지됩니다. 이 메서드가 호출되면 자동화 목적으로 곡선의 내부 복사본이 생성됩니다. 따라서 이후 전달된 배열의 내용을 수정해도 AudioParam에는 영향을 주지 않습니다. 이 속성이 길이가 2보다 작은sequence<float>객체이면InvalidStateError를 반드시 발생시켜야 합니다.startTimedouble✘ ✘ 값 곡선이 적용되기 시작하는, AudioContext의currentTime속성과 동일한 시간 좌표계의 시작 시간입니다.startTime이 음수이거나 유한한 수가 아니면RangeError예외를 반드시 발생시켜야 합니다. startTime이currentTime보다 작으면currentTime으로 제한됩니다.durationdouble✘ ✘ startTime매개변수 이후values매개변수에 따라 값이 계산되는 시간(초)입니다.duration이 엄격히 양수가 아니거나 유한한 수가 아니면RangeError예외를 반드시 발생시켜야 합니다.반환 유형:AudioParam
1.6.3. 값 계산
AudioParam에는
두 가지 종류가 있습니다. 단순
매개변수와 복합
매개변수입니다.
단순 매개변수(기본값)는 단독으로 사용되어
AudioNode의
최종 오디오 출력을 계산합니다.
복합
매개변수는 다른 AudioParam과
함께 사용되어 값을 계산하고, 그 값은 다시
AudioNode의
출력을 계산하기 위한 입력으로 사용되는 AudioParam입니다.
computedValue는 오디오 DSP를 제어하는 최종 값이며, 각 렌더링 시간 퀀텀 동안 오디오 렌더링 스레드에서 계산됩니다.
AudioParam의
값 계산은 두 부분으로 이루어집니다:
-
오디오 DSP를 제어하는 최종 값이며 각 렌더 퀀텀 동안 오디오 렌더링 스레드에서 계산되는 paramComputedValue입니다.
이 값들은 반드시 다음과 같이 계산해야 합니다:
-
paramIntrinsicValue는 각 시점에서 계산됩니다. 이는
value속성에 직접 설정된 값이거나, 이 시점 이전 또는 이 시점에 해당하는 자동화 이벤트가 있으면 이러한 이벤트로부터 계산된 값입니다. 특정 시간 범위에서 자동화 이벤트가 제거되면 paramIntrinsicValue 값은 변경되지 않고 이전 값을 유지하며,value속성이 직접 설정되거나 해당 시간 범위에 자동화 이벤트가 추가될 때까지 그대로 유지됩니다. -
이 렌더 퀀텀의 시작 시점의 paramIntrinsicValue 값으로
[[current value]]를 설정합니다. -
paramComputedValue는 paramIntrinsicValue 값과 입력 AudioParam 버퍼 값의 합입니다. 합이
NaN이면 합을defaultValue로 대체합니다. -
이
AudioParam이 복합 매개변수이면 다른AudioParam과 함께 최종 값을 계산합니다. -
computedValue를 paramComputedValue로 설정합니다.
명목 범위는
computedValue가
실질적으로 가질 수 있는 하한값과 상한값입니다.
단순 매개변수의
경우 computedValue는
이 매개변수의 단순 명목
범위로 제한됩니다.
복합
매개변수는 구성 요소인 서로 다른
AudioParam
값으로부터 최종 값을 계산한 후 그 최종 값을 해당
명목
범위로 제한합니다.
자동화 메서드를 사용할 때에도 제한은 적용됩니다. 그러나 자동화 자체는 전혀 제한이 없는 것처럼 실행됩니다. 자동화 값을 출력에 적용할 때에만 위에 지정된 대로 제한됩니다.
N. p. setValueAtTime( 0 , 0 ); N. p. linearRampToValueAtTime( 4 , 1 ); N. p. linearRampToValueAtTime( 0 , 2 );
곡선의 초기 기울기는 4이며, 최댓값 1에 도달할 때까지 유지됩니다. 이 시점부터 출력은 일정하게 유지됩니다. 마지막으로 시간 2 부근에서 곡선의 기울기는 -4입니다. 아래 그래프에서 점선은 클리핑이 없었다면 발생했을 동작을 나타내고 실선은 명목 범위로 클리핑됨으로써 AudioParam에 실제로 예상되는 동작을 나타냅니다.
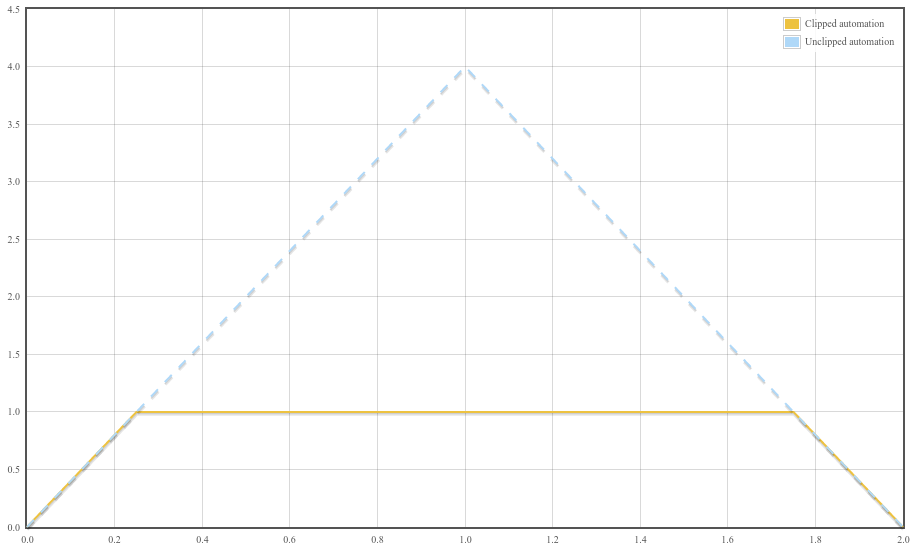
1.6.4.
AudioParam
자동화 예
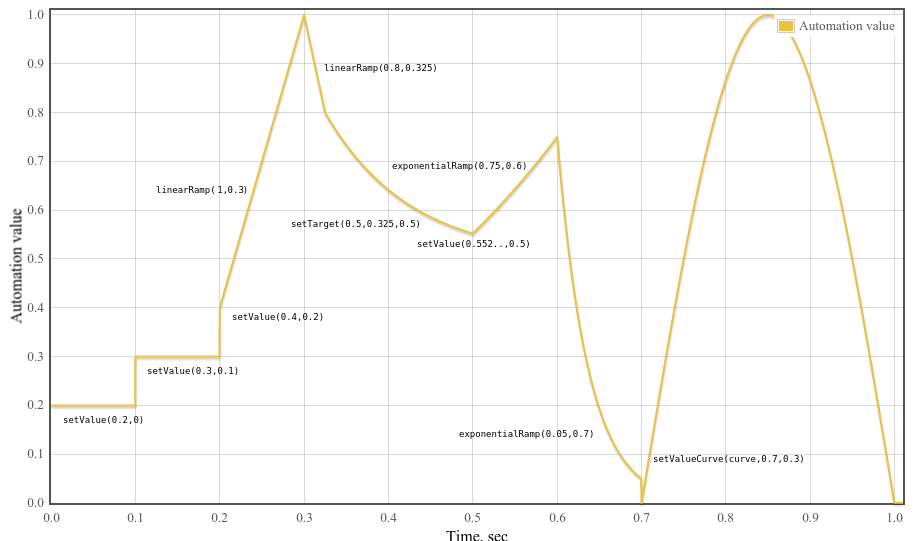
const curveLength= 44100 ; const curve= new Float32Array( curveLength); for ( const i= 0 ; i< curveLength; ++ i) curve[ i] = Math. sin( Math. PI* i/ curveLength); const t0= 0 ; const t1= 0.1 ; const t2= 0.2 ; const t3= 0.3 ; const t4= 0.325 ; const t5= 0.5 ; const t6= 0.6 ; const t7= 0.7 ; const t8= 1.0 ; const timeConstant= 0.1 ; param. setValueAtTime( 0.2 , t0); param. setValueAtTime( 0.3 , t1); param. setValueAtTime( 0.4 , t2); param. linearRampToValueAtTime( 1 , t3); param. linearRampToValueAtTime( 0.8 , t4); param. setTargetAtTime( .5 , t4, timeConstant); // 시간 t5에서 setTargetAtTime의 값이 어디에 있을지 계산하여 // 다음 지수 곡선이 올바른 지점에서 시작하고 // 점프 불연속이 없도록 합니다. 사양에 따르면 다음과 같습니다 // v(t) = 0.5 + (0.8 - 0.5)*exp(-(t-t4)/timeConstant) // 따라서 v(t5) = 0.5 + (0.8 - 0.5)*exp(-(t5-t4)/timeConstant) param. setValueAtTime( 0.5 + ( 0.8 - 0.5 ) * Math. exp( - ( t5- t4) / timeConstant), t5); param. exponentialRampToValueAtTime( 0.75 , t6); param. exponentialRampToValueAtTime( 0.05 , t7); param. setValueCurveAtTime( curve, t7, t8- t7);
1.7.
AudioScheduledSourceNode
인터페이스
이 인터페이스는 AudioBufferSourceNode,
ConstantSourceNode,
그리고
OscillatorNode와
같은 소스 노드의 공통 기능을 나타냅니다.
소스가 시작되기 전(start()
호출 전)에는
소스 노드가 반드시 무음(0)을 출력해야 합니다. 소스가 중지된 후(stop()
호출 후)에는
소스가 반드시 무음(0)을 출력해야 합니다.
AudioScheduledSourceNode는
직접 인스턴스화할 수 없으며, 대신 소스 노드의 구체적인 인터페이스가
이를 확장합니다.
AudioScheduledSourceNode는
연관된 BaseAudioContext의
currentTime이
AudioScheduledSourceNode가
시작하도록 설정된 시간보다 크거나 같고, 중지하도록 설정된 시간보다
작은 경우 재생 중이라고 합니다.
AudioScheduledSourceNode는
내부 불리언 슬롯 [[source started]]이
처음에 false로 설정된 상태로 생성됩니다.
[Exposed =Window ]interface AudioScheduledSourceNode :AudioNode {attribute EventHandler onended ;undefined start (optional double when = 0);undefined stop (optional double when = 0); };
1.7.1. 속성
onended, 유형은 EventHandler-
AudioScheduledSourceNode노드 유형에 디스패치되는ended이벤트 유형의 이벤트 핸들러를 설정하는 데 사용하는 속성입니다. 소스 노드가 재생을 중지하면(구체적인 노드에 의해 결정됨)Event인터페이스를 사용하는 이벤트가 이벤트 핸들러에 디스패치됩니다.모든
AudioScheduledSourceNode에서ended이벤트는stop()에 의해 결정된 중지 시간에 도달하면 디스패치됩니다.AudioBufferSourceNode의 경우duration에 도달하거나 전체buffer가 재생된 경우에도 이벤트가 디스패치됩니다.
1.7.2. 메서드
start(when)-
정확한 시간에 사운드가 재생되도록 예약합니다.
이 메서드가 호출되면 다음 단계를 실행합니다:-
이
AudioScheduledSourceNode의 내부 슬롯[[source started]]이 true이면InvalidStateError예외를 반드시 발생시켜야 합니다. -
아래에 설명된 매개변수 제약으로 인해 발생시켜야 하는 오류가 있는지 확인합니다. 이 단계에서 예외가 발생하면 해당 단계를 중단합니다.
-
이
AudioScheduledSourceNode의 내부 슬롯[[source started]]을true로 설정합니다. -
메시지에 매개변수 값을 포함하여
AudioScheduledSourceNode를 시작하도록 제어 메시지를 큐에 넣습니다. -
다음 조건을 모두 충족하는 경우에만 연관된
AudioContext에 렌더링 스레드 실행을 시작하도록 제어 메시지를 보냅니다:-
컨텍스트의
[[control thread state]]가 "suspended"입니다. -
컨텍스트가 시작할 수 있는 상태입니다.
-
[[suspended by user]]플래그가false입니다.
참고: 이를 통해
start()가 현재 시작할 수 있는 상태이지만 이전에 시작이 차단되었던AudioContext를 시작할 수 있습니다. -
AudioScheduledSourceNode.start(when) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 whendouble✘ ✔ when매개변수는 사운드가 어느 시간(초)에 재생을 시작해야 하는지를 나타냅니다.AudioContext의currentTime속성과 동일한 시간 좌표계를 사용합니다.AudioScheduledSourceNode가 방출하는 신호가 사운드의 시작 시간에 따라 달라지는 경우when의 정확한 값은 가장 가까운 샘플 프레임으로 반올림하지 않고 항상 사용됩니다. 이 값으로 0이 전달되거나 값이currentTime보다 작으면 사운드가 즉시 재생되기 시작합니다.when이 음수이면RangeError예외를 반드시 발생시켜야 합니다.반환 유형:undefined -
stop(when)-
정확한 시간에 사운드 재생이 중지되도록 예약합니다. 이미 호출된 후
stop이 다시 호출되면 마지막 호출만 적용되며, 이후 호출 전에 버퍼가 이미 중지된 경우가 아니라면 이전 호출에 의해 설정된 중지 시간은 적용되지 않습니다. 버퍼가 이미 중지된 경우 추가stop호출은 아무 효과가 없습니다. 예약된 시작 시간보다 먼저 중지 시간에 도달하면 사운드는 재생되지 않습니다.이 메서드가 호출되면 다음 단계를 실행합니다:-
이
AudioScheduledSourceNode의 내부 슬롯[[source started]]이true가 아니면InvalidStateError예외를 반드시 발생시켜야 합니다. -
아래에 설명된 매개변수 제약으로 인해 발생시켜야 하는 오류가 있는지 확인합니다.
-
메시지에 매개변수 값을 포함하여
AudioScheduledSourceNode를 중지하도록 제어 메시지를 큐에 넣습니다.
노드가AudioBufferSourceNode이면,AudioBufferSourceNode를 중지하도록 제어 메시지를 실행한다는 것은 재생 알고리즘에서handleStop()함수를 호출하는 것을 의미합니다.AudioScheduledSourceNode.stop(when) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 whendouble✘ ✔ when매개변수는 소스가 어느 시간(초)에 재생을 중지해야 하는지를 나타냅니다.AudioContext의currentTime속성과 동일한 시간 좌표계를 사용합니다. 이 값으로 0이 전달되거나 값이currentTime보다 작으면 사운드가 즉시 재생을 중지합니다.when이 음수이면RangeError예외를 반드시 발생시켜야 합니다.반환 유형:undefined -
1.8.
AnalyserNode
인터페이스
이 인터페이스는 실시간 주파수 및 시간 영역 분석 정보를 제공할 수 있는 노드를 나타냅니다. 오디오 스트림은 처리되지 않은 상태로 입력에서 출력으로 전달됩니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | 이 출력은 연결하지 않은 상태로 둘 수 있습니다. |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
[Exposed =Window ]interface AnalyserNode :AudioNode {constructor (BaseAudioContext ,context optional AnalyserOptions = {});options undefined getFloatFrequencyData (Float32Array );array undefined getByteFrequencyData (Uint8Array );array undefined getFloatTimeDomainData (Float32Array );array undefined getByteTimeDomainData (Uint8Array );array attribute unsigned long fftSize ;readonly attribute unsigned long frequencyBinCount ;attribute double minDecibels ;attribute double maxDecibels ;attribute double smoothingTimeConstant ; };
1.8.1. 생성자
AnalyserNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면, 사용자 에이전트는 context 및 options을 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.AnalyserNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새 AnalyserNode가 연관될BaseAudioContext입니다.optionsAnalyserOptions✘ ✔ 이 AnalyserNode의 선택적 초기 매개변수 값입니다.
1.8.2. 속성
fftSize, 유형은 unsigned long-
주파수 영역 분석에 사용하는 FFT의 크기(샘플 프레임 단위)입니다. 이는 반드시 32에서 32768 범위의 2의 거듭제곱이어야 하며, 그렇지 않으면
IndexSizeError예외를 반드시 발생시켜야 합니다. 기본값은 2048입니다. 큰 FFT 크기는 계산 비용이 많이 들 수 있다는 점에 유의하십시오.fftSize가 다른 값으로 변경되면 주파수 데이터의 평활화(getByteFrequencyData()및getFloatFrequencyData())와 관련된 모든 상태가 재설정됩니다. 즉, 시간에 따른 평활화에 사용되는 이전 블록 \(\hat{X}_{-1}[k]\)이 모든 \(k\)에 대해 0으로 설정됩니다.fftSize를 늘리면 현재 시간 영역 데이터가 이전에는 포함하지 않았던 과거 프레임을 포함하도록 확장되어야 합니다. 이는AnalyserNode가 실질적으로 최근 32768개의 샘플 프레임을 유지해야 하며, 현재 시간 영역 데이터는 그중 가장 최근의fftSize샘플 프레임이라는 의미입니다. frequencyBinCount, 유형은 unsigned long, 읽기 전용-
FFT 크기의 절반입니다.
maxDecibels, 유형은 double-
maxDecibels는 FFT 분석 데이터를 부호 없는 바이트 값으로 변환하기 위한 스케일링 범위의 최대 전력 값입니다. 기본값은 -30입니다. 이 속성 값이minDecibels보다 작거나 같은 값으로 설정되면IndexSizeError예외를 반드시 발생시켜야 합니다. minDecibels, 유형은 double-
minDecibels는 FFT 분석 데이터를 부호 없는 바이트 값으로 변환하기 위한 스케일링 범위의 최소 전력 값입니다. 기본값은 -100입니다. 이 속성 값이maxDecibels보다 크거나 같은 값으로 설정되면IndexSizeError예외를 반드시 발생시켜야 합니다. smoothingTimeConstant, 유형은 double-
0에서 1 사이의 값으로, 0은 마지막 분석 프레임과의 시간 평균을 사용하지 않음을 나타냅니다. 기본값은 0.8입니다. 이 속성 값이 0보다 작거나 1보다 큰 값으로 설정되면
IndexSizeError예외를 반드시 발생시켜야 합니다.
1.8.3. 메서드
getByteFrequencyData(array)-
쓰기를 사용하여 현재 주파수 데이터를 array에 씁니다. 만약 array의 바이트 길이가
frequencyBinCount보다 작으면, 초과 요소는 삭제됩니다. 만약 array의 바이트 길이가frequencyBinCount보다 크면, 초과 요소는 무시됩니다. 가장 최근의fftSize프레임이 주파수 데이터를 계산하는 데 사용됩니다.이전 호출과 동일한 렌더 퀀텀 안에서
getByteFrequencyData()또는getFloatFrequencyData()가 다시 호출되면 현재 주파수 데이터는 동일한 데이터로 업데이트되지 않습니다. 대신 이전에 계산된 데이터가 반환됩니다.부호 없는 바이트 배열에 저장되는 값은 다음과 같이 계산됩니다. 현재 주파수 데이터를 FFT 윈도잉 및 평활화에 설명된 \(Y[k]\)라고 둡니다. 그러면 바이트 값 \(b[k]\)는
$$
    b[k] = \left\lfloor
            \frac{255}{\mbox{dB}_{max} - \mbox{dB}_{min}}
            \left(Y[k] - \mbox{dB}_{min}\right)
        \right\rfloor
$$
여기서 \(\mbox{dB}_{min}\)은
minDecibels이고 \(\mbox{dB}_{max}\)는maxDecibelsAnalyserNode.getByteFrequencyData() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 arrayUint8Array✘ ✘ 주파수 영역 분석 데이터가 복사될 위치입니다. 반환 유형:undefined getByteTimeDomainData(array)-
현재 시간 영역 데이터(파형 데이터)를 array에 씁니다. array의 바이트 길이가
fftSize보다 작으면 초과 요소는 버려집니다. array의 바이트 길이가fftSize보다 크면 초과 요소는 무시됩니다. 가장 최근의fftSize프레임이 바이트 데이터 계산에 사용됩니다.부호 없는 바이트 배열에 저장되는 값은 다음과 같이 계산됩니다. \(x[k]\)를 시간 영역 데이터라고 둡니다. 그러면 바이트 값 \(b[k]\)는
$$
    b[k] = \left\lfloor 128(1 + x[k]) \right\rfloor.
$$
\(b[k]\)가 0에서 255 범위를 벗어나면 해당 범위 안으로 클리핑됩니다.
AnalyserNode.getByteTimeDomainData() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 arrayUint8Array✘ ✘ 시간 영역 샘플 데이터가 복사될 위치입니다. 반환 유형:undefined getFloatFrequencyData(array)-
현재 주파수 데이터를 array에 씁니다. array의 요소 수가
frequencyBinCount보다 적으면 초과 요소는 버려집니다. array의 요소 수가frequencyBinCount보다 많으면 초과 요소는 무시됩니다. 가장 최근의fftSize프레임이 주파수 데이터 계산에 사용됩니다.이전 호출과 동일한 렌더 퀀텀 안에서
getFloatFrequencyData()또는getByteFrequencyData()가 다시 호출되면 현재 주파수 데이터는 동일한 데이터로 업데이트되지 않습니다. 대신 이전에 계산된 데이터가 반환됩니다.주파수 데이터의 단위는 dB입니다.
AnalyserNode.getFloatFrequencyData() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 arrayFloat32Array✘ ✘ 주파수 영역 분석 데이터가 복사될 위치입니다. 반환 유형:undefined getFloatTimeDomainData(array)-
현재 시간 영역 데이터(파형 데이터)를 array에 씁니다. array의 요소 수가
fftSize값보다 적으면 초과 요소는 버려집니다. array의 요소 수가fftSize값보다 많으면 초과 요소는 무시됩니다. 가장 최근의fftSize프레임이 다운 믹싱 후 기록됩니다.AnalyserNode.getFloatTimeDomainData() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 arrayFloat32Array✘ ✘ 시간 영역 샘플 데이터가 복사될 위치입니다. 반환 유형:undefined
1.8.4.
AnalyserOptions
이는 AnalyserNode를
생성할 때 사용할 옵션을 지정합니다.
모든 멤버는 선택 사항이며, 지정하지 않으면 일반적인 기본값을 사용하여
노드를 생성합니다.
dictionary AnalyserOptions :AudioNodeOptions {unsigned long fftSize = 2048;double maxDecibels = -30;double minDecibels = -100;double smoothingTimeConstant = 0.8; };
1.8.4.1.
AnalyserOptions
딕셔너리 멤버
fftSize, 유형은 unsigned long, 기본값은2048-
주파수 영역 분석에 사용할 FFT의 원하는 초기 크기입니다.
maxDecibels, 유형은 double, 기본값은-30-
FFT 분석을 위한 원하는 초기 최대 전력(dB)입니다.
minDecibels, 유형은 double, 기본값은-100-
FFT 분석을 위한 원하는 초기 최소 전력(dB)입니다.
smoothingTimeConstant, 유형은 double, 기본값은0.8-
FFT 분석을 위한 원하는 초기 평활화 상수입니다.
1.8.5. 시간 영역 다운 믹싱
현재
시간 영역 데이터를 계산할 때 입력 신호는
channelCount가
1이고, channelCountMode가
"max"이며,
channelInterpretation이
"speakers"인
것처럼 모노로 다운 믹싱해야 합니다.
이는 AnalyserNode
자체의 설정과는 무관합니다. 가장 최근의
fftSize
프레임이 다운 믹싱 작업에 사용됩니다.
1.8.6. FFT 윈도잉 및 시간에 따른 평활화
현재 주파수 데이터를 계산할 때 다음 작업을 수행해야 합니다:
-
현재 시간 영역 데이터를 계산합니다.
-
시간 영역 입력 데이터에 Blackman 윈도우를 적용합니다.
-
윈도우가 적용된 시간 영역 입력 데이터에 푸리에 변환을 적용하여 실수 및 허수 주파수 데이터를 얻습니다.
-
주파수 영역 데이터를 시간에 따라 평활화합니다.
다음에서 \(N\)을 이 AnalyserNode의
fftSize
속성 값으로 둡니다.
$$
\begin{align*}
    \alpha &= \mbox{0.16} \\ a_0 &= \frac{1-\alpha}{2} \\
    a_1 &= \frac{1}{2} \\
    a_2 &= \frac{\alpha}{2} \\
    w[n] &= a_0 - a_1 \cos\frac{2\pi n}{N} + a_2 \cos\frac{4\pi n}{N}, \mbox{ for } n = 0, \ldots, N - 1
\end{align*}
$$
윈도우가 적용된 신호 \(\hat{x}[n]\)은 다음과 같습니다
$$
    \hat{x}[n] = x[n] w[n], \mbox{ for } n = 0, \ldots, N - 1
$$
$$
    X[k] = \frac{1}{N} \sum_{n = 0}^{N - 1} \hat{x}[n]\, W^{-kn}_{N}
$$
\(W_N = e^{2\pi i/N}\)일 때 \(k = 0, \dots, N/2-1\)입니다.
-
\(\hat{X}_{-1}[k]\)를 이전 블록에 대한 이 작업의 결과로 둡니다. 이전 블록은 이전 시간에 따른 평활화 작업으로 계산된 버퍼이거나, 처음으로 시간에 따라 평활화하는 경우 \(N\)개의 0으로 구성된 배열로 정의됩니다.
-
\(\tau\)를 이
AnalyserNode의smoothingTimeConstant속성 값으로 둡니다. -
\(X[k]\)를 현재 블록에 푸리에 변환을 적용한 결과로 둡니다.
그러면 평활화된 값 \(\hat{X}[k]\)는 다음과 같이 계산됩니다
$$
    \hat{X}[k] = \tau\, \hat{X}_{-1}[k] + (1 - \tau)\, \left|X[k]\right|
$$
-
\(\hat{X}[k]\)가
NaN, 양의 무한대 또는 음의 무한대이면 \(\hat{X}[k]\) = 0으로 설정합니다.
\(k = 0, \ldots, N - 1\)에 대해 적용합니다.
$$
    Y[k] = 20\log_{10}\hat{X}[k]
$$
\(k = 0, \ldots, N-1\)에 대해 적용합니다.
이 배열 \(Y[k]\)는
getFloatFrequencyData()의
출력 배열로 복사됩니다.
getByteFrequencyData()의
경우 \(Y[k]\)는 minDecibels와
maxDecibelsminDecibels는
값 0으로 나타내고
maxDecibels
1.9.
AudioBufferSourceNode
인터페이스
이 인터페이스는 AudioBuffer의
메모리 내 오디오 자산에서 가져온 오디오 소스를 나타냅니다.
높은 수준의 스케줄링 유연성과 정확성이 필요한 오디오 자산을
재생하는 데 유용합니다. 네트워크 또는 디스크 기반 자산의
샘플 정확도 재생이 필요한 경우 구현자는 AudioWorkletNode를
사용하여 재생을 구현해야 합니다.
start()
메서드는 사운드 재생이 발생할 시점을 예약하는 데 사용됩니다.
start()
메서드는 여러 번 호출할 수 없습니다.
loop
속성이 false인 경우 버퍼의 오디오 데이터가 모두 재생되면
재생이 자동으로 중지되거나, stop()
메서드가 호출되고 지정된 시간에 도달하면 재생이 중지됩니다.
자세한 내용은 start()
및 stop()
설명을 참조하십시오.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
출력의 채널 수는 buffer
속성에 할당된 AudioBuffer의 채널 수와 같으며,
buffer가
null이면 무음인 하나의 채널입니다.
또한 버퍼에 둘 이상의 채널이 있는 경우 다음 조건 중 하나가
충족되는 시점 이후 렌더 퀀텀의 시작에서 AudioBufferSourceNode
출력은 반드시 무음인 단일 채널로 변경되어야 합니다:
AudioBufferSourceNode의
재생 헤드 위치는
버퍼의 첫 번째 샘플 프레임의 시간 좌표를 기준으로 한 초 단위의
시간 오프셋을 나타내는 임의의 양으로 정의됩니다.
이러한 값은 노드의 playbackRate 및 detune
매개변수와 독립적으로 고려해야 합니다.
일반적으로 재생 헤드 위치는 서브샘플 정확도를 가질 수 있으며
정확한 샘플 프레임 위치를 가리킬 필요가 없습니다.
0과 버퍼의 지속 시간 사이의 유효한 값을 가질 수 있습니다.
playbackRate
및 detune
속성은 복합 매개변수를 구성합니다.
이들은 함께 사용되어 computedPlaybackRate 값을 결정합니다:
computedPlaybackRate(t) = playbackRate(t) * pow(2, detune(t) / 1200)
이 복합 매개변수의 명목 범위는 \((-\infty, \infty)\)입니다.
AudioBufferSourceNode는
내부 불리언 슬롯 [[buffer set]]이 처음에
false로 설정된 상태로 생성됩니다.
[Exposed =Window ]interface AudioBufferSourceNode :AudioScheduledSourceNode {constructor (BaseAudioContext ,context optional AudioBufferSourceOptions = {});options attribute AudioBuffer ?buffer ;readonly attribute AudioParam playbackRate ;readonly attribute AudioParam detune ;attribute boolean loop ;attribute double loopStart ;attribute double loopEnd ;undefined start (optional double when = 0,optional double offset ,optional double duration ); };
1.9.1. 생성자
AudioBufferSourceNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면, 사용자 에이전트는 context 및 options을 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.AudioBufferSourceNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새 AudioBufferSourceNode가 연관될BaseAudioContext입니다.optionsAudioBufferSourceOptions✘ ✔ 이 AudioBufferSourceNode의 선택적 초기 매개변수 값입니다.
1.9.2. 속성
buffer, 유형은 AudioBuffer, 널 허용-
재생할 오디오 자산을 나타냅니다.
buffer속성을 설정하려면 다음 단계를 실행합니다:-
new buffer를
AudioBuffer또는buffer에 할당할null값으로 둡니다. -
new buffer가
null이 아니고[[buffer set]]이 true이면InvalidStateError를 발생시키고 이 단계를 중단합니다. -
new buffer가
null이 아니면[[buffer set]]을 true로 설정합니다. -
new buffer를
buffer속성에 할당합니다.
-
detune, 유형은 AudioParam, 읽기 전용-
오디오 스트림이 렌더링되는 속도를 변조하기 위한 센트 단위의 추가 매개변수입니다. 이 매개변수는
playbackRate와 함께 복합 매개변수를 구성하여 computedPlaybackRate를 형성합니다.매개변수 값 참고 defaultValue0 minValue가장 작은 음의 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 큰 양의 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" k-rate"자동화 레이트 제약 조건이 있음 loop, 유형은 boolean-
loopStart및loopEnd로 지정된 오디오 데이터 영역을 루프에서 계속 재생해야 하는지를 나타냅니다. 기본값은false입니다. loopEnd, 유형은 double-
loop속성이 true일 때 루프가 끝나야 하는 선택적 재생 헤드 위치입니다. 그 값은 루프 콘텐츠에 포함되지 않습니다. 기본value는 0이며, 0과 버퍼 지속 시간 사이의 어떤 값으로든 유용하게 설정할 수 있습니다.loopEnd가 0보다 작거나 같거나,loopEnd가 버퍼 지속 시간보다 크면 루프는 버퍼의 끝에서 종료됩니다. loopStart, 유형은 double-
loop속성이 true일 때 루프가 시작되어야 하는 선택적 재생 헤드 위치입니다. 기본value는 0이며, 0과 버퍼 지속 시간 사이의 어떤 값으로든 유용하게 설정할 수 있습니다.loopStart가 0보다 작으면 루프는 0에서 시작됩니다.loopStart가 버퍼 지속 시간보다 크면 루프는 버퍼의 끝에서 시작됩니다. playbackRate, 유형은 AudioParam, 읽기 전용-
오디오 스트림을 렌더링할 속도입니다. 이는
detune과 함께 복합 매개변수를 구성하여 computedPlaybackRate를 형성합니다.매개변수 값 참고 defaultValue1 minValue가장 작은 음의 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 큰 양의 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" k-rate"자동화 레이트 제약 조건이 있음
1.9.3. 메서드
start(when, offset, duration)-
정확한 시간에 사운드 재생을 예약합니다.
이 메서드가 호출되면 다음 단계를 실행합니다:-
이
AudioBufferSourceNode의 내부 슬롯[[source started]]가true이면InvalidStateError예외를 반드시 발생시켜야 합니다. -
아래에 설명된 매개변수 제약으로 인해 발생시켜야 하는 오류가 있는지 확인합니다. 이 단계에서 예외가 발생하면 이 단계들을 중단합니다.
-
이
AudioBufferSourceNode의 내부 슬롯[[source started]]를true로 설정합니다. -
AudioBufferSourceNode를 시작하도록 제어 메시지를 큐에 넣고, 메시지에 매개변수 값을 포함합니다. -
buffer가 설정되어 있으면buffer의 콘텐츠를 획득합니다. -
다음 조건이 모두 충족되는 경우에만 연관된
AudioContext에 제어 메시지를 보내 렌더링 스레드 실행을 시작하도록 합니다:-
컨텍스트의
[[control thread state]]가suspended입니다. -
컨텍스트가 시작할 수 있는 상태입니다.
-
[[suspended by user]]플래그가false입니다.
참고: 이를 통해
start()가 현재 시작할 수 있는 상태이지만 이전에 시작이 차단되었던AudioContext를 시작할 수 있습니다. -
AudioBufferSourceNode.start(when, offset, duration) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 whendouble✘ ✔ when매개변수는 사운드가 재생을 시작해야 하는 시간(초)을 설명합니다. 이는AudioContext의currentTime속성과 동일한 시간 좌표계를 사용합니다. 이 값에 0을 전달하거나 값이 currentTime보다 작으면 사운드가 즉시 재생되기 시작합니다.when이 음수이면RangeError예외를 반드시 발생시켜야 합니다.offsetdouble✘ ✔ offset매개변수는 재생을 시작할 재생 헤드 위치를 제공합니다. 이 값에 0을 전달하면 버퍼의 처음부터 재생을 시작합니다.offset이 음수이면RangeError예외를 반드시 발생시켜야 합니다.offset이loopEnd보다 크고,playbackRate가 양수 또는 0이며loop가true이면loopEnd에서 재생이 시작됩니다.offset이loopStart보다 크고,playbackRate가 음수이며loop가true이면loopStart에서 재생이 시작됩니다.startTime에 도달하면offset은 알림 없이 [0,duration]으로 제한되며, 여기서duration은 이AudioBufferSourceNode의buffer속성에 설정된AudioBuffer의duration속성 값입니다.durationdouble✘ ✔ duration매개변수는 재생할 사운드의 지속 시간을 설명하며, 전체 또는 부분적인 루프 반복을 포함하여 출력할 총 버퍼 콘텐츠의 초 단위로 표현됩니다.duration의 단위는playbackRate의 영향과 무관합니다. 예를 들어 재생 속도가 0.5이고duration이 5초이면 5초 분량의 버퍼 콘텐츠가 절반 속도로 출력되어 10초의 가청 출력을 생성합니다.duration이 음수이면RangeError예외를 반드시 발생시켜야 합니다.반환 유형:undefined -
1.9.4.
AudioBufferSourceOptions
이는 AudioBufferSourceNode를
생성할 때 사용할 옵션을 지정합니다.
모든 멤버는 선택 사항이며,
지정하지 않으면 노드를 생성할 때 일반적인 기본값이
사용됩니다.
dictionary AudioBufferSourceOptions {AudioBuffer ?buffer ;float detune = 0;boolean loop =false ;double loopEnd = 0;double loopStart = 0;float playbackRate = 1; };
1.9.4.1.
AudioBufferSourceOptions
딕셔너리 멤버
buffer, 유형은 AudioBuffer, 널 허용-
재생할 오디오 자산입니다. 이는
buffer를AudioBufferSourceNode의buffer속성에 할당하는 것과 같습니다. detune, 유형은 float, 기본값은0-
detuneAudioParam의 초기값입니다. loop, 유형은 boolean, 기본값은false-
loop속성의 초기값입니다. loopEnd, 유형은 double, 기본값은0-
loopEnd속성의 초기값입니다. loopStart, 유형은 double, 기본값은0-
loopStart속성의 초기값입니다. playbackRate, 유형은 float, 기본값은1-
playbackRateAudioParam의 초기값입니다.
1.9.5. 루핑
이 절은 비규범적입니다. 규범적 요구 사항은 재생 알고리즘을 참조하십시오.
loop
속성을 true로 설정하면
끝점 loopStart
및 loopEnd로
정의된 버퍼 영역의 어떤 부분이라도 재생된 후에는
해당 영역의 재생이 무기한 계속됩니다. loop가
true인 동안
루프 재생은 다음 중 하나가 발생할 때까지 계속됩니다:
루프 본문은 loopStart부터
loopEnd를
포함하지 않는 지점까지의 영역을 차지하는 것으로 간주됩니다.
루프 영역의 재생 방향은 노드 재생 속도의 부호를 따릅니다.
양의 재생 속도에서는 loopStart에서
loopEnd까지
루핑되며, 음의 재생 속도에서는 loopEnd에서
loopStart까지
루핑됩니다.
루핑은 start()의
offset 인수 해석에 영향을 주지 않습니다.
재생은 항상 요청된 오프셋에서 시작되며,
재생 중 루프 본문에 도달한 뒤에만 루핑이 시작됩니다.
실제 루프 시작점과 끝점은 아래 알고리즘에 지정된 대로
0과 버퍼 지속 시간 사이의 범위에 있어야 합니다. loopEnd에는
추가로 loopStart와
같거나 그 이후여야 한다는 제약이 있습니다.
이러한 제약 중 하나라도 위반되면 루프는 전체 버퍼 콘텐츠를
포함하는 것으로 간주됩니다.
루프 끝점은 서브샘플 정확도를 가집니다. 끝점이 정확한 샘플 프레임 오프셋에 위치하지 않거나 재생 속도가 1이 아닌 경우, 루프 오디오가 버퍼의 연속된 비루프 영역에 있는 것처럼 루프의 시작과 끝을 이어 붙이도록 재생을 보간합니다.
루프 관련 속성은 버퍼 재생 중 변경할 수 있으며, 일반적으로 다음 렌더 퀀텀부터 적용됩니다. 정확한 결과는 이어지는 규범적 재생 알고리즘에서 정의합니다.
loopStart
및 loopEnd
속성의 기본값은 모두 0입니다. loopEnd
값 0은 버퍼 길이와 동일하므로
기본 끝점에서는 전체 버퍼가 루프에 포함됩니다.
루프 끝점의 값은 버퍼의 샘플 레이트를 기준으로 한 시간
오프셋으로 표현되므로, 이러한 값은 재생 중 동적으로
변경될 수 있는 노드의 playbackRate
매개변수와 독립적입니다.
1.9.6. AudioBuffer 콘텐츠 재생
이 규범적 절에서는 다음 요소들이 함께 작용하여 재생에 영향을 준다는 점을 고려하여 버퍼 콘텐츠의 재생을 규정합니다:
-
서브샘플 정밀도로 표현할 수 있는 시작 오프셋.
-
서브샘플 정밀도로 표현할 수 있고 재생 중 동적으로 변경될 수 있는 루프 지점.
-
재생 속도 및 디튠 매개변수. 이들은 결합되어 양수 또는 음수가 될 수 있는 유한 값을 가지는 단일 computedPlaybackRate를 생성합니다.
AudioBufferSourceNode에서
출력을 생성하기 위해 내부적으로 따라야 하는 알고리즘은
다음 원칙을 따릅니다:
-
출력의 효율성이나 품질을 높이기 위해 UA는 원하는 어느 지점에서든 임의로 버퍼를 리샘플링할 수 있습니다.
-
서브샘플 시작 오프셋 또는 루프 지점에서는 샘플 프레임 사이에 추가 보간이 필요할 수 있습니다.
-
루프 버퍼의 재생은 보간으로 인한 영향을 제외하면 루프 오디오 콘텐츠가 연속해서 나타나는 비루프 버퍼와 동일하게 동작해야 합니다.
알고리즘의 설명은 다음과 같습니다:
let buffer; // 이 노드에서 사용하는 AudioBuffer let context; // 이 노드에서 사용하는 AudioContext // 다음 변수들은 노드의 속성 및 AudioParam 값을 보관합니다. // process()를 호출할 때마다 그 전에 k-rate 기준으로 업데이트됩니다. let loop; let detune; let loopStart; let loopEnd; let playbackRate; // 노드의 재생 매개변수를 위한 변수 let start= 0 , offset= 0 , duration= Infinity ; // start()에서 설정 let stop= Infinity ; // stop()에서 설정 // 노드의 재생 상태를 추적하기 위한 변수 let bufferTime= 0 , started= false , enteredLoop= false ; let bufferTimeElapsed= 0 ; let dt= 1 / context. sampleRate; // start 메서드 호출을 처리합니다 function handleStart( when, pos, dur) { if ( arguments. length>= 1 ) { start= when; } offset= pos; if ( arguments. length>= 3 ) { duration= dur; } } // stop 메서드 호출을 처리합니다 function handleStop( when) { if ( arguments. length>= 1 ) { stop= when; } else { stop= context. currentTime; } } // 특정 샘플 프레임에 대한 다중 채널 신호 값을 보간합니다. // 신호 값 배열을 반환합니다. function playbackSignal( position) { /* 이 함수는 buffer의 재생 신호 함수를 제공하며, 이는 재생 헤드 위치를 각 출력 채널마다 하나씩 존재하는 출력 신호 값 집합에 매핑하는 함수입니다. |position|이 버퍼의 정확한 샘플 프레임 위치에 해당하면 이 함수는 해당 프레임을 반환합니다. 그렇지 않으면 반환값은 |position| 주변의 샘플 프레임을 보간하는 UA 제공 알고리즘에 의해 결정됩니다. |position|이 |loopEnd|보다 크거나 같고 버퍼에 이어지는 샘플 프레임이 없다면 보간은 |loopStart|에서 시작하는 후속 프레임 시퀀스를 기반으로 해야 합니다. */ ... } // output으로 정의된 채널 배열에 배치할 오디오의 // 단일 렌더 퀀텀을 생성합니다. 출력할 // |numberOfFrames|개의 샘플 프레임 배열을 반환합니다. function process( numberOfFrames) { let currentTime= context. currentTime; // 다음에 렌더링될 프레임의 컨텍스트 시간 const output= []; // 렌더링된 샘플 프레임을 누적합니다 // 재생 속도에 영향을 주는 두 k-rate 매개변수를 결합합니다 const computedPlaybackRate= playbackRate* Math. pow( 2 , detune/ 1200 ); // 적용 가능한 루프 끝점을 결정합니다 let actualLoopStart, actualLoopEnd; if ( loop&& buffer!= null ) { if ( loopStart>= 0 && loopEnd> 0 && loopStart< loopEnd) { actualLoopStart= loopStart; actualLoopEnd= Math. min( loopEnd, buffer. duration); } else { actualLoopStart= 0 ; actualLoopEnd= buffer. duration; } } else { // loop 플래그가 false이면 루프에 진입했다는 기록을 모두 제거합니다 enteredLoop= false ; } // null 버퍼의 경우를 처리합니다 if ( buffer== null ) { stop= currentTime; // 모든 시간에 대해 출력을 강제로 0으로 설정합니다 } // 퀀텀의 각 샘플 프레임을 렌더링합니다 for ( let index= 0 ; index< numberOfFrames; index++ ) { // currentTime과 bufferTimeElapsed가 재생에 // 허용되는 범위 내에 있는지 확인합니다 if ( currentTime< start|| currentTime>= stop|| bufferTimeElapsed>= duration) { output. push( 0 ); // 이 샘플 프레임은 무음입니다 currentTime+= dt; continue ; } if ( ! started) { // 버퍼가 재생을 시작했음을 기록하고 초기 // 재생 헤드 위치를 가져옵니다. if ( loop&& computedPlaybackRate>= 0 && offset>= actualLoopEnd) { offset= actualLoopEnd; } if ( computedPlaybackRate< 0 && loop&& offset< actualLoopStart) { offset= actualLoopStart; } bufferTime= offset; started= true ; } // 루프 관련 계산을 처리합니다 if ( loop) { // 루프 구간에 처음 진입했는지 확인합니다 if ( ! enteredLoop) { if ( offset< actualLoopEnd&& bufferTime>= actualLoopStart) { // 재생이 루프 전 또는 루프 안에서 시작되었고 재생 헤드는 // 이제 루프 시작점을 지났습니다 enteredLoop= true ; } if ( offset>= actualLoopEnd&& bufferTime< actualLoopEnd) { // 재생이 루프 뒤에서 시작되었고 재생 헤드는 이제 // 루프 끝점 이전에 있습니다 enteredLoop= true ; } } // 필요한 경우 루프 반복을 래핑합니다. enteredLoop가 // 앞의 조건문 안에서 true가 될 수 있다는 점에 유의하십시오. if ( enteredLoop) { while ( bufferTime>= actualLoopEnd) { bufferTime-= actualLoopEnd- actualLoopStart; } while ( bufferTime< actualLoopStart) { bufferTime+= actualLoopEnd- actualLoopStart; } } } if ( bufferTime>= 0 && bufferTime< buffer. duration) { output. push( playbackSignal( bufferTime)); } else { output. push( 0 ); // 버퍼 끝을 지났으므로 무음 프레임을 출력합니다 } bufferTime+= dt* computedPlaybackRate; bufferTimeElapsed+= dt* computedPlaybackRate; currentTime+= dt; } // 렌더 퀀텀 루프의 끝 if ( currentTime>= stop) { // 이 노드의 재생 상태를 종료합니다. process()는 더 이상 호출되지 않습니다. // 출력 채널 수를 1로 설정하도록 변경을 예약합니다. } return output; }
다음 비규범적 그림들은 여러 주요 시나리오에서 알고리즘의 동작을 보여 줍니다. 버퍼의 동적 리샘플링은 고려하지 않지만, 루프 위치의 시간이 변경되지 않는 한 결과 재생에 실질적인 영향을 주지 않습니다. 모든 그림에는 다음 규칙이 적용됩니다:
-
컨텍스트 샘플 레이트는 1000 Hz입니다
-
AudioBuffer콘텐츠는 첫 번째 샘플 프레임이 x 원점에 위치하도록 표시됩니다. -
출력 신호는 시간
start에 위치한 샘플 프레임이 x 원점에 오도록 표시됩니다. -
전체적으로 선형 보간이 표시되지만 UA는 다른 보간 기법을 사용할 수도 있습니다.
-
그림에 표시된
duration값은start()의 인수가 아니라buffer를 가리킵니다.
이 그림은 버퍼의 기본 재생과 버퍼의 마지막 샘플 프레임 뒤에서 끝나는 단순한 루프를 보여 줍니다:
AudioBufferSourceNode
기본 재생
이 그림은 playbackRate 보간을 보여 주며,
버퍼 콘텐츠가 절반 속도로 재생되어 출력 샘플 프레임 두 개 중 하나가
보간되는 모습을 나타냅니다. 특히 주목할 점은 루프 출력의 마지막
샘플 프레임으로, 루프 시작점을 사용하여 보간됩니다:
AudioBufferSourceNode
playbackRate 보간
이 그림은 샘플 레이트 보간을 보여 줍니다. 버퍼의 샘플 레이트가 컨텍스트 샘플 레이트의 50%이므로 버퍼와 컨텍스트 사이의 샘플 레이트 차이를 보정하는 계산된 재생 속도 0.5가 생성됩니다. 결과 출력은 앞의 예와 동일하지만 원인은 다릅니다.
AudioBufferSourceNode
샘플 레이트 보간.
이 그림은 버퍼 내 오프셋이 정확히 샘플 프레임의 절반에서 시작하는 서브샘플 오프셋 재생을 보여 줍니다. 따라서 모든 출력 프레임이 보간됩니다:
AudioBufferSourceNode
서브샘플 오프셋 재생
이 그림은 서브샘플 루프 재생을 보여 주며, 루프 끝점의 소수 프레임 오프셋이 정확한 샘플 프레임을 참조하는 것처럼 해당 오프셋을 반영하는 버퍼의 보간 데이터 지점에 매핑되는 방식을 보여 줍니다:
AudioBufferSourceNode
서브샘플 루프 재생
1.10.
AudioDestinationNode
인터페이스
이는 최종 오디오 대상을 나타내며 사용자가 궁극적으로 듣게 되는
AudioNode입니다.
흔히 스피커에 연결된 오디오 출력 장치로
생각할 수 있습니다. 들리도록 렌더링된 모든 오디오는
AudioContext의
라우팅 그래프에서 "종단" 노드인 이 노드로 라우팅됩니다.
각 AudioContext에는
AudioDestinationNode가 하나만 있으며,
AudioContext의
destination 속성을 통해 제공됩니다.
AudioDestinationNode의
출력은 입력을 합산하여 생성되므로,
예를 들어 AudioContext의
출력을 MediaStreamAudioDestinationNode
또는 MediaRecorder
([mediastream-recording]에 설명되어 있습니다)로
캡처할 수 있습니다.
AudioDestinationNode는
AudioContext
또는 OfflineAudioContext의
대상일 수 있으며, 채널 속성은 어떤 컨텍스트인지에 따라 달라집니다.
AudioContext의
기본값은 다음과 같습니다
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "explicit"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
channelCount는
maxChannelCount보다
작거나 같은 어떤 값으로도 설정할 수 있습니다.
이 값이 유효 범위 내에 있지 않으면
IndexSizeError
예외를 반드시 발생시켜야 합니다. 구체적인 예로,
오디오 하드웨어가 8채널 출력을 지원한다면 channelCount를
8로 설정하고 8채널의 출력을 렌더링할 수 있습니다.
OfflineAudioContext의
기본값은 다음과 같습니다
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| numberOfChannels | |
channelCountMode
| "explicit"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
여기서 numberOfChannels는 OfflineAudioContext를
생성할 때 지정한 채널 수입니다.
이 값은 변경할 수 없으며, channelCount를
다른 값으로 변경하면
NotSupportedError
예외를 반드시 발생시켜야 합니다.
[Exposed =Window ]interface AudioDestinationNode :AudioNode {readonly attribute unsigned long maxChannelCount ; };
1.10.1. 속성
maxChannelCount, 유형은 unsigned long, 읽기 전용-
channelCount속성에 설정할 수 있는 최대 채널 수입니다. 오디오 하드웨어 엔드포인트(일반적인 경우)를 나타내는AudioDestinationNode는 오디오 하드웨어가 다중 채널인 경우 2개보다 많은 오디오 채널을 출력할 수도 있습니다.maxChannelCount는 이 하드웨어가 지원할 수 있는 최대 채널 수입니다.
1.11.
AudioListener
인터페이스
이 인터페이스는 오디오 장면을 듣는 사람의 위치와 방향을
나타냅니다. 모든 PannerNode
객체는
BaseAudioContext의
listener를
기준으로 공간화됩니다.
공간화에 관한 자세한 내용은 § 6 공간화/패닝을
참조하십시오.
positionX,
positionY,
및 positionZ
매개변수는
3D 데카르트 좌표 공간에서 리스너의 위치를 나타냅니다.
PannerNode
객체는 개별 오디오 소스를 기준으로 이 위치를 사용하여
공간화합니다.
forwardX,
forwardY,
및 forwardZ
매개변수는
3D 공간의 방향 벡터를 나타냅니다. forward 벡터와
up 벡터는 모두 리스너의 방향을 결정하는 데
사용됩니다. 사람을 기준으로 쉽게 설명하면 forward 벡터는
사람의 코가 가리키는 방향을 나타냅니다.
up 벡터는 사람의 머리 위쪽이
가리키는 방향을 나타냅니다. 이 두 벡터는 선형적으로
독립적이어야 합니다. 이러한 값을 해석하는 방법에 관한 규범적 요구 사항은
§ 6 공간화/패닝 절을 참조하십시오.
[Exposed =Window ]interface AudioListener {readonly attribute AudioParam positionX ;readonly attribute AudioParam positionY ;readonly attribute AudioParam positionZ ;readonly attribute AudioParam forwardX ;readonly attribute AudioParam forwardY ;readonly attribute AudioParam forwardZ ;readonly attribute AudioParam upX ;readonly attribute AudioParam upY ;readonly attribute AudioParam upZ ;undefined setPosition (float ,x float ,y float );z undefined setOrientation (float ,x float ,y float ,z float ,xUp float ,yUp float ); };zUp
1.11.1. 속성
forwardX, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 리스너가 향하는 전방 방향의 x 좌표 성분을 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate" forwardY, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 리스너가 향하는 전방 방향의 y 좌표 성분을 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate" forwardZ, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 리스너가 향하는 전방 방향의 z 좌표 성분을 설정합니다.
매개변수 값 참고 defaultValue-1 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate" positionX, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 오디오 리스너의 x 좌표 위치를 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate" positionY, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 오디오 리스너의 y 좌표 위치를 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate" positionZ, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 오디오 리스너의 z 좌표 위치를 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate" upX, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 리스너가 향하는 상향 방향의 x 좌표 성분을 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate" upY, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 리스너가 향하는 상향 방향의 y 좌표 성분을 설정합니다.
매개변수 값 참고 defaultValue1 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate" upZ, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 리스너가 향하는 상향 방향의 z 좌표 성분을 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate"
1.11.2. 메서드
setOrientation(x, y, z, xUp, yUp, zUp)-
이 메서드는 사용 중단되었습니다. 이는
forwardX.value,forwardY.value,forwardZ.value,upX.value,upY.value, 및upZ.value를 각각 주어진x,y,z,xUp,yUp, 및zUp값으로 직접 설정하는 것과 같습니다.따라서
forwardX,forwardY,forwardZ,upX,upY및upZAudioParam중 하나라도 이 메서드가 호출되는 시점에setValueCurveAtTime()을 사용하여 자동화 곡선이 설정되어 있으면NotSupportedError를 반드시 발생시켜야 합니다.setOrientation()은 3D 데카르트 좌표 공간에서 리스너가 향하는 방향을 설명합니다. 전방 벡터와 상향 벡터가 모두 제공됩니다. 사람을 기준으로 쉽게 설명하면 전방 벡터는 사람의 코가 가리키는 방향을 나타냅니다. 상향 벡터는 사람의 머리 위쪽이 가리키는 방향을 나타냅니다. 이 두 벡터는 선형적으로 독립적이어야 합니다. 이러한 값을 해석하는 방법에 관한 규범적 요구 사항은 § 6 공간화/패닝을 참조하십시오.x,y, 및z매개변수는 3D 공간의 전방 방향 벡터를 나타내며, 기본값은 (0,0,-1)입니다.xUp,yUp, 및zUp매개변수는 3D 공간의 상향 방향 벡터를 나타내며, 기본값은 (0,1,0)입니다.AudioListener.setOrientation() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 xfloat✘ ✘ AudioListener의 전방 x 방향yfloat✘ ✘ AudioListener의 전방 y 방향zfloat✘ ✘ AudioListener의 전방 z 방향xUpfloat✘ ✘ AudioListener의 상향 x 방향yUpfloat✘ ✘ AudioListener의 상향 y 방향zUpfloat✘ ✘ AudioListener의 상향 z 방향반환 유형:undefined setPosition(x, y, z)-
이 메서드는 사용 중단되었습니다. 이는
positionX.value,positionY.value, 및positionZ.value를 각각 주어진x,y, 및z값으로 직접 설정하는 것과 같습니다.따라서 이
AudioListener의positionX,positionY, 및positionZAudioParam중 하나라도 이 메서드가 호출되는 시점에setValueCurveAtTime()을 사용하여 자동화 곡선이 설정되어 있으면NotSupportedError를 반드시 발생시켜야 합니다.setPosition()은 3D 데카르트 좌표 공간에서 리스너의 위치를 설정합니다.PannerNode객체는 개별 오디오 소스를 기준으로 이 위치를 사용하여 공간화합니다.x,y, 및z매개변수는 3D 공간의 좌표를 나타냅니다.기본값은 (0,0,0)입니다.
AudioListener.setPosition() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 xfloat✘ ✘ AudioListener위치의 x 좌표yfloat✘ ✘ AudioListener위치의 y 좌표zfloat✘ ✘ AudioListener위치의 z 좌표
1.11.3. 처리
AudioListener의
매개변수는 AudioNode에
연결할 수 있고
동일한 그래프에서 PannerNode의
출력에도 영향을 줄 수 있으므로, 노드
순서 지정 알고리즘은 처리 순서를
계산할 때 AudioListener를
고려해야 합니다. 이러한 이유로 그래프의 모든 PannerNode는
AudioListener를
입력으로 가집니다.
1.12.
AudioProcessingEvent
인터페이스 - 사용 중단됨
이는
ScriptProcessorNode
노드에 디스패치되는 Event
객체입니다. 대체 기능인
AudioWorkletNode가
다른 접근 방식을 사용하므로 ScriptProcessorNode가 제거될 때
이 객체도 제거됩니다.
이벤트 핸들러는 inputBuffer 속성에서 오디오 데이터에
접근하여 입력(있는 경우)의 오디오를 처리합니다.
처리 결과인 오디오 데이터(입력이 없는 경우에는
합성된 데이터)는 이후
outputBuffer에
배치됩니다.
[Exposed =Window ]interface AudioProcessingEvent :Event {(constructor DOMString ,type AudioProcessingEventInit );eventInitDict readonly attribute double playbackTime ;readonly attribute AudioBuffer inputBuffer ;readonly attribute AudioBuffer outputBuffer ; };
1.12.1. 속성
inputBuffer, 유형은 AudioBuffer, 읽기 전용-
입력 오디오 데이터를 포함하는 AudioBuffer입니다. 이는 createScriptProcessor() 메서드의
numberOfInputChannels매개변수와 같은 수의 채널을 가집니다. 이 AudioBuffer는audioprocess이벤트 핸들러 함수의 범위 안에서만 유효합니다. 이 범위를 벗어나면 그 값은 의미가 없습니다. outputBuffer, 유형은 AudioBuffer, 읽기 전용-
출력 오디오 데이터를 반드시 기록해야 하는 AudioBuffer입니다. 이는 createScriptProcessor() 메서드의
numberOfOutputChannels매개변수와 같은 수의 채널을 가집니다.audioprocess이벤트 핸들러 함수의 범위 안에 있는 스크립트 코드는 이 AudioBuffer의 채널 데이터를 나타내는Float32Array배열을 수정해야 합니다. 이 범위를 벗어나 스크립트가 이 AudioBuffer를 수정해도 들을 수 있는 효과는 발생하지 않습니다. playbackTime, 유형은 double, 읽기 전용-
AudioContext의currentTime과 동일한 시간 좌표계에서 오디오가 재생될 시간입니다.
1.12.2.
AudioProcessingEventInit
dictionary AudioProcessingEventInit :EventInit {required double playbackTime ;required AudioBuffer inputBuffer ;required AudioBuffer outputBuffer ; };
1.12.2.1.
AudioProcessingEventInit
딕셔너리 멤버
inputBuffer, 유형은 AudioBuffer-
이벤트의
inputBuffer속성에 할당할 값입니다. outputBuffer, 유형은 AudioBuffer-
이벤트의
outputBuffer속성에 할당할 값입니다. playbackTime, 유형은 double-
이벤트의
playbackTime속성에 할당할 값입니다.
1.13.
BiquadFilterNode
인터페이스
BiquadFilterNode는
매우 일반적인 저차
필터를 구현하는 AudioNode
프로세서입니다.
저차 필터는 기본적인 톤 제어
(저음, 중음, 고음), 그래픽 이퀄라이저 및 더 고급 필터의 구성 요소입니다.
여러 BiquadFilterNode
필터를 결합하여
더 복잡한 필터를 구성할 수 있습니다. frequency와
같은 필터 매개변수는
필터 스윕 등을 위해 시간에 따라 변경할 수 있습니다. 각
BiquadFilterNode는
아래 IDL에 표시된 여러 일반적인
필터 유형 중 하나로 구성할 수 있습니다. 기본
필터 유형은 "lowpass"입니다.
frequency와
detune는
모두
복합 매개변수를
구성하고 둘 다 a-rate입니다. 두 값은
함께 사용되어 computedFrequency 값을 결정합니다:
computedFrequency(t) = frequency(t) * pow(2, detune(t) / 1200)
이 복합 매개변수의 명목 범위는 [0, 나이퀴스트 주파수]입니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 예 | 입력이 0이어도 무음이 아닌 오디오를 계속 출력합니다. 이는 IIR 필터이므로 필터는 이론적으로 영원히 0이 아닌 출력을 생성하지만, 실제로는 출력이 충분히 0에 가까워지는 유한 시간이 지난 후 이를 제한할 수 있습니다. 실제 시간은 필터 계수에 따라 달라집니다. |
출력의 채널 수는 항상 입력의 채널 수와 같습니다.
enum {BiquadFilterType "lowpass" ,"highpass" ,"bandpass" ,"lowshelf" ,"highshelf" ,"peaking" ,"notch" ,"allpass" };
| 열거형 값 | 설명 |
|---|---|
"lowpass"
|
로우패스
필터는 차단 주파수보다 낮은 주파수는
통과시키고 차단 주파수보다 높은 주파수는 감쇠합니다. 이는
옥타브당 12dB의 롤오프를 갖는 표준 2차 공진 로우패스 필터를
구현합니다.
|
"highpass"
|
하이패스
필터는 로우패스 필터의 반대입니다. 차단 주파수보다
높은 주파수는 통과시키지만 차단 주파수보다
낮은 주파수는 감쇠합니다. 이는 옥타브당 12dB의 롤오프를 갖는
표준 2차 공진 하이패스 필터를 구현합니다.
|
"bandpass"
|
밴드패스
필터는 일정한 주파수 범위를 통과시키고
이 주파수 범위보다 낮거나 높은 주파수를
감쇠합니다. 이는 2차 밴드패스 필터를 구현합니다.
|
"lowshelf"
|
로우셸프 필터는 모든 주파수를 통과시키지만 낮은 주파수에
부스트(또는 감쇠)를 추가합니다. 이는
2차 로우셸프 필터를 구현합니다.
|
"highshelf"
|
하이셸프 필터는 로우셸프 필터의 반대이며
모든 주파수를 통과시키지만 높은
주파수에 부스트를 추가합니다. 이는 2차 하이셸프 필터를 구현합니다
|
"peaking"
|
피킹 필터는 모든 주파수를 통과시키지만 특정
주파수 범위에 부스트(또는 감쇠)를 추가합니다.
|
"notch"
|
노치 필터(밴드스톱 또는
밴드 리젝션 필터라고도 함)는 밴드패스
필터의 반대입니다. 특정 주파수 집합을 제외한
모든 주파수를 통과시킵니다.
|
"allpass"
| 올패스 필터는 모든 주파수를 통과시키지만 여러 주파수 사이의 위상 관계를 변경합니다. 이는 2차 올패스 필터를 구현합니다 |
BiquadFilterNode의
모든 속성은 a-rate AudioParam입니다.
[Exposed =Window ]interface BiquadFilterNode :AudioNode {(constructor BaseAudioContext ,context optional BiquadFilterOptions = {});options attribute BiquadFilterType type ;readonly attribute AudioParam frequency ;readonly attribute AudioParam detune ;readonly attribute AudioParam Q ;readonly attribute AudioParam gain ;undefined getFrequencyResponse (Float32Array ,frequencyHz Float32Array ,magResponse Float32Array ); };phaseResponse
1.13.1. 생성자
BiquadFilterNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.BiquadFilterNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 BiquadFilterNode가 연관될BaseAudioContext입니다.optionsBiquadFilterOptions✘ ✔ 이 BiquadFilterNode의 선택적 초기 매개변수 값입니다.
1.13.2. 속성
Q, 유형은 AudioParam, 읽기 전용-
필터의 Q 계수입니다.
lowpass및highpass필터에서는Q값을 dB 단위로 해석합니다. 이러한 필터의 명목 범위는 \([-Q_{lim}, Q_{lim}]\)이며, 여기서 \(Q_{lim}\)은 \(10^{Q/20}\)이 오버플로하지 않는 가장 큰 값입니다. 이는 약 \(770.63678\)입니다.bandpass,notch,allpass, 및peaking필터에서는 이 값이 선형 값입니다. 이 값은 필터의 대역폭과 관련되므로 양수 값이어야 합니다. 명목 범위는 \([0, 3.4028235e38]\)이며, 상한은 가장 양수인 단정밀도 부동소수점 값입니다.이 값은
lowshelf및highshelf필터에서는 사용되지 않습니다.매개변수 값 참고 defaultValue1 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38이지만, 서로 다른 필터의 실제 제한은 위를 참조하십시오 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38이지만, 서로 다른 필터의 실제 제한은 위를 참조하십시오 automationRate" a-rate" detune, 유형은 AudioParam, 읽기 전용-
주파수에 대한 센트 단위의 디튠 값입니다. 이는
frequency와 복합 매개변수를 구성하여 computedFrequency를 만듭니다.매개변수 값 참고 defaultValue0 minValue\(\approx -153600\) maxValue\(\approx 153600\) 이 값은 대략 \(1200\ \log_2 \mathrm{FLT\_MAX}\)이며, 여기서 FLT_MAX는 가장 큰 float값입니다.automationRate" a-rate" frequency, 유형은 AudioParam, 읽기 전용-
BiquadFilterNode가 동작할 주파수이며 단위는 Hz입니다. 이는detune와 복합 매개변수를 구성하여 computedFrequency를 만듭니다.매개변수 값 참고 defaultValue350 minValue0 maxValue나이퀴스트 주파수 automationRate" a-rate" gain, 유형은 AudioParam, 읽기 전용-
필터의 게인입니다. 값의 단위는 dB입니다. 게인은
lowshelf,highshelf, 및peaking필터에서만 사용됩니다.매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue\(\approx 1541\) 이 값은 대략 \(40\ \log_{10} \mathrm{FLT\_MAX}\)이며, 여기서 FLT_MAX는 가장 큰 float값입니다.automationRate" a-rate" type, 유형은 BiquadFilterType-
이
BiquadFilterNode의 유형입니다. 기본값은 "lowpass"입니다. 다른 매개변수의 정확한 의미는type속성 값에 따라 달라집니다.
1.13.3. 메서드
getFrequencyResponse(frequencyHz, magResponse, phaseResponse)-
각 필터 매개변수의
[[current value]]가 주어지면 지정된 주파수에 대한 주파수 응답을 동기적으로 계산합니다. 세 매개변수는 반드시 길이가 같은Float32Array여야 하며, 그렇지 않으면InvalidAccessError를 반드시 발생시켜야 합니다.반환되는 주파수 응답은 현재 처리 블록에 대해 샘플링된
AudioParam을 사용하여 반드시 계산해야 합니다.BiquadFilterNode.getFrequencyResponse() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 frequencyHzFloat32Array✘ ✘ 이 매개변수는 응답 값을 계산할 주파수의 배열을 Hz 단위로 지정합니다. magResponseFloat32Array✘ ✘ 이 매개변수는 선형 크기 응답 값을 받는 출력 배열을 지정합니다. frequencyHz매개변수의 값이 [0, sampleRate/2] 범위에 있지 않고, 여기서sampleRate가sampleRate속성의AudioContext값이면,magResponse배열의 동일한 인덱스에 있는 해당 값은 반드시NaN이어야 합니다.phaseResponseFloat32Array✘ ✘ 이 매개변수는 라디안 단위의 위상 응답 값을 받는 출력 배열을 지정합니다. frequencyHz매개변수의 값이 [0; sampleRate/2] 범위에 있지 않고, 여기서sampleRate가sampleRate속성의AudioContext값이면,phaseResponse배열의 동일한 인덱스에 있는 해당 값은 반드시NaN이어야 합니다.반환 유형:undefined
1.13.4.
BiquadFilterOptions
이는 BiquadFilterNode를
생성할 때 사용할 옵션을 지정합니다.
모든 멤버는 선택 사항이며,
지정하지 않으면 노드를 생성할 때 일반적인 기본값이
사용됩니다.
dictionary BiquadFilterOptions :AudioNodeOptions {BiquadFilterType type = "lowpass";float Q = 1;float detune = 0;float frequency = 350;float gain = 0; };
1.13.4.1.
BiquadFilterOptions
딕셔너리 멤버
Q, 유형은 float, 기본값은1-
Q에 사용할 초기값입니다. detune, 유형은 float, 기본값은0-
detune에 사용할 초기값입니다. frequency, 유형은 float, 기본값은350-
frequency에 사용할 초기값입니다. gain, 유형은 float, 기본값은0-
gain에 사용할 초기값입니다. type, 유형은 BiquadFilterType, 기본값은"lowpass"-
필터에 사용할 초기 유형입니다.
1.13.5. 필터 특성
BiquadFilterNode를
통해 제공되는 필터 유형을 구현하는 방법에는 여러 가지가 있으며
각각
매우 다른 특성을 가집니다. 이 절의 수식은 서로 다른
필터 유형의 특성을 결정하므로 적합한 구현이 반드시
구현해야 하는 필터를 설명합니다.
이 수식들은
Audio EQ Cookbook의 수식에서
영감을 받았습니다.
BiquadFilterNode는
다음 전달 함수로 오디오를 처리합니다
$$
 H(z) = \frac{\frac{b_0}{a_0} + \frac{b_1}{a_0}z^{-1} + \frac{b_2}{a_0}z^{-2}}
                                          {1+\frac{a_1}{a_0}z^{-1}+\frac{a_2}{a_0}z^{-2}}
$$
이는 다음 시간 영역 방정식과 동일합니다:
$$
a_0 y(n) + a_1 y(n-1) + a_2 y(n-2) =
    b_0 x(n) + b_1 x(n-1) + b_2 x(n-2)
$$
초기 필터 상태는 0입니다.
참고: 고정 필터는 안정적이지만, AudioParam의
자동화를 사용하여 불안정한
바이쿼드 필터를 생성할 수 있습니다. 이를
관리하는 것은 개발자의 책임입니다.
참고: 필터 상태에서 NaN 값이 발생했음을 사용자에게 알리기 위해 UA가 경고를 표시할 수 있습니다. 이는 일반적으로 불안정한 필터를 나타냅니다.
위 전달 함수의 계수는
각 노드 유형마다 다릅니다. 이를 계산하려면
BiquadFilterNode의
AudioParam의
computedValue를 기반으로 다음 중간 변수가
필요합니다.
-
\(F_s\)를 이
AudioContext의sampleRate속성 값으로 둡니다. -
\(f_0\)를 computedFrequency의 값으로 둡니다.
-
\(G\)를
gainAudioParam의 값으로 둡니다. -
\(Q\)를
QAudioParam의 값으로 둡니다. -
마지막으로 다음과 같이 둡니다
$$
\begin{align*}
    A &= 10^{\frac{G}{40}} \\
    \omega_0 &= 2\pi\frac{f_0}{F_s} \\
    \alpha_Q &= \frac{\sin\omega_0}{2Q} \\
    \alpha_{Q_{dB}} &= \frac{\sin\omega_0}{2 \cdot 10^{Q/20}} \\
    S &= 1 \\
    \alpha_S &= \frac{\sin\omega_0}{2}\sqrt{\left(A+\frac{1}{A}\right)\left(\frac{1}{S}-1\right)+2}
\end{align*}
$$
각 필터 유형의 여섯 계수 (\(b_0, b_1, b_2, a_0, a_1, a_2\))는 다음과 같습니다:
- "
lowpass" -
$$ \begin{align*} b_0 &= \frac{1 - \cos\omega_0}{2} \\ b_1 &= 1 - \cos\omega_0 \\ b_2 &= \frac{1 - \cos\omega_0}{2} \\ a_0 &= 1 + \alpha_{Q_{dB}} \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_{Q_{dB}} \end{align*} $$ - "
highpass" -
$$ \begin{align*} b_0 &= \frac{1 + \cos\omega_0}{2} \\ b_1 &= -(1 + \cos\omega_0) \\ b_2 &= \frac{1 + \cos\omega_0}{2} \\ a_0 &= 1 + \alpha_{Q_{dB}} \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_{Q_{dB}} \end{align*} $$ - "
bandpass" -
$$ \begin{align*} b_0 &= \alpha_Q \\ b_1 &= 0 \\ b_2 &= -\alpha_Q \\ a_0 &= 1 + \alpha_Q \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_Q \end{align*} $$ - "
notch" -
$$ \begin{align*} b_0 &= 1 \\ b_1 &= -2\cos\omega_0 \\ b_2 &= 1 \\ a_0 &= 1 + \alpha_Q \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_Q \end{align*} $$ - "
allpass" -
$$ \begin{align*} b_0 &= 1 - \alpha_Q \\ b_1 &= -2\cos\omega_0 \\ b_2 &= 1 + \alpha_Q \\ a_0 &= 1 + \alpha_Q \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \alpha_Q \end{align*} $$ - "
peaking" -
$$ \begin{align*} b_0 &= 1 + \alpha_Q\, A \\ b_1 &= -2\cos\omega_0 \\ b_2 &= 1 - \alpha_Q\,A \\ a_0 &= 1 + \frac{\alpha_Q}{A} \\ a_1 &= -2 \cos\omega_0 \\ a_2 &= 1 - \frac{\alpha_Q}{A} \end{align*} $$ - "
lowshelf" -
$$ \begin{align*} b_0 &= A \left[ (A+1) - (A-1) \cos\omega_0 + 2 \alpha_S \sqrt{A})\right] \\ b_1 &= 2 A \left[ (A-1) - (A+1) \cos\omega_0 )\right] \\ b_2 &= A \left[ (A+1) - (A-1) \cos\omega_0 - 2 \alpha_S \sqrt{A}) \right] \\ a_0 &= (A+1) + (A-1) \cos\omega_0 + 2 \alpha_S \sqrt{A} \\ a_1 &= -2 \left[ (A-1) + (A+1) \cos\omega_0\right] \\ a_2 &= (A+1) + (A-1) \cos\omega_0 - 2 \alpha_S \sqrt{A}) \end{align*} $$ - "
highshelf" -
$$
    \begin{align*}
        b_0 &= A\left[ (A+1) + (A-1)\cos\omega_0 + 2\alpha_S\sqrt{A} )\right] \\
        b_1 &= -2A\left[ (A-1) + (A+1)\cos\omega_0 )\right] \\
        b_2 &= A\left[ (A+1) + (A-1)\cos\omega_0 - 2\alpha_S\sqrt{A} )\right] \\
        a_0 &= (A+1) - (A-1)\cos\omega_0 + 2\alpha_S\sqrt{A} \\
        a_1 &= 2\left[ (A-1) - (A+1)\cos\omega_0\right] \\
        a_2 &= (A+1) - (A-1)\cos\omega_0 - 2\alpha_S\sqrt{A}
    \end{align*}
$$
1.14.
ChannelMergerNode
인터페이스
ChannelMergerNode는
더 고급
애플리케이션에서 사용하기 위한 것이며 흔히
ChannelSplitterNode와
함께 사용됩니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 참고 참조 | 기본값은 6이지만 ChannelMergerOptions,numberOfInputs
또는 createChannelMerger에서
지정한 값에 따라 결정됩니다.
|
numberOfOutputs
| 1 | |
channelCount
| 1 | channelCount 제약 조건이 있습니다 |
channelCountMode
| "explicit"
| channelCountMode 제약 조건이 있습니다 |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
이 인터페이스는 여러 오디오 스트림의 채널을 하나의 오디오
스트림으로 결합하기 위한 AudioNode를
나타냅니다. 입력 수는 가변적이며(기본값은 6), 모든
입력을 연결할 필요는 없습니다. 출력은 하나이며, 입력 중 하나라도
활성 처리 중이면 해당 오디오
스트림의 채널 수는 입력 수와 같습니다. 어떤 입력도
활성
처리 중이 아니면 출력은 단일 무음 채널입니다.
여러 입력을 하나의 스트림으로 병합하려면 각 입력을 지정된 믹싱 규칙에 따라 하나의 채널(모노)로 다운 믹싱합니다. 연결되지 않은 입력도 출력에서 하나의 무음 채널로 계산됩니다. 입력 스트림을 변경해도 출력 채널의 순서는 변경되지 않습니다.
ChannelMergerNode에
연결된 스테레오 입력이 두 개 있으면, 첫 번째와 두 번째 입력은 병합 전에 각각
모노로 다운 믹싱됩니다. 출력은
첫 두 채널이 처음 두 개의 (다운 믹싱된) 입력으로 채워지고
나머지 채널은 무음인 6채널 스트림이 됩니다.
또한 ChannelMergerNode는
5.1 서라운드 구성과 같은 다중 채널
스피커 배열을 위해 여러 오디오 스트림을 특정 순서로
배치하는 데 사용할 수 있습니다. 머저는 채널의 의미(예: 왼쪽, 오른쪽 등)를
해석하지 않고 입력된 순서대로
채널을 단순히 결합합니다.
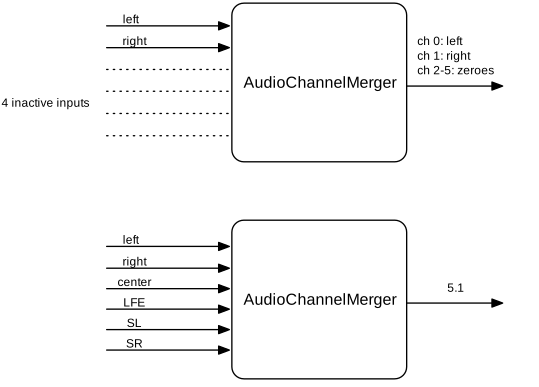
[Exposed =Window ]interface ChannelMergerNode :AudioNode {constructor (BaseAudioContext ,context optional ChannelMergerOptions = {}); };options
1.14.1. 생성자
ChannelMergerNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.ChannelMergerNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 ChannelMergerNode가 연관될BaseAudioContext입니다.optionsChannelMergerOptions✘ ✔ 이 ChannelMergerNode의 선택적 초기 매개변수 값입니다.
1.14.2.
ChannelMergerOptions
dictionary ChannelMergerOptions :AudioNodeOptions {unsigned long numberOfInputs = 6; };
1.14.2.1.
ChannelMergerOptions
딕셔너리 멤버
numberOfInputs, 유형은 unsigned long, 기본값은6-
ChannelMergerNode의 입력 수입니다. 이 값에 대한 제약 조건은createChannelMerger()를 참조하십시오.
1.15.
ChannelSplitterNode
인터페이스
ChannelSplitterNode는
더 고급
애플리케이션에서 사용하기 위한 것이며 흔히
ChannelMergerNode와
함께 사용됩니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 참고 참조 | 기본값은 6이지만, 그 외에는 ChannelSplitterOptions.numberOfOutputs
또는 createChannelSplitter에서
지정한 값
또는 numberOfOutputs
멤버의 ChannelSplitterOptions
딕셔너리를 constructor에
전달한 값에 따라 결정됩니다.
|
channelCount
| numberOfOutputs
| channelCount 제약 조건이 있습니다 |
channelCountMode
| "explicit"
| channelCountMode 제약 조건이 있습니다 |
channelInterpretation
| "discrete"
| channelInterpretation 제약 조건이 있습니다 |
| 테일 타임 | 아니요 |
이 인터페이스는 라우팅
그래프에서 오디오 스트림의 개별 채널에 접근하기 위한 AudioNode를
나타냅니다. 하나의 입력과 입력 오디오 스트림의 채널 수와 같은 수의
"활성" 출력이 있습니다. 예를 들어 스테레오 입력이
ChannelSplitterNode에
연결되면 활성 출력 수는
두 개(왼쪽 채널에서 하나, 오른쪽 채널에서 하나)가 됩니다.
항상 총 N개의 출력이 있으며(N은
AudioContext
메서드 createChannelSplitter()의
numberOfOutputs 매개변수로 결정됨),
이 값을 제공하지 않으면 기본 수는 6입니다. "활성"이 아닌 출력은
무음을 출력하며 일반적으로 아무것에도
연결되지 않습니다.
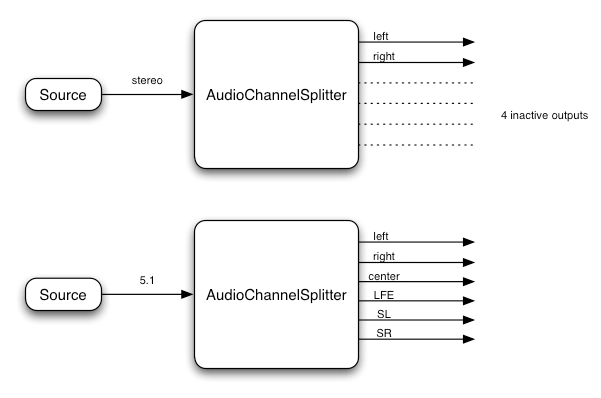
이 예에서는 스플리터가 채널의 의미(예: 왼쪽, 오른쪽 등)를 해석하지 않고, 입력된 순서대로 채널을 단순히 분리한다는 점에 유의하십시오.
ChannelSplitterNode의
한 가지 용도는 각 채널의 개별 게인 제어가
필요한 "매트릭스 믹싱"입니다.
[Exposed =Window ]interface ChannelSplitterNode :AudioNode {constructor (BaseAudioContext ,context optional ChannelSplitterOptions = {}); };options
1.15.1. 생성자
ChannelSplitterNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.ChannelSplitterNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 ChannelSplitterNode가 연관될BaseAudioContext입니다.optionsChannelSplitterOptions✘ ✔ 이 ChannelSplitterNode의 선택적 초기 매개변수 값입니다.
1.15.2.
ChannelSplitterOptions
dictionary ChannelSplitterOptions :AudioNodeOptions {unsigned long numberOfOutputs = 6; };
1.15.2.1.
ChannelSplitterOptions
딕셔너리 멤버
numberOfOutputs, 유형은 unsigned long, 기본값은6-
ChannelSplitterNode의 출력 수입니다. 이 값에 대한 제약 조건은createChannelSplitter()를 참조하십시오.
1.16.
ConstantSourceNode
인터페이스
이 인터페이스는 출력이 명목상 일정한 값인
상수 오디오 소스를 나타냅니다. 일반적인 상수 소스 노드로
유용하며, offset을
자동화하거나 다른 노드를 연결하여 생성 가능한
AudioParam처럼
사용할 수 있습니다.
이 노드의 단일 출력은 하나의 채널(모노)로 구성됩니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
[Exposed =Window ]interface ConstantSourceNode :AudioScheduledSourceNode {constructor (BaseAudioContext ,context optional ConstantSourceOptions = {});options readonly attribute AudioParam offset ; };
1.16.1. 생성자
ConstantSourceNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.ConstantSourceNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 ConstantSourceNode가 연관될BaseAudioContext입니다.optionsConstantSourceOptions✘ ✔ 이 ConstantSourceNode의 선택적 초기 매개변수 값입니다.
1.16.2. 속성
offset, 유형은 AudioParam, 읽기 전용-
소스의 상수 값입니다.
매개변수 값 참고 defaultValue1 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate"
1.16.3.
ConstantSourceOptions
이는 ConstantSourceNode를
생성하기 위한 옵션을 지정합니다.
모든 멤버는 선택 사항이며,
지정하지 않으면 노드를 생성할 때 일반적인 기본값이
사용됩니다.
dictionary ConstantSourceOptions {float offset = 1; };
1.16.3.1.
ConstantSourceOptions
딕셔너리 멤버
offset, 유형은 float, 기본값은1-
이 노드의
offsetAudioParam의 초기값입니다.
1.17.
ConvolverNode
인터페이스
이 인터페이스는 임펄스 응답이 주어졌을 때 선형 컨볼루션 효과를 적용하는 처리 노드를 나타냅니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | channelCount 제약 조건이 있습니다 |
channelCountMode
| "clamped-max"
| channelCountMode 제약 조건이 있습니다 |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 예 | buffer의
길이 동안 입력이 0이어도 무음이 아닌 오디오를 계속 출력합니다.
|
이 노드의 입력은 모노(1채널) 또는 스테레오(2채널)이며 늘릴 수 없습니다. 더 많은 채널을 가진 노드에서 오는 연결은 적절하게 다운 믹싱됩니다.
이 노드에는 channelCount 제약 조건과 channelCountMode 제약 조건이 있습니다. 이러한 제약 조건은 노드의 입력이 모노 또는 스테레오가 되도록 보장합니다.
[Exposed =Window ]interface ConvolverNode :AudioNode {constructor (BaseAudioContext ,context optional ConvolverOptions = {});options attribute AudioBuffer ?buffer ;attribute boolean normalize ; };
1.17.1. 생성자
ConvolverNode(context, options)-
생성자가
BaseAudioContextcontext와 옵션 객체 options으로 호출되면 다음 단계를 실행합니다:-
normalize속성을disableNormalization값의 반대로 설정합니다. -
buffer가 존재하면buffer속성을 그 값으로 설정합니다.참고: 이는 버퍼가
normalize속성 값에 따라 정규화됨을 의미합니다. -
o를 새
AudioNodeOptions딕셔너리로 둡니다. -
options에
channelCount가 존재하면 o의channelCount를 같은 값으로 설정합니다. -
options에
channelCountMode가 존재하면 o의channelCountMode를 같은 값으로 설정합니다. -
options에
channelInterpretation이 존재하면 o의channelInterpretation을 같은 값으로 설정합니다. -
c와 o를 인수로 사용하여 this AudioNode를 초기화합니다.
ConvolverNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 ConvolverNode가 연관될BaseAudioContext입니다.optionsConvolverOptions✘ ✔ 이 ConvolverNode의 선택적 초기 매개변수 값입니다. -
1.17.2. 속성
buffer, 유형은 AudioBuffer, 널 허용-
이 속성이 설정되는 시점에
buffer와normalize속성의 상태를 사용하여 주어진 정규화가 적용된 이 임펄스 응답으로ConvolverNode를 구성합니다. 이 속성의 초기값은 null입니다.buffer attribute를 설정할 때 다음 단계를 동기적으로 실행합니다:-
버퍼의
채널 수가 1, 2 또는 4가 아니거나 버퍼의sample-rate가 연관된BaseAudioContext의sample-rate와 같지 않으면NotSupportedError를 반드시 발생시켜야 합니다.
참고:
buffer를 새 버퍼로 설정하면 오디오에 글리치가 발생할 수 있습니다. 이를 원하지 않는다면 기존 노드를 교체할 새ConvolverNode를 만들고 두 노드 사이에 크로스페이드를 적용하는 것이 권장됩니다.참고:
ConvolverNode는 입력 채널이 하나이고 단일 채널buffer가 있는 한 가지 경우에만 모노 출력을 생성합니다. 그 밖의 모든 경우에는 출력이 스테레오입니다. 특히buffer에 네 채널이 있고 입력 채널이 두 개이면ConvolverNode는 매트릭스 "트루" 스테레오 컨볼루션을 수행합니다. 규범적 정보는 채널 구성 다이어그램을 참조하십시오 -
normalize, 유형은 boolean-
buffer속성이 설정될 때 버퍼의 임펄스 응답을 동일 전력 정규화로 스케일할지 제어합니다. 다양한 임펄스 응답을 로드했을 때 컨볼버에서 보다 균일한 출력 레벨을 얻기 위해 기본값은true입니다.normalize가false로 설정되면 임펄스 응답에 대한 사전 처리/스케일링 없이 컨볼루션이 렌더링됩니다. 이 값의 변경은 다음에buffer속성이 설정될 때까지 적용되지 않습니다.buffer속성이 설정될 때normalize속성이 false이면ConvolverNode는buffer에 포함된 정확한 임펄스 응답을 사용하여 선형 컨볼루션을 수행합니다.그렇지 않고
buffer속성이 설정될 때normalize속성이 true이면ConvolverNode는 먼저buffer에 포함된 오디오 데이터에 대해 스케일된 RMS 전력 분석을 수행하여 다음 알고리즘에 따라 normalizationScale을 계산합니다:function calculateNormalizationScale( buffer) { const GainCalibration= 0.00125 ; const GainCalibrationSampleRate= 44100 ; const MinPower= 0.000125 ; // RMS 전력으로 정규화합니다. const numberOfChannels= buffer. numberOfChannels; const length= buffer. length; let power= 0 ; for ( let i= 0 ; i< numberOfChannels; i++ ) { let channelPower= 0 ; const channelData= buffer. getChannelData( i); for ( let j= 0 ; j< length; j++ ) { const sample= channelData[ j]; channelPower+= sample* sample; } power+= channelPower; } power= Math. sqrt( power/ ( numberOfChannels* length)); // 실수로 인한 과부하를 방지합니다. if ( ! isFinite( power) || isNaN( power) || power< MinPower) power= MinPower; let scale= 1 / power; // 인지되는 음량이 처리 전과 같도록 보정합니다. scale*= GainCalibration; // 스케일은 샘플 레이트에 따라 달라집니다. if ( buffer. sampleRate) scale*= GainCalibrationSampleRate/ buffer. sampleRate; // 트루 스테레오 보정입니다. if ( numberOfChannels== 4 ) scale*= 0.5 ; return scale; } 처리 중에 ConvolverNode는 이렇게 계산된 normalizationScale 값을 가져와 입력을 임펄스 응답(
buffer로 나타냄)으로 처리하여 얻은 선형 컨볼루션 결과에 곱해 최종 출력을 생성합니다. 또는 입력에 normalizationScale을 미리 곱하거나 임펄스 응답 버전에 normalizationScale을 미리 곱는 것과 같은 수학적으로 동등한 연산을 사용할 수 있습니다.
1.17.3.
ConvolverOptions
이는 ConvolverNode를
생성하기 위한 옵션을 지정합니다.
모든 멤버는 선택 사항이며, 지정하지 않으면
일반적인 기본값을 사용하여 노드를 생성합니다.
dictionary ConvolverOptions :AudioNodeOptions {AudioBuffer ?buffer ;boolean disableNormalization =false ; };
1.17.3.1.
ConvolverOptions
딕셔너리 멤버
buffer, 유형은 AudioBuffer, 널 허용-
ConvolverNode에 사용할 버퍼입니다. 이 버퍼는disableNormalization값에 따라 정규화됩니다. disableNormalization, 유형은 boolean, 기본값은false-
ConvolverNode의normalize속성에 사용할 초기값의 반대입니다.
1.17.4. 입력, 임펄스 응답 및 출력의 채널 구성
구현은 입력이 1채널 또는 2채널인 경우 다양한 리버브 효과를 얻기 위해
ConvolverNode에서
다음과 같이 허용되는 임펄스 응답 채널 구성을 반드시 지원해야 합니다.
아래 다이어그램에 표시된 것처럼 단일 채널 컨볼루션은 모노 오디오 입력에
모노 임펄스 응답을 사용하여 동작하고 모노 출력을 생성합니다.
다이어그램의 나머지 이미지는 입력 채널 수가 1 또는 2이고
buffer의
채널 수가 1, 2 또는 4인 모노 및
스테레오 재생의 지원되는 경우를 보여 줍니다.
더 복잡하고 임의적인 매트릭싱을 원하는 개발자는
ChannelSplitterNode,
여러 단일 채널
ConvolverNode
및
ChannelMergerNode를
사용할 수 있습니다.
이 노드가 활성 처리 중이 아니면 출력은 단일 무음 채널입니다.
참고: 아래 다이어그램은 활성 처리 중일 때의 출력을 보여 줍니다.
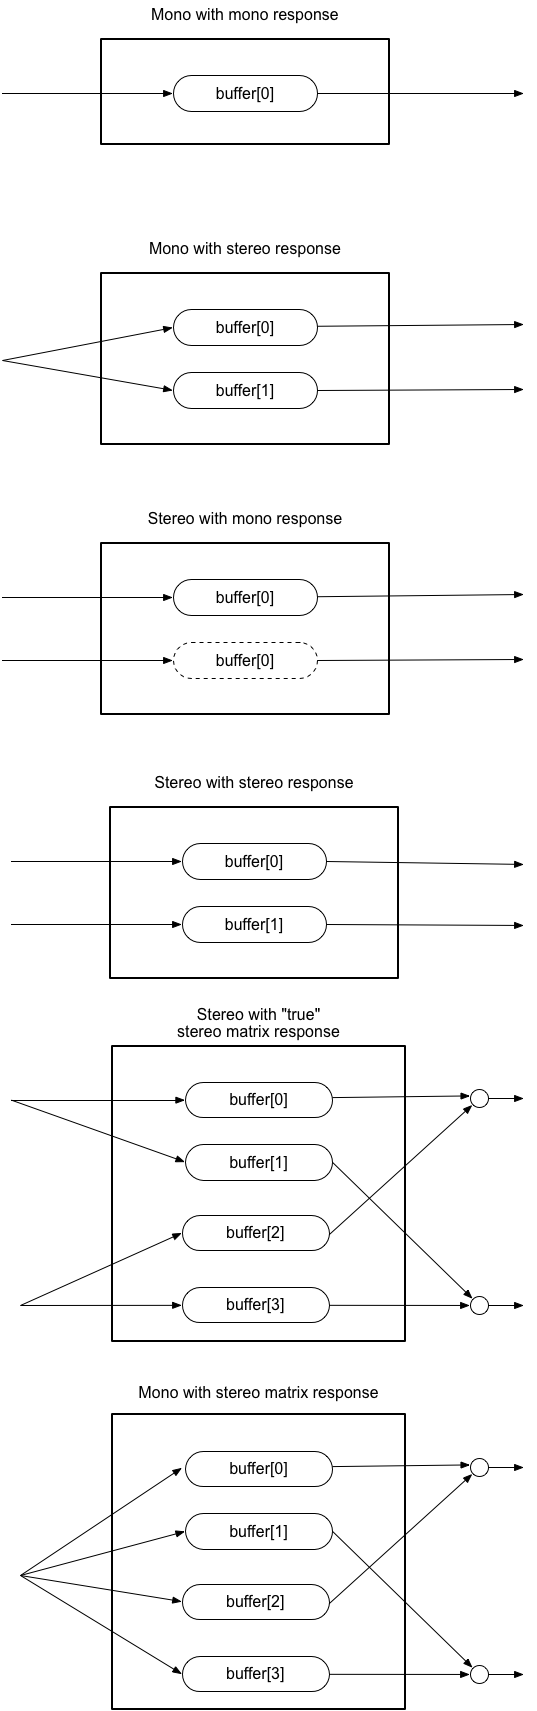
ConvolverNode를
사용할 때 지원되는 입력 및 출력 채널
수의 가능성을 그래픽으로 나타낸 것입니다.
1.18.
DelayNode
인터페이스
딜레이 라인은 오디오 애플리케이션의 기본 구성 요소입니다.
이 인터페이스는 입력 하나와
출력 하나를 가진 AudioNode입니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 예 | 노드의 maxDelayTime까지
입력이 0이어도 무음이 아닌 오디오를 계속 출력합니다.
|
출력의 채널 수는 항상 입력의 채널 수와 같습니다.
들어오는 오디오 신호를 일정한 시간만큼 지연합니다.
구체적으로 각 시간 t에서 입력 신호
input(t), 지연 시간 delayTime(t), 출력 신호
output(t)에 대해 출력은 output(t) = input(t -
delayTime(t))가 됩니다. 기본 delayTime은 0초
(지연 없음)입니다.
DelayNode의
입력 채널 수가 변경되면
(따라서 출력 채널 수도 변경됨), 노드에서 아직 출력하지 않았으며
내부 상태의 일부인 지연된 오디오 샘플이 있을 수 있습니다.
이러한 샘플을 이전에 다른 채널 수로 받았다면 새로 받은
입력과 결합하기 전에 반드시 업 믹싱 또는 다운 믹싱하여
모든 내부 딜레이 라인 믹싱이 하나의 우세한 채널
레이아웃을 사용하도록 해야 합니다.
참고: 정의상 DelayNode는
지연량과 같은 오디오 처리
지연 시간을 도입합니다.
[Exposed =Window ]interface DelayNode :AudioNode {constructor (BaseAudioContext ,context optional DelayOptions = {});options readonly attribute AudioParam delayTime ; };
1.18.1. 생성자
DelayNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.DelayNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 DelayNode가 연관될BaseAudioContext입니다.optionsDelayOptions✘ ✔ 이 DelayNode의 선택적 초기 매개변수 값입니다.
1.18.2. 속성
delayTime, 유형은 AudioParam, 읽기 전용-
적용할 지연량(초)을 나타내는
AudioParam객체입니다. 기본value는 0(지연 없음)입니다. 최솟값은 0이고 최댓값은maxDelayTime인수의AudioContext메서드createDelay()또는DelayOptions딕셔너리의maxDelayTime멤버를constructor에 전달한 값에 따라 결정됩니다.DelayNode가 사이클의 일부이면delayTime속성 값은 최소 하나의 렌더 퀀텀으로 제한됩니다.매개변수 값 참고 defaultValue0 minValue0 maxValuemaxDelayTimeautomationRate" a-rate"
1.18.3.
DelayOptions
이는 DelayNode를
생성하기 위한 옵션을 지정합니다.
모든 멤버는 선택 사항이며, 지정하지 않으면
일반적인 기본값을 사용하여 노드를 생성합니다.
dictionary DelayOptions :AudioNodeOptions {double maxDelayTime = 1;double delayTime = 0; };
1.18.3.1.
DelayOptions
딕셔너리 멤버
delayTime, 유형은 double, 기본값은0-
노드의 초기 지연 시간입니다.
maxDelayTime, 유형은 double, 기본값은1-
노드의 최대 지연 시간입니다. 제약 조건은
createDelay(maxDelayTime)를 참조하십시오.
1.18.4. 처리
DelayNode에는
delayTime
초 분량의 오디오를 보관하는 내부 버퍼가 있습니다.
DelayNode의
처리는 딜레이 라인에 쓰기와
딜레이 라인에서 읽기의 두 부분으로 나뉩니다. 이는 두 개의 내부
AudioNode를
통해 수행됩니다(작성자에게 노출되지 않으며
노드 내부 동작을 쉽게 설명하기 위해서만 존재합니다). 둘 다
DelayNode에서
생성됩니다.
DelayNode에
대한 DelayWriter를
생성한다는 것은
AudioNode와
동일한 인터페이스를 가지며 입력 오디오를
DelayNode의
내부 버퍼에 기록하는 객체를 생성한다는 의미입니다. 이 객체는
생성의 기반이 된 DelayNode와
동일한 입력 연결을 가집니다.
DelayNode에
대한 DelayReader를
생성한다는 것은
AudioNode와
동일한 인터페이스를 가지며 DelayNode의
내부 버퍼에서 오디오 데이터를 읽을 수 있는 객체를 생성한다는 의미입니다.
이 객체는 생성의 기반이 된 DelayNode와
동일한 AudioNode에
연결됩니다. DelayReader는
소스 노드입니다.
입력 버퍼를 처리할 때 DelayWriter는 오디오를
DelayNode의
내부 버퍼에 반드시 기록해야 합니다.
출력 버퍼를 생성할 때 DelayReader는 정확히
delayTime
초 전에 해당 DelayWriter에
기록된 오디오를 반드시 생성해야 합니다.
참고: 이는 채널 수 변경이 지연 시간이 지난 후 반영됨을 의미합니다.
1.19.
DynamicsCompressorNode
인터페이스
DynamicsCompressorNode는
다이내믹스 압축 효과를 구현하는
AudioNode
프로세서입니다.
다이내믹스 압축은 음악 제작과 게임 오디오에서 매우 일반적으로 사용됩니다. 신호의 가장 큰 부분의 음량을 낮추고 가장 작은 부분의 음량을 높입니다. 전체적으로 더 크고, 풍부하며 꽉 찬 소리를 얻을 수 있습니다. 특히 많은 개별 사운드가 동시에 재생되는 게임 및 음악 애플리케이션에서 전체 신호 레벨을 제어하고 스피커로 출력되는 오디오의 클리핑(왜곡)을 방지하는 데 매우 중요합니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | channelCount 제약 조건이 있습니다 |
channelCountMode
| "clamped-max"
| channelCountMode 제약 조건이 있습니다 |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 예 | 이 노드는 룩어헤드 지연으로 인해 입력이 0이어도 무음이 아닌 오디오를 계속 출력하는 테일 타임을 가집니다. |
[Exposed =Window ]interface DynamicsCompressorNode :AudioNode {constructor (BaseAudioContext ,context optional DynamicsCompressorOptions = {});options readonly attribute AudioParam threshold ;readonly attribute AudioParam knee ;readonly attribute AudioParam ratio ;readonly attribute float reduction ;readonly attribute AudioParam attack ;readonly attribute AudioParam release ; };
1.19.1. 생성자
DynamicsCompressorNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.[[internal reduction]]을 this의 비공개 슬롯으로 두며, 데시벨 단위의 부동소수점 수를 보관합니다.[[internal reduction]]을 0.0으로 설정합니다.DynamicsCompressorNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 DynamicsCompressorNode가 연관될BaseAudioContext입니다.optionsDynamicsCompressorOptions✘ ✔ 이 DynamicsCompressorNode의 선택적 초기 매개변수 값입니다.
1.19.2. 속성
attack, 유형은 AudioParam, 읽기 전용-
게인을 10dB 줄이는 데 걸리는 시간(초)입니다.
매개변수 값 참고 defaultValue.003 minValue0 maxValue1 automationRate" k-rate"자동화 속도 제약 조건이 있습니다 knee, 유형은 AudioParam, 읽기 전용-
곡선이 "ratio" 부분으로 부드럽게 전환되는 임계값 위의 범위를 나타내는 데시벨 값입니다.
매개변수 값 참고 defaultValue30 minValue0 maxValue40 automationRate" k-rate"자동화 속도 제약 조건이 있습니다 ratio, 유형은 AudioParam, 읽기 전용-
출력이 1dB 변화할 때 입력에서 변화하는 dB의 양입니다.
매개변수 값 참고 defaultValue12 minValue1 maxValue20 automationRate" k-rate"자동화 속도 제약 조건이 있습니다 reduction, 유형은 float, 읽기 전용-
미터링 용도의 읽기 전용 데시벨 값으로, 컴프레서가 현재 신호에 적용하고 있는 게인 감소량을 나타냅니다. 신호가 입력되지 않으면 값은 0(게인 감소 없음)입니다. 이 속성을 읽을 때 비공개 슬롯
[[internal reduction]]의 값을 반환합니다. release, 유형은 AudioParam, 읽기 전용-
게인을 10dB 증가시키는 데 걸리는 시간(초)입니다.
매개변수 값 참고 defaultValue.25 minValue0 maxValue1 automationRate" k-rate"자동화 속도 제약 조건이 있습니다 threshold, 유형은 AudioParam, 읽기 전용-
이 값을 초과하면 압축이 적용되기 시작하는 데시벨 값입니다.
매개변수 값 참고 defaultValue-24 minValue-100 maxValue0 automationRate" k-rate"자동화 속도 제약 조건이 있습니다
1.19.3.
DynamicsCompressorOptions
이는 DynamicsCompressorNode를
생성할 때 사용할 옵션을 지정합니다.
모든 멤버는
선택 사항이며, 지정하지 않으면 노드를 생성할 때
일반적인 기본값이 사용됩니다.
dictionary DynamicsCompressorOptions :AudioNodeOptions {float attack = 0.003;float knee = 30;float ratio = 12;float release = 0.25;float threshold = -24; };
1.19.3.1.
DynamicsCompressorOptions
딕셔너리 멤버
attack, 유형은 float, 기본값은0.003-
attackAudioParam의 초기값입니다. knee, 유형은 float, 기본값은30-
kneeAudioParam의 초기값입니다. ratio, 유형은 float, 기본값은12-
ratioAudioParam의 초기값입니다. release, 유형은 float, 기본값은0.25-
releaseAudioParam의 초기값입니다. threshold, 유형은 float, 기본값은-24-
thresholdAudioParam의 초기값입니다.
1.19.4. 처리
다이내믹스 압축은 다양한 방식으로 구현할 수 있습니다.
DynamicsCompressorNode는
다음과 같은 특성을 가진 다이내믹스 프로세서를
구현합니다:
-
고정 룩어헤드(이는
DynamicsCompressorNode가 신호 체인에 고정 지연 시간을 추가한다는 의미입니다). -
구성 가능한 어택 속도, 릴리스 속도, 임계값, 니 강도 및 비율입니다.
-
사이드체이닝은 지원되지 않습니다.
-
게인 감소량은
DynamicsCompressorNode의reduction속성을 통해 보고됩니다. -
압축 곡선은 세 부분으로 구성됩니다:
-
첫 번째 부분은 항등 함수입니다: \(f(x) = x\).
-
두 번째 부분은 소프트 니 부분이며, 반드시 단조 증가 함수여야 합니다.
-
세 번째 부분은 선형 함수입니다: \(f(x) = \frac{1}{ratio} \cdot x \).
이 곡선은 반드시 연속이고 구간별 미분 가능해야 하며, 입력 레벨을 기준으로 한 목표 출력 레벨에 대응합니다.
-
그래프로 나타내면 이러한 곡선은 대략 다음과 같습니다:
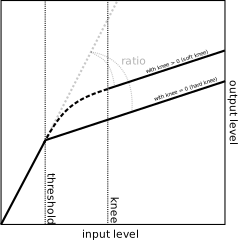
내부적으로 DynamicsCompressorNode는
다른 AudioNode의
조합과 게인 감소 값을 계산하는 특수
알고리즘으로 설명됩니다.
다음 AudioNode
그래프가 내부적으로 사용되며,
input과 output은 각각 입력 및 출력
AudioNode,
context는 이
DynamicsCompressorNode의
BaseAudioContext이고,
새로운 클래스 EnvelopeFollower는 아래에서 설명하는
AudioNode처럼
동작하는
특수 객체를 인스턴스화합니다:
const delay = new DelayNode(context, {delayTime: 0.006});
const gain = new GainNode(context);
const compression = new EnvelopeFollower();

input.connect(delay).connect(gain).connect(output);
input.connect(compression).connect(gain.gain);
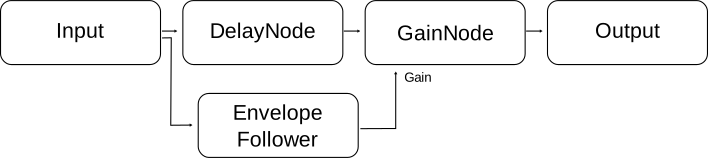
DynamicsCompressorNode
처리 알고리즘의 일부로 사용되는 내부 AudioNode의
그래프입니다.
참고: 이는 프리딜레이와 감소 게인의 적용을 구현합니다.
다음 알고리즘은 입력 신호에 적용되어 게인 감소 값을 생성하는 EnvelopeFollower 객체가 수행하는 처리를 설명합니다. EnvelopeFollower에는 부동소수점 값을 보관하는 두 개의 슬롯이 있습니다. 이 값들은 이 알고리즘을 여러 번 호출해도 유지됩니다.
-
[[detector average]]를 0.0으로 초기화된 부동소수점 수로 둡니다. -
[[compressor gain]]을 1.0으로 초기화된 부동소수점 수로 둡니다.
-
attack과 release를 각각
attack및release의 처리 시점에 샘플링된 값(이들은 k-rate 매개변수입니다)에 이DynamicsCompressorNode가 연관된BaseAudioContext의 샘플 레이트를 곱한 값으로 둡니다. -
detector average를 슬롯
[[detector average]]의 값으로 둡니다. -
compressor gain을 슬롯
[[compressor gain]]의 값으로 둡니다. -
처리할 렌더 퀀텀의 각 샘플 input에 대해 다음 단계를 실행합니다:
-
input의 절댓값이 0.0001보다 작으면 attenuation을 1.0으로 둡니다. 그렇지 않으면 shaped input을 input의 절댓값에 압축 곡선을 적용한 값으로 둡니다. attenuation을 shaped input을 input의 절댓값으로 나눈 값으로 둡니다.
-
attenuation이 compressor gain보다 크면 releasing을
true로, 그렇지 않으면false로 둡니다. -
detector rate를 attenuation에 검출기 곡선을 적용한 결과로 둡니다.
-
attenuation에서 detector average를 빼고, 그 결과에 detector rate를 곱합니다. 이 새 결과를 detector average에 더합니다.
-
detector average의 최댓값을 1.0으로 제한합니다.
-
envelope rate를 attack과 release 값을 바탕으로 엔벌로프 레이트를 계산한 결과로 둡니다.
-
releasing이
true이면 compressor gain을 compressor gain과 envelope rate의 곱으로 설정하고, 최댓값을 1.0으로 제한합니다. -
그렇지 않고 releasing이
false이면 gain increment를 detector average에서 compressor gain을 뺀 값으로 둡니다. gain increment에 envelope rate를 곱하고 그 결과를 compressor gain에 더합니다. -
reduction gain을 compressor gain에 메이크업 게인을 계산한 반환값을 곱한 값으로 계산합니다.
-
metering gain을 reduction gain을 데시벨로 변환한 값으로 계산합니다.
-
-
[[compressor gain]]을 compressor gain으로 설정합니다. -
[[detector average]]를 detector average로 설정합니다. -
내부 슬롯
[[internal reduction]]을 metering gain 값으로 원자적으로 설정합니다.참고: 이 단계는 블록 처리 끝에서 미터링 게인이 블록당 한 번 업데이트되도록 합니다.
메이크업 게인은 컴프레서의 ratio, knee 및 threshold 매개변수에만 의존하고 입력 신호에는 의존하지 않는 고정 게인 단계입니다. 여기서의 목적은 컴프레서의 출력 레벨을 높여 입력 레벨과 비슷하게 만드는 것입니다.
-
full range gain을 값 1.0에 압축 곡선을 적용하여 반환된 값으로 둡니다.
-
full range makeup gain을 full range gain의 역수로 둡니다.
-
full range makeup gain을 0.6제곱한 결과를 반환합니다.
-
엔벌로프 레이트는 반드시 compressor gain과 detector average의 비율에서 계산해야 합니다.
참고: 어택 중에는 이 수가 1 이하이고, 릴리스 중에는 이 수가 엄격하게 1보다 큽니다.
-
어택 곡선은 반드시 \([0, 1]\) 범위에서 연속이며 단조 증가하는 함수여야 합니다. 이 곡선의 형태는
attack으로 제어할 수 있습니다. -
릴리스 곡선은 반드시 항상 1보다 크고 연속이며 단조 감소하는 함수여야 합니다. 이 곡선의 형태는
release로 제어할 수 있습니다.
이 작업은 이 함수를 compressor gain과 detector average의 비율에 적용하여 계산된 값을 반환합니다.
검출기 곡선을 어택 또는 릴리스 시의 변화율에 적용하면 적응형 릴리스를 구현할 수 있습니다. 이 함수는 반드시 다음 제약 조건을 준수해야 합니다:
-
함수의 출력은 반드시 \([0,1]\) 범위에 있어야 합니다.
-
함수는 반드시 연속이고 단조 증가해야 합니다.
참고: 예를 들어 압축이 강할수록 더 빠르게 릴리스하는 적응형 릴리스를 수행하는 컴프레서를 사용할 수 있으며, 어택과 릴리스 곡선의 형태가 서로 달라도 됩니다.
-
threshold와 knee를 각각
threshold및knee의 값을 선형 단위로 변환하고 이 블록의 처리 시점에 샘플링한 값(k-rate 매개변수)으로 둡니다. -
이 블록의 처리 시점에 역시 샘플링된(k-rate 매개변수)
threshold와knee의 합을 계산합니다. -
knee end threshold를 이 합을 선형 단위로 변환한 값으로 둡니다.
-
이 함수는 선형 threshold 값까지 항등 함수입니다(즉, \(f(x) = x\)).
-
threshold부터 knee end threshold까지 사용자 에이전트는 곡선 형태를 선택할 수 있습니다. 전체 함수는 반드시 단조 증가하고 연속이어야 합니다.
참고: knee가 0이면
DynamicsCompressorNode를 하드 니 컴프레서라고 합니다. -
이 함수는 threshold와 소프트 니 이후에는 ratio를 기반으로 한 선형 함수입니다(즉, \(f(x) = \frac{1}{ratio} \cdot x \)).
-
\(v\)가 0이면 -1000을 반환합니다.
-
그렇지 않으면 \( 20 \, \log_{10}{v} \)를 반환합니다.
1.20.
GainNode
인터페이스
오디오 신호의 게인을 변경하는 것은 오디오 애플리케이션의 기본적인
작업입니다. 이
인터페이스는 입력 하나와
출력 하나를 가진 AudioNode입니다:
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
GainNode의
입력 데이터 각 채널의 각 샘플에는 반드시
gain
AudioParam의
computedValue를
곱해야 합니다.
[Exposed =Window ]interface GainNode :AudioNode {constructor (BaseAudioContext ,context optional GainOptions = {});options readonly attribute AudioParam gain ; };
1.20.1. 생성자
GainNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.GainNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 GainNode가 연관될BaseAudioContext입니다.optionsGainOptions✘ ✔ 이 GainNode의 선택적 초기 매개변수 값입니다.
1.20.2. 속성
gain, 유형은 AudioParam, 읽기 전용-
적용할 게인의 양을 나타냅니다.
매개변수 값 참고 defaultValue1 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate"
1.20.3.
GainOptions
이는 GainNode를
생성할 때 사용할 옵션을 지정합니다. 모든
멤버는 선택 사항이며, 지정하지 않으면
노드를 생성할 때 일반적인 기본값이 사용됩니다.
dictionary GainOptions :AudioNodeOptions {float gain = 1.0; };
1.20.3.1.
GainOptions
딕셔너리 멤버
gain, 유형은 float, 기본값은1.0-
gainAudioParam의 초기 게인 값입니다.
1.21.
IIRFilterNode
인터페이스
IIRFilterNode는
일반적인 IIR
필터를 구현하는 AudioNode
프로세서입니다. 일반적으로 다음과 같은 이유로
고차 필터를 구현할 때는 BiquadFilterNode를
사용하는 것이 좋습니다:
-
일반적으로 수치 문제에 덜 민감합니다
-
필터 매개변수를 자동화할 수 있습니다
-
모든 짝수 차수 IIR 필터를 생성하는 데 사용할 수 있습니다
그러나 홀수 차수 필터는 생성할 수 없으므로, 이러한 필터가 필요하거나 자동화가 필요하지 않은 경우에는 IIR 필터가 적절할 수 있습니다.
일단 생성되면 IIR 필터의 계수는 변경할 수 없습니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 예 | 입력이 0이어도 무음이 아닌 오디오를 계속 출력합니다. 이는 IIR 필터이므로 필터는 이론적으로 무한히 0이 아닌 출력을 생성하지만, 실제로는 출력이 충분히 0에 가까워지는 유한 시간이 지난 후 이를 제한할 수 있습니다. 실제 시간은 필터 계수에 따라 달라집니다. |
출력의 채널 수는 항상 입력의 채널 수와 같습니다.
[Exposed =Window ]interface IIRFilterNode :AudioNode {constructor (BaseAudioContext ,context IIRFilterOptions );options undefined getFrequencyResponse (Float32Array ,frequencyHz Float32Array ,magResponse Float32Array ); };phaseResponse
1.21.1. 생성자
IIRFilterNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.IIRFilterNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 IIRFilterNode가 연관될BaseAudioContext입니다.optionsIIRFilterOptions✘ ✘ 이 IIRFilterNode의 초기 매개변수 값입니다.
1.21.2. 메서드
getFrequencyResponse(frequencyHz, magResponse, phaseResponse)-
현재 필터 매개변수 설정이 주어지면 지정된 주파수에 대한 주파수 응답을 동기적으로 계산합니다. 세 매개변수는 반드시 길이가 같은
Float32Array여야 하며, 그렇지 않으면InvalidAccessError를 반드시 발생시켜야 합니다.IIRFilterNode.getFrequencyResponse() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 frequencyHzFloat32Array✘ ✘ 이 매개변수는 응답 값을 계산할 주파수 배열을 Hz 단위로 지정합니다. magResponseFloat32Array✘ ✘ 이 매개변수는 선형 크기 응답 값을 받는 출력 배열을 지정합니다. frequencyHz매개변수의 값이 [0, sampleRate/2] 범위에 있지 않고, 여기서sampleRate가sampleRate속성의AudioContext값이면,magResponse배열의 동일한 인덱스에 있는 해당 값은 반드시NaN이어야 합니다.phaseResponseFloat32Array✘ ✘ 이 매개변수는 라디안 단위의 위상 응답 값을 받는 출력 배열을 지정합니다. frequencyHz매개변수의 값이 [0; sampleRate/2] 범위에 있지 않고, 여기서sampleRate가sampleRate속성의AudioContext값이면,phaseResponse배열의 동일한 인덱스에 있는 해당 값은 반드시NaN이어야 합니다.반환 유형:undefined
1.21.3.
IIRFilterOptions
IIRFilterOptions 딕셔너리는
IIRFilterNode의
필터 계수를 지정하는 데 사용됩니다.
dictionary IIRFilterOptions :AudioNodeOptions {required sequence <double >feedforward ;required sequence <double >feedback ; };
1.21.3.1.
IIRFilterOptions
딕셔너리 멤버
feedforward, 유형은 sequence<double>-
IIRFilterNode의 피드포워드 계수입니다. 이 멤버는 필수입니다. 다른 제약 조건은createIIRFilter()의feedforward인수를 참조하십시오. feedback, 유형은 sequence<double>-
IIRFilterNode의 피드백 계수입니다. 이 멤버는 필수입니다. 다른 제약 조건은createIIRFilter()의feedback인수를 참조하십시오.
1.21.4. 필터 정의
\(b_m\)을 feedforward 계수로,
\(a_n\)을 createIIRFilter()
또는 constructor의
IIRFilterOptions
딕셔너리에서 지정된 feedback 계수로 둡니다.
그러면 일반 IIR 필터의
전달 함수는 다음과 같습니다
$$
    H(z) = \frac{\sum_{m=0}^{M} b_m z^{-m}}{\sum_{n=0}^{N} a_n z^{-n}}
$$
여기서 \(M + 1\)은 \(b\) 배열의 길이이고 \(N + 1\)은
\(a\) 배열의 길이입니다. 계수 \(a_0\)는 반드시 0이 아니어야 합니다(createIIRFilter()의
feedback 매개변수
참조).
\(b_m\) 중 적어도 하나는 반드시 0이 아니어야 합니다(createIIRFilter()의
feedforward 매개변수
참조).
동일하게 시간 영역 방정식은 다음과 같습니다:
$$
    \sum_{k=0}^{N} a_k y(n-k) = \sum_{k=0}^{M} b_k x(n-k)
$$
초기 필터 상태는 모두 0인 상태입니다.
참고: 필터 상태에 NaN 값이 발생했음을 사용자에게 알리기 위해 UA가 경고를 표시할 수 있습니다. 이는 일반적으로 불안정한 필터를 나타냅니다.
1.22.
MediaElementAudioSourceNode
인터페이스
이 인터페이스는
audio
또는
video
요소의 오디오 소스를 나타냅니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
| 테일 타임 참조 | 아니요 |
출력 채널 수는
HTMLMediaElement가
참조하는 미디어의 채널 수에 대응합니다.
따라서 미디어 요소의
src 속성을 변경하면 이 노드가 출력하는 채널 수가
변경될 수 있습니다.
HTMLMediaElement의
샘플 레이트가 연관된 AudioContext의
샘플 레이트와 다르면
HTMLMediaElement의
출력을 컨텍스트의
sample rate에
맞도록 반드시 리샘플링해야 합니다.
MediaElementAudioSourceNode는
HTMLMediaElement가
주어졌을 때 AudioContext
createMediaElementSource()
메서드 또는 mediaElement
멤버의 MediaElementAudioSourceOptions
딕셔너리를 constructor에
전달하여 생성됩니다.
단일 출력의 채널 수는 createMediaElementSource()의
인수로 전달된 HTMLMediaElement가
참조하는 오디오의 채널 수와 같으며,
HTMLMediaElement에
오디오가 없으면 1입니다.
HTMLMediaElement는
MediaElementAudioSourceNode가
생성된 후에도 반드시 동일하게 동작해야 하며,
단 렌더링된 오디오는 더 이상 직접 들리지 않고
MediaElementAudioSourceNode가
라우팅 그래프를 통해 연결된 결과로 들린다는 점만 예외입니다.
따라서 일시 정지, 탐색, 음량, src
속성 변경 및 HTMLMediaElement의
기타 측면은 MediaElementAudioSourceNode와
함께 사용하지 않았을 때와 동일하게 반드시 정상적으로 동작해야 합니다.
const mediaElement= document. getElementById( 'mediaElementID' ); const sourceNode= context. createMediaElementSource( mediaElement); sourceNode. connect( filterNode);
[Exposed =Window ]interface MediaElementAudioSourceNode :AudioNode {constructor (AudioContext ,context MediaElementAudioSourceOptions ); [options SameObject ]readonly attribute HTMLMediaElement mediaElement ; };
1.22.1. 생성자
MediaElementAudioSourceNode(context, options)-
-
context와 options를 인수로 사용하여 this AudioNode를 초기화합니다.
MediaElementAudioSourceNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextAudioContext✘ ✘ 이 새로운 MediaElementAudioSourceNode가 연관될AudioContext입니다.optionsMediaElementAudioSourceOptions✘ ✘ 이 MediaElementAudioSourceNode의 초기 매개변수 값입니다. -
1.22.2. 속성
mediaElement, 유형은 HTMLMediaElement, 읽기 전용-
이
MediaElementAudioSourceNode를 생성할 때 사용한HTMLMediaElement입니다.
1.22.3.
MediaElementAudioSourceOptions
이는 MediaElementAudioSourceNode를
생성할 때 사용할 옵션을 지정합니다.
dictionary MediaElementAudioSourceOptions {required HTMLMediaElement mediaElement ; };
1.22.3.1.
MediaElementAudioSourceOptions
딕셔너리 멤버
mediaElement, 유형은 HTMLMediaElement-
다시 라우팅할 미디어 요소입니다. 이는 반드시 지정해야 합니다.
1.22.4. MediaElementAudioSourceNode 및 교차 출처 리소스의 보안
HTMLMediaElement는
교차 출처 리소스의 재생을 허용합니다.
Web Audio는 리소스의 콘텐츠를 검사할 수 있으므로
(예: MediaElementAudioSourceNode와
AudioWorkletNode
또는 ScriptProcessorNode를
사용하여 샘플을 읽는 경우), 한 출처의 스크립트가
다른 출처의
리소스 콘텐츠를 검사하면 정보
유출이 발생할 수 있습니다.
이를 방지하기 위해 MediaElementAudioSourceNode가
가져오기
알고리즘 [FETCH] 실행 시
리소스가
CORS-cross-origin으로 표시된
HTMLMediaElement를
사용하여 생성된 경우, 반드시
HTMLMediaElement의
정상 출력 대신 무음을 출력해야 합니다.
1.23.
MediaStreamAudioDestinationNode
인터페이스
이 인터페이스는 kind가 "audio"인 단일
MediaStreamTrack을
가진 MediaStream을
나타내는 오디오 대상입니다. 이 MediaStream은
노드가 생성될 때 생성되며
stream
속성을 통해 접근할 수 있습니다. 이 스트림은
getUserMedia()로
얻은 MediaStream과
유사하게 사용할 수 있으며, 예를 들어
RTCPeerConnection([webrtc]에 설명됨)의
addStream() 메서드를 사용하여 원격 피어로 전송할 수 있습니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 0 | |
channelCount
| 2 | |
channelCountMode
| "explicit"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
입력 채널 수의 기본값은 2(스테레오)입니다.
[Exposed =Window ]interface MediaStreamAudioDestinationNode :AudioNode {constructor (AudioContext ,context optional AudioNodeOptions = {});options readonly attribute MediaStream stream ; };
1.23.1. 생성자
MediaStreamAudioDestinationNode(context, options)-
-
context와 options를 인수로 사용하여 this AudioNode를 초기화합니다.
MediaStreamAudioDestinationNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextAudioContext✘ ✘ 이 새로운 MediaStreamAudioDestinationNode가 연관될BaseAudioContext입니다.optionsAudioNodeOptions✘ ✔ 이 MediaStreamAudioDestinationNode의 선택적 초기 매개변수 값입니다. -
1.23.2. 속성
stream, 유형은 MediaStream, 읽기 전용-
노드 자체와 동일한 수의 채널을 가진 단일
MediaStreamTrack을 포함하고, 해당kind속성 값이"audio"인MediaStream입니다.
1.24.
MediaStreamAudioSourceNode
인터페이스
이 인터페이스는 MediaStream의
오디오 소스를 나타냅니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
| 테일 타임 참조 | 아니요 |
출력의 채널 수는
MediaStreamTrack의
채널 수에 대응합니다.
MediaStreamTrack이
종료되면 이
AudioNode는
하나의 무음 채널을 출력합니다.
MediaStreamTrack의
샘플 레이트가 연관된 AudioContext의
샘플 레이트와 다르면
MediaStreamTrack의
출력을 컨텍스트의
sample rate에
맞도록 리샘플링합니다.
[Exposed =Window ]interface MediaStreamAudioSourceNode :AudioNode {constructor (AudioContext ,context MediaStreamAudioSourceOptions ); [options SameObject ]readonly attribute MediaStream mediaStream ; };
1.24.1. 생성자
MediaStreamAudioSourceNode(context, options)-
-
options의mediaStream멤버가kind속성 값이"audio"인MediaStreamTrack을 하나 이상 가진MediaStream을 참조하지 않으면InvalidStateError를 발생시키고 이 단계를 중단합니다. 그렇지 않으면 이 스트림을 inputStream으로 둡니다. -
tracks를 inputStream에 속하며
kind가"audio"인 모든MediaStreamTrack의 목록으로 둡니다. -
tracks의 요소를
id속성에 따라 코드 단위 값 시퀀스의 순서를 사용하여 정렬합니다. -
context와 options를 인수로 사용하여 this AudioNode를 초기화합니다.
-
이
MediaStreamAudioSourceNode의 내부 슬롯[[input track]]을 tracks의 첫 번째 요소로 설정합니다. 이것이 이MediaStreamAudioSourceNode의 입력 오디오로 사용되는 트랙입니다.
생성 후 생성자에 전달된
MediaStream이 변경되어도 이AudioNode의 기반 출력에는 영향을 주지 않습니다.슬롯
[[input track]]은MediaStreamTrack에 대한 참조를 유지하는 데만 사용됩니다.참고: 이는
MediaStreamAudioSourceNode의 생성자가 선택한 트랙을 이 생성자에 전달한MediaStream에서 제거하더라도MediaStreamAudioSourceNode는 여전히 동일한 트랙에서 입력을 가져온다는 의미입니다.참고: 출력에 사용할 트랙을 선택하는 동작은 레거시 이유로 임의적입니다. 어떤 트랙을 입력으로 사용할지 명시하려면 대신
MediaStreamTrackAudioSourceNode를 사용할 수 있습니다.MediaStreamAudioSourceNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextAudioContext✘ ✘ 이 새로운 MediaStreamAudioSourceNode가 연관될AudioContext입니다.optionsMediaStreamAudioSourceOptions✘ ✘ 이 MediaStreamAudioSourceNode의 초기 매개변수 값입니다. -
1.24.2. 속성
mediaStream, 유형은 MediaStream, 읽기 전용-
이
MediaStreamAudioSourceNode를 생성할 때 사용한MediaStream입니다.
1.24.3.
MediaStreamAudioSourceOptions
이는 MediaStreamAudioSourceNode를
생성하기 위한 옵션을 지정합니다.
dictionary MediaStreamAudioSourceOptions {required MediaStream mediaStream ; };
1.24.3.1.
MediaStreamAudioSourceOptions
딕셔너리 멤버
mediaStream, 유형은 MediaStream-
소스로 동작할 미디어 스트림입니다. 이는 반드시 지정해야 합니다.
1.25.
MediaStreamTrackAudioSourceNode
인터페이스
이 인터페이스는 MediaStreamTrack의
오디오 소스를 나타냅니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
| 테일 타임 참조 | 아니요 |
출력 채널 수는 mediaStreamTrack의
채널 수에 대응합니다.
MediaStreamTrack의
샘플 레이트가 연관된 AudioContext의
샘플 레이트와 다르면
mediaStreamTrack의
출력을
컨텍스트의 sample rate에
맞도록 리샘플링합니다.
[Exposed =Window ]interface MediaStreamTrackAudioSourceNode :AudioNode {constructor (AudioContext ,context MediaStreamTrackAudioSourceOptions ); };options
1.25.1. 생성자
MediaStreamTrackAudioSourceNode(context, options)-
-
mediaStreamTrack의kind속성이"audio"가 아니면InvalidStateError를 발생시키고 이 단계를 중단합니다. -
context와 options를 인수로 사용하여 this AudioNode를 초기화합니다.
MediaStreamTrackAudioSourceNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextAudioContext✘ ✘ 이 새로운 MediaStreamTrackAudioSourceNode가 연관될AudioContext입니다.optionsMediaStreamTrackAudioSourceOptions✘ ✘ 이 MediaStreamTrackAudioSourceNode의 초기 매개변수 값입니다. -
1.25.2.
MediaStreamTrackAudioSourceOptions
이는 MediaStreamTrackAudioSourceNode를
생성하기 위한 옵션을 지정합니다.
이는
필수입니다.
dictionary MediaStreamTrackAudioSourceOptions {required MediaStreamTrack mediaStreamTrack ; };
1.25.2.1.
MediaStreamTrackAudioSourceOptions
딕셔너리 멤버
mediaStreamTrack, 유형은 MediaStreamTrack-
소스로 동작할 미디어 스트림 트랙입니다. 이
MediaStreamTrack의kind속성이"audio"가 아니면InvalidStateError를 반드시 발생시켜야 합니다.
1.26.
OscillatorNode
인터페이스
OscillatorNode는
주기적인 파형을 생성하는 오디오 소스를
나타냅니다. 일반적으로 사용되는 몇 가지
파형으로 설정할 수 있습니다. 또한 PeriodicWave
객체를 사용하여 임의의 주기
파형으로 설정할 수 있습니다.
오실레이터는 오디오
합성에서 흔히 사용되는 기본 구성 요소입니다. OscillatorNode는
start()
메서드로 지정한 시점에 사운드 출력을 시작합니다.
수학적으로 말하면 연속 시간 주기 파형은 주파수 영역에서 볼 때 매우 높은(또는 무한히 높은) 주파수 정보를 가질 수 있습니다. 이 파형을 특정 샘플 레이트의 이산 시간 디지털 오디오 신호로 샘플링할 때는 파형을 디지털 형식으로 변환하기 전에 나이퀴스트 주파수보다 높은 고주파 정보를 반드시 제거(필터링)해야 합니다. 이렇게 하지 않으면 앨리어싱으로 인해 (나이퀴스트 주파수보다) 높은 주파수가 거울상처럼 접혀 나이퀴스트 주파수보다 낮은 주파수로 나타납니다. 많은 경우 이는 청각적으로 불쾌한 아티팩트를 유발합니다. 이는 오디오 DSP의 기본적이고 잘 알려진 원리입니다.
구현이 이러한 앨리어싱을 피하기 위해 취할 수 있는 실용적인 접근 방식은 여러 가지가 있습니다. 어떤 접근 방식을 사용하든 이상화된 이산 시간 디지털 오디오 신호는 수학적으로 명확하게 정의됩니다. 구현에서의 절충은 이 이상을 달성하는 충실도와 구현 비용(CPU 사용량 측면) 사이의 문제입니다.
구현은 이 이상을 달성하기 위해 어느 정도 주의를 기울일 것으로 예상되지만, 저사양 하드웨어에서는 품질이 낮고 비용이 적게 드는 접근 방식을 고려하는 것이 합리적입니다.
frequency와
detune는
모두 a-rate
매개변수이며 복합 매개변수를
구성합니다. 두 값은
함께 사용되어 computedOscFrequency 값을 결정합니다:
computedOscFrequency(t) = frequency(t) * pow(2, detune(t) / 1200)
각 시점에서 OscillatorNode의 순간 위상은 노드의 정확한 시작 시점에서 위상각이 0이라고 가정할 때 computedOscFrequency의 정적분입니다. 그 명목 범위는 [-나이퀴스트 주파수, 나이퀴스트 주파수]입니다.
이 노드의 단일 출력은 하나의 채널(모노)로 구성됩니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 0 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
enum {OscillatorType "sine" ,"square" ,"sawtooth" ,"triangle" ,"custom" };
| 열거형 값 | 설명 |
|---|---|
"sine"
| 사인파 |
"square"
| 듀티 주기가 0.5인 구형파 |
"sawtooth"
| 톱니파 |
"triangle"
| 삼각파 |
"custom"
| 사용자 정의 주기 파형 |
[Exposed =Window ]interface OscillatorNode :AudioScheduledSourceNode {constructor (BaseAudioContext ,context optional OscillatorOptions = {});options attribute OscillatorType type ;readonly attribute AudioParam frequency ;readonly attribute AudioParam detune ;undefined setPeriodicWave (PeriodicWave ); };periodicWave
1.26.1. 생성자
OscillatorNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.OscillatorNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 OscillatorNode가 연관될BaseAudioContext입니다.optionsOscillatorOptions✘ ✔ 이 OscillatorNode의 선택적 초기 매개변수 값입니다.
1.26.2. 속성
detune, 유형은 AudioParam, 읽기 전용-
frequency를 지정된 양만큼 오프셋하는 디튠 값(센트 단위)입니다. 기본value는 0입니다. 이 매개변수는 a-rate입니다. 이는frequency와 복합 매개변수를 구성하여 computedOscFrequency를 만듭니다. 아래에 나열된 명목 범위는 이 매개변수가frequency를 가능한 전체 주파수 범위에 걸쳐 디튠할 수 있도록 합니다.매개변수 값 참고 defaultValue0 minValue\(\approx -153600\) maxValue\(\approx 153600\) 이 값은 대략 \(1200\ \log_2 \mathrm{FLT\_MAX}\)이며, 여기서 FLT_MAX는 가장 큰 float값입니다.automationRate" a-rate" frequency, 유형은 AudioParam, 읽기 전용-
주기 파형의 주파수(Hz 단위)입니다. 기본
value는 440입니다. 이 매개변수는 a-rate입니다. 이는detune와 복합 매개변수를 구성하여 computedOscFrequency를 만듭니다. 그 명목 범위는 [-나이퀴스트 주파수, 나이퀴스트 주파수]입니다.매개변수 값 참고 defaultValue440 minValue-나이퀴스트 주파수 maxValue나이퀴스트 주파수 automationRate" a-rate" type, 유형은 OscillatorType-
주기 파형의 형태입니다. "
custom"을 제외한 모든 유형 상수 값으로 직접 설정할 수 있습니다. 그렇게 하면InvalidStateError예외를 반드시 발생시켜야 합니다.setPeriodicWave()메서드를 사용하여 사용자 정의 파형을 설정할 수 있으며, 그 결과 이 속성은 "custom"으로 설정됩니다. 기본값은 "sine"입니다. 이 속성이 설정될 때 오실레이터의 위상은 반드시 유지되어야 합니다.
1.26.3. 메서드
setPeriodicWave(periodicWave)-
PeriodicWave가 주어지면 임의의 사용자 정의 주기 파형을 설정합니다.OscillatorNode.setPeriodicWave() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 periodicWavePeriodicWave✘ ✘ 오실레이터에서 사용할 사용자 정의 파형 반환 유형:undefined
1.26.4.
OscillatorOptions
이는 OscillatorNode를
생성할 때 사용할 옵션을 지정합니다.
모든 멤버는
선택 사항이며, 지정하지 않으면 오실레이터를
생성할 때 일반적인 기본값이 사용됩니다.
dictionary OscillatorOptions :AudioNodeOptions {OscillatorType type = "sine";float frequency = 440;float detune = 0;PeriodicWave periodicWave ; };
1.26.4.1.
OscillatorOptions
딕셔너리 멤버
detune, 유형은 float, 기본값은0-
OscillatorNode의 초기 detune 값입니다. frequency, 유형은 float, 기본값은440-
OscillatorNode의 초기 주파수입니다. periodicWave, 유형은 PeriodicWave-
OscillatorNode의PeriodicWave입니다. 이를 지정하면type의 모든 유효한 값은 무시되며, "custom"이 지정된 것처럼 처리됩니다. type, 유형은 OscillatorType, 기본값은"sine"-
생성할 오실레이터의 유형입니다.
periodicWave를 지정하지 않고 이를 "custom"으로 설정하면InvalidStateError예외를 반드시 발생시켜야 합니다.periodicWave를 지정하면type의 모든 유효한 값은 무시되며, "custom"으로 설정된 것처럼 처리됩니다.
1.26.5. 기본 파형 위상
여러 오실레이터 유형의 이상적인 수학적 파형은 아래에 정의되어 있습니다. 요약하면 모든 파형은 시간 0에서 양의 기울기를 갖는 홀함수로 수학적으로 정의됩니다. 오실레이터가 생성하는 실제 파형은 앨리어싱 영향을 방지하기 위해 다를 수 있습니다.
오실레이터는 적절한 푸리에
급수를 사용하고 disableNormalization을
false로 설정한 PeriodicWave를
사용하여 이러한 기본 파형을 생성한 것과 동일한 결과를 반드시 생성해야 합니다.
- "
sine" -
사인 오실레이터의 파형은 다음과 같습니다:
$$ x(t) = \sin t $$ - "
square" -
구형파 오실레이터의 파형은 다음과 같습니다:
$$
    x(t) = \begin{cases}
                 1 & \mbox{for } 0≤ t < \pi \\
                 -1 & \mbox{for } -\pi < t < 0.
                 \end{cases}
$$
파형이 주기 \(2\pi\)인 홀함수라는 사실을 이용하여 이를 모든 \(t\)로 확장합니다.
- "
sawtooth" -
톱니파 오실레이터의 파형은 다음 램프입니다:
$$
    x(t) = \frac{t}{\pi} \mbox{ for } -\pi < t ≤ \pi;
$$
파형이 주기 \(2\pi\)인 홀함수라는 사실을 이용하여 이를 모든 \(t\)로 확장합니다.
- "
triangle" -
삼각파 오실레이터의 파형은 다음과 같습니다:
$$
    x(t) = \begin{cases}
                     \frac{2}{\pi} t & \mbox{for } 0 ≤ t ≤ \frac{\pi}{2} \\
                     1-\frac{2}{\pi} \left(t-\frac{\pi}{2}\right) & \mbox{for }
                     \frac{\pi}{2} < t ≤ \pi.
                 \end{cases}
$$
파형이 주기 \(2\pi\)인 홀함수라는 사실을 이용하여 이를 모든 \(t\)로 확장합니다.
1.27.
PannerNode
인터페이스
이 인터페이스는 들어오는 오디오
스트림을 3차원 공간에 배치/공간화하는 처리 노드를 나타냅니다.
공간화는 BaseAudioContext의
AudioListener
(listener
속성)를 기준으로 합니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | channelCount 제약 조건이 있습니다 |
channelCountMode
| "clamped-max"
| channelCountMode 제약 조건이 있습니다 |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 경우에 따라 있음 | panningModel이
"HRTF"로
설정되면 헤드 응답의 고유한 처리로 인해 무음 입력에 대해서도
노드가 무음이 아닌 출력을 생성합니다. 그렇지 않으면 테일 타임은 0입니다.
|
이 노드의 입력은 모노(1채널) 또는 스테레오(2채널)이며 늘릴 수 없습니다. 채널 수가 더 적거나 많은 노드에서 오는 연결은 적절하게 업 믹싱 또는 다운 믹싱됩니다.
노드가 활성 처리 중이면 이 노드의 출력은 스테레오(2채널)로 고정되며 구성할 수 없습니다. 노드가 활성 처리 중이 아니면 출력은 단일 무음 채널입니다.
PanningModelType
열거형은 오디오를 3D
공간에 배치하는 데 사용할 공간화 알고리즘을 결정합니다.
기본값은 "equalpower"입니다.
enum {PanningModelType "equalpower" ,"HRTF" };
| 열거형 값 | 설명 |
|---|---|
"equalpower"
|
등전력 패닝을 사용하는 간단하고 효율적인
공간화 알고리즘입니다.
참고: 이 패닝 모델을
사용할 때 이 노드의 출력을 계산하는 데 사용되는 모든 |
"HRTF"
|
사람 피험자에게서 측정한 임펄스 응답과의 컨볼루션을
사용하는 고품질 공간화 알고리즘입니다. 이 패닝
방식은 스테레오 출력을 렌더링합니다.
참고:이 패닝 모델을
사용할 때 이 노드의 출력을 계산하는 데 사용되는 모든 |
PannerNode의
AudioParam에
대한 유효
자동화 속도는
panningModel과
AudioParam의
automationRate에
의해 결정됩니다.
panningModel이
"HRTF"이면
유효
자동화 속도는 automationRate
설정과 관계없이 "k-rate"입니다.
그렇지 않으면 유효
자동화 속도는
automationRate의
값입니다.
DistanceModelType
열거형은 오디오 소스가
리스너로부터 멀어질 때 음량을 줄이는 데 사용할
알고리즘을 결정합니다. 기본값은 "inverse"입니다.
아래 각 거리 모델의 설명에서 \(d\)를
리스너와 패너 사이의 거리로, \(d_{ref}\)를
refDistance
속성의 값으로, \(d_{max}\)를
maxDistance
속성의 값으로, \(f\)를
rolloffFactor
속성의 값으로 둡니다.
enum {DistanceModelType "linear" ,"inverse" ,"exponential" };
| 열거형 값 | 설명 |
|---|---|
"linear"
|
다음에 따라 distanceGain을 계산하는
선형 거리 모델입니다:
$$
    1 - f\ \frac{\max\left[\min\left(d, d'_{max}\right), d'_{ref}\right] - d'_{ref}}{d'_{max} - d'_{ref}}
$$
여기서 \(d’_{ref} = \min\left(d_{ref}, d_{max}\right)\)이고 \(d’_{max} = \max\left(d_{ref}, d_{max}\right)\)입니다. \(d’_{ref} = d’_{max}\)인 경우 선형 모델의 값은 \(1-f\)로 간주됩니다. \(d\)는 \(\left[d’_{ref},\, d’_{max}\right]\) 구간으로 제한된다는 점에 유의하십시오. |
"inverse"
|
다음에 따라
distanceGain을 계산하는 역 거리 모델입니다:
$$
    \frac{d_{ref}}{d_{ref} + f\ \left[\max\left(d, d_{ref}\right) - d_{ref}\right]}
$$
즉, \(d\)는 \(\left[d_{ref},\, \infty\right)\) 구간으로 제한됩니다. \(d_{ref} = 0\)이면 역 모델의 값은 \(d\)와 \(f\)의 값에 관계없이 0으로 간주됩니다. |
"exponential"
|
다음에 따라
distanceGain을 계산하는 지수 거리 모델입니다:
$$
    \left[\frac{\max\left(d, d_{ref}\right)}{d_{ref}}\right]^{-f}
$$
즉, \(d\)는 \(\left[d_{ref},\, \infty\right)\) 구간으로 제한됩니다. \(d_{ref} = 0\)이면 지수 모델의 값은 \(d\)와 \(f\)에 관계없이 0으로 간주됩니다. |
[Exposed =Window ]interface PannerNode :AudioNode {constructor (BaseAudioContext ,context optional PannerOptions = {});options attribute PanningModelType panningModel ;readonly attribute AudioParam positionX ;readonly attribute AudioParam positionY ;readonly attribute AudioParam positionZ ;readonly attribute AudioParam orientationX ;readonly attribute AudioParam orientationY ;readonly attribute AudioParam orientationZ ;attribute DistanceModelType distanceModel ;attribute double refDistance ;attribute double maxDistance ;attribute double rolloffFactor ;attribute double coneInnerAngle ;attribute double coneOuterAngle ;attribute double coneOuterGain ;undefined setPosition (float ,x float ,y float );z undefined setOrientation (float ,x float ,y float ); };z
1.27.1. 생성자
PannerNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.PannerNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 PannerNode가 연관될BaseAudioContext입니다.optionsPannerOptions✘ ✔ 이 PannerNode의 선택적 초기 매개변수 값입니다.
1.27.2. 속성
coneInnerAngle, 유형은 double-
방향성 오디오 소스를 위한 매개변수로, 이 각도(도 단위) 안에서는 음량이 감소하지 않습니다. 기본값은 360입니다. 각도가 [0, 360] 구간을 벗어나면 동작은 정의되지 않습니다.
coneOuterAngle, 유형은 double-
방향성 오디오 소스를 위한 매개변수로, 이 각도(도 단위) 밖에서는 음량이
coneOuterGain의 일정한 값으로 감소합니다. 기본값은 360입니다. 각도가 [0, 360] 구간을 벗어나면 동작은 정의되지 않습니다. coneOuterGain, 유형은 double-
방향성 오디오 소스를 위한 매개변수로,
coneOuterAngle바깥의 게인입니다. 기본값은 0입니다. 이는 [0, 1] 범위의 선형 값(dB가 아님)입니다. 매개변수가 이 범위를 벗어나면InvalidStateError를 반드시 발생시켜야 합니다. distanceModel, 유형은 DistanceModelType-
이
PannerNode에서 사용하는 거리 모델을 지정합니다. 기본값은 "inverse"입니다. maxDistance, 유형은 double-
소스와 리스너 사이의 최대 거리로, 이 거리를 넘으면 음량이 더 이상 감소하지 않습니다. 기본값은 10000입니다. 이를 양수가 아닌 값으로 설정하면
RangeError예외를 반드시 발생시켜야 합니다. orientationX, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 오디오 소스가 가리키는 방향 벡터의 \(x\) 성분을 설명합니다.
매개변수 값 참고 defaultValue1 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate"자동화 속도 제약 조건이 있습니다 orientationY, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 오디오 소스가 가리키는 방향 벡터의 \(y\) 성분을 설명합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate"자동화 속도 제약 조건이 있습니다 orientationZ, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표 공간에서 오디오 소스가 가리키는 방향 벡터의 \(z\) 성분을 설명합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate"자동화 속도 제약 조건이 있습니다 panningModel, 유형은 PanningModelType-
이
PannerNode에서 사용하는 패닝 모델을 지정합니다. 기본값은 "equalpower"입니다. positionX, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표계에서 오디오 소스의 \(x\) 좌표 위치를 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate"자동화 속도 제약 조건이 있습니다 positionY, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표계에서 오디오 소스의 \(y\) 좌표 위치를 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate"자동화 속도 제약 조건이 있습니다 positionZ, 유형은 AudioParam, 읽기 전용-
3D 데카르트 좌표계에서 오디오 소스의 \(z\) 좌표 위치를 설정합니다.
매개변수 값 참고 defaultValue0 minValue가장 음수인 단정밀도 부동소수점 값 약 -3.4028235e38 maxValue가장 양수인 단정밀도 부동소수점 값 약 3.4028235e38 automationRate" a-rate"자동화 속도 제약 조건이 있습니다 refDistance, 유형은 double-
소스가 리스너에서 더 멀어질 때 음량을 줄이기 위한 기준 거리입니다. 이보다 짧은 거리에서는 음량이 감소하지 않습니다. 기본값은 1입니다. 이를 음수 값으로 설정하면
RangeError예외를 반드시 발생시켜야 합니다. rolloffFactor, 유형은 double-
소스가 리스너에서 멀어질 때 음량이 얼마나 빠르게 감소하는지 설명합니다. 기본값은 1입니다. 이를 음수 값으로 설정하면
RangeError예외를 반드시 발생시켜야 합니다.rolloffFactor의 명목 범위는rolloffFactor가 가질 수 있는 최솟값과 최댓값을 지정합니다. 범위를 벗어난 값은 이 범위 안에 있도록 제한됩니다. 명목 범위는distanceModel에 따라 다음과 같이 달라집니다:- "
linear" -
명목 범위는 \([0, 1]\)입니다.
- "
inverse" -
명목 범위는 \([0, \infty)\)입니다.
- "
exponential" -
명목 범위는 \([0, \infty)\)입니다.
이 제한은 거리 계산 처리의 일부로 수행된다는 점에 유의하십시오. 속성은 설정된 값을 반영하며 수정되지 않습니다.
- "
1.27.3. 메서드
setOrientation(x, y, z)-
이 메서드는 사용 중단되었습니다. 이는
orientationX.value,orientationY.value, 및orientationZ.value속성을 각각x,y및z매개변수로 직접 설정하는 것과 같습니다.따라서
orientationX,orientationY, 및orientationZAudioParam중 하나라도 이 메서드가 호출될 때setValueCurveAtTime()을 사용하여 자동화 곡선이 설정되어 있으면NotSupportedError를 반드시 발생시켜야 합니다.3D 데카르트 좌표 공간에서 오디오 소스가 가리키는 방향을 설명합니다. 사운드의 방향성이 얼마나 강한지 (cone 속성으로 제어됨)에 따라 리스너 반대쪽을 향하는 사운드는 매우 작게 들리거나 완전히 무음이 될 수 있습니다.
x, y, z매개변수는 3D 공간의 방향 벡터를 나타냅니다.기본값은 (1,0,0)입니다.
PannerNode.setOrientation() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 xfloat✘ ✘ yfloat✘ ✘ zfloat✘ ✘ 반환 유형:undefined setPosition(x, y, z)-
이 메서드는 사용 중단되었습니다. 이는
positionX.value,positionY.value, 및positionZ.value속성을 각각x,y및z매개변수로 직접 설정하는 것과 같습니다.따라서
positionX,positionY, 및positionZAudioParam중 하나라도 이 메서드가 호출될 때setValueCurveAtTime()을 사용하여 자동화 곡선이 설정되어 있으면NotSupportedError를 반드시 발생시켜야 합니다.listener속성을 기준으로 오디오 소스의 위치를 설정합니다. 3D 데카르트 좌표계를 사용합니다.x, y, z매개변수는 3D 공간의 좌표를 나타냅니다.기본값은 (0,0,0)입니다.
PannerNode.setPosition() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 xfloat✘ ✘ yfloat✘ ✘ zfloat✘ ✘ 반환 유형:undefined
1.27.4.
PannerOptions
이는 PannerNode를
생성하기 위한 옵션을 지정합니다.
모든 멤버는 선택 사항이며, 지정하지 않으면
노드를 생성할 때 일반적인 기본값을 사용합니다.
dictionary PannerOptions :AudioNodeOptions {PanningModelType panningModel = "equalpower";DistanceModelType distanceModel = "inverse";float positionX = 0;float positionY = 0;float positionZ = 0;float orientationX = 1;float orientationY = 0;float orientationZ = 0;double refDistance = 1;double maxDistance = 10000;double rolloffFactor = 1;double coneInnerAngle = 360;double coneOuterAngle = 360;double coneOuterGain = 0; };
1.27.4.1.
PannerOptions
딕셔너리 멤버
coneInnerAngle, 유형은 double, 기본값은360-
노드의
coneInnerAngle속성의 초기값입니다. coneOuterAngle, 유형은 double, 기본값은360-
노드의
coneOuterAngle속성의 초기값입니다. coneOuterGain, 유형은 double, 기본값은0-
노드의
coneOuterGain속성의 초기값입니다. distanceModel, 유형은 DistanceModelType, 기본값은"inverse"-
노드에 사용할 거리 모델입니다.
maxDistance, 유형은 double, 기본값은10000-
노드의
maxDistance속성의 초기값입니다. orientationX, 유형은 float, 기본값은1-
orientationXAudioParam의 초기 \(x\) 성분 값입니다. orientationY, 유형은 float, 기본값은0-
orientationYAudioParam의 초기 \(y\) 성분 값입니다. orientationZ, 유형은 float, 기본값은0-
orientationZAudioParam의 초기 \(z\) 성분 값입니다. panningModel, 유형은 PanningModelType, 기본값은"equalpower"-
노드에 사용할 패닝 모델입니다.
positionX, 유형은 float, 기본값은0-
positionXAudioParam의 초기 \(x\) 좌표 값입니다. positionY, 유형은 float, 기본값은0-
positionYAudioParam의 초기 \(y\) 좌표 값입니다. positionZ, 유형은 float, 기본값은0-
positionZAudioParam의 초기 \(z\) 좌표 값입니다. refDistance, 유형은 double, 기본값은1-
노드의
refDistance속성의 초기값입니다. rolloffFactor, 유형은 double, 기본값은1-
노드의
rolloffFactor속성의 초기값입니다.
1.27.5. 채널 제한
StereoPannerNode의
채널
제한 집합은
PannerNode에도
적용됩니다.
1.28.
PeriodicWave
인터페이스
PeriodicWave는
OscillatorNode와
함께 사용할 임의의 주기 파형을 나타냅니다.
적합한 구현은 최소 8192개 요소까지의 PeriodicWave를
반드시 지원해야 합니다.
[Exposed =Window ]interface PeriodicWave {constructor (BaseAudioContext ,context optional PeriodicWaveOptions = {}); };options
1.28.1. 생성자
PeriodicWave(context, options)-
-
p를 새
PeriodicWave객체로 둡니다.[[real]]과[[imag]]를Float32Array유형의 두 내부 슬롯으로 두고,[[normalize]]를 내부 슬롯으로 둡니다. -
options를 다음 경우 중 하나에 따라 처리합니다:-
options.real과options.imag가 모두 존재하는 경우-
options.real과options.imag의 길이가 서로 다르거나 둘 중 하나의 길이가 2보다 작으면IndexSizeError를 발생시키고 이 알고리즘을 중단합니다. -
[[real]]과[[imag]]를options.real과 길이가 같은 새 배열로 설정합니다. -
options.real의 모든 요소를[[real]]로,options.imag의 모든 요소를[[imag]]로 복사합니다.
-
-
options.real만 존재하는 경우-
options.real의 길이가 2보다 작으면IndexSizeError를 발생시키고 이 알고리즘을 중단합니다. -
[[real]]과[[imag]]를options.real과 길이가 같은 배열로 설정합니다. -
options.real을[[real]]로 복사하고[[imag]]을 모두 0으로 설정합니다.
-
-
options.imag만 존재하는 경우-
options.imag의 길이가 2보다 작으면IndexSizeError를 발생시키고 이 알고리즘을 중단합니다. -
[[real]]과[[imag]]를options.imag와 길이가 같은 배열로 설정합니다. -
options.imag을[[imag]]로 복사하고[[real]]을 모두 0으로 설정합니다.
-
-
그 밖의 경우
참고: 이
PeriodicWave를OscillatorNode에 설정하면 이는 내장 유형 "sine"을 사용하는 것과 같습니다.
-
-
[[real]]과[[imag]]모두의 인덱스 0에 있는 요소를 0으로 설정합니다. (이는 DC 성분을 0으로 설정합니다.) -
[[normalize]]를PeriodicWaveOptions의PeriodicWaveConstraints에 있는disableNormalization속성 값의 반대로 초기화합니다. -
p를 반환합니다.
PeriodicWave.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 PeriodicWave가 연관될BaseAudioContext입니다.AudioBuffer와 달리PeriodicWave는 여러AudioContext또는OfflineAudioContext간에 공유할 수 없습니다. 이는 특정BaseAudioContext와 연관됩니다.optionsPeriodicWaveOptions✘ ✔ 이 PeriodicWave의 선택적 초기 매개변수 값입니다. -
1.28.2.
PeriodicWaveConstraints
PeriodicWaveConstraints
딕셔너리는 파형을 어떻게 정규화할지
지정하는 데 사용됩니다.
dictionary PeriodicWaveConstraints {boolean disableNormalization =false ; };
1.28.2.1.
PeriodicWaveConstraints
딕셔너리 멤버
disableNormalization, 유형은 boolean, 기본값은false-
주기 파형을 정규화할지 여부를 제어합니다.
true이면 파형을 정규화하지 않으며, 그렇지 않으면 파형을 정규화합니다.
1.28.3.
PeriodicWaveOptions
PeriodicWaveOptions
딕셔너리는 파형을 어떻게 생성할지
지정하는 데 사용됩니다. real
또는 imag
중 하나만 지정된 경우, 다른 하나는 아래
딕셔너리 멤버 설명에서
지정된 대로 같은 길이의 모든 요소가 0인 배열인 것처럼
처리됩니다. 둘 다 주어지지 않으면
PeriodicWave가
생성되며, 이는 OscillatorNode의
type이
"sine"인
것과
반드시 동등해야 합니다. 둘 다 주어지면 시퀀스의 길이는 반드시 같아야 하며,
그렇지 않으면 NotSupportedError
유형의 오류를 반드시 발생시켜야 합니다.
dictionary PeriodicWaveOptions :PeriodicWaveConstraints {sequence <float >real ;sequence <float >imag ; };
1.28.3.1.
PeriodicWaveOptions
딕셔너리 멤버
imag, 유형은 sequence<float>-
imag매개변수는sine항의 배열을 나타냅니다. 첫 번째 요소(인덱스 0)는 푸리에 급수에 존재하지 않습니다. 두 번째 요소 (인덱스 1)는 기본 주파수를 나타냅니다. 세 번째 요소는 첫 번째 배음을 나타내며, 이후도 같은 방식입니다. real, 유형은 sequence<float>-
real매개변수는cosine항의 배열을 나타냅니다. 첫 번째 요소(인덱스 0)는 주기 파형의 DC 오프셋입니다. 두 번째 요소 (인덱스 1)는 기본 주파수를 나타냅니다. 세 번째 요소는 첫 번째 배음을 나타내며, 이후도 같은 방식입니다.
1.28.4. 파형 생성
createPeriodicWave()
메서드는 두 배열을 받아
PeriodicWave의
푸리에 계수를 지정합니다.
\(a\)와 \(b\)를 각각 길이가 \(L\)인 [[real]]
및 [[imag]]
배열이라고 둡니다. 그러면 기본 시간 영역 파형
\(x(t)\)는 다음과 같이 계산할 수 있습니다:
$$
    x(t) = \sum_{k=1}^{L-1} \left[a[k]\cos2\pi k t + b[k]\sin2\pi k t\right]
$$
이것이 기본(정규화되지 않은) 파형입니다.
1.28.5. 파형 정규화
이 PeriodicWave의
내부 슬롯 [[normalize]]가
true(기본값)이면
이전 절에서 정의한 파형은 최댓값이 1이 되도록 정규화됩니다.
정규화는 다음과 같이 수행됩니다.
다음과 같이 둡니다
$$
    \tilde{x}(n) = \sum_{k=1}^{L-1} \left(a[k]\cos\frac{2\pi k n}{N} + b[k]\sin\frac{2\pi k n}{N}\right)
$$
여기서 \(N\)은 2의 거듭제곱입니다. (참고: \(\tilde{x}(n)\)은 역 FFT를 사용하여 편리하게 계산할 수 있습니다.) 고정 정규화 계수 \(f\)는 다음과 같이 계산합니다.
$$
    f = \max_{n = 0, \ldots, N - 1} |\tilde{x}(n)|
$$
따라서 실제 정규화된 파형 \(\hat{x}(n)\)은 다음과 같습니다:
$$
    \hat{x}(n) = \frac{\tilde{x}(n)}{f}
$$
이 고정 정규화 계수는 생성된 모든 파형에 반드시 적용해야 합니다.
1.28.6. 오실레이터 계수
내장 오실레이터 유형은 PeriodicWave
객체를 사용하여 생성됩니다. 완전성을 위해 각 내장 오실레이터 유형에 대한
PeriodicWave의
계수를 여기에 제시합니다. 이는 내장 유형을 원하지만
기본 정규화를 사용하지 않으려는 경우 유용합니다.
다음 설명에서 \(a\)를 createPeriodicWave()의
실수 계수 배열로, \(b\)를 허수 계수 배열로 둡니다.
모든 경우에서 파형은 홀함수이므로 모든 \(n\)에 대해 \(a[n] = 0\)입니다.
또한 모든 경우에서 \(b[0] = 0\)입니다. 따라서 아래에서는
\(n \ge 1\)인 \(b[n]\)만 지정합니다.
- "
sine" -
$$ b[n] = \begin{cases} 1 & \mbox{for } n = 1 \\ 0 & \mbox{otherwise} \end{cases} $$ - "
square" -
$$ b[n] = \frac{2}{n\pi}\left[1 - (-1)^n\right] $$ - "
sawtooth" -
$$ b[n] = (-1)^{n+1} \dfrac{2}{n\pi} $$ - "
triangle" -
$$
    b[n] = \frac{8\sin\dfrac{n\pi}{2}}{(\pi n)^2}
$$
1.29.
ScriptProcessorNode
인터페이스 - 사용 중단됨
이 인터페이스는 스크립트를 사용하여 오디오를 직접
생성, 처리 또는 분석할 수 있는 AudioNode입니다.
이 노드 유형은 사용 중단되었으며
AudioWorkletNode로
대체됩니다. 구현에서 이 노드 유형을 제거할 때까지
이 텍스트는 정보 제공 목적으로만 존재합니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| numberOfInputChannels
| 이 노드를 생성할 때 지정한 채널 수입니다. channelCount 제약 조건이 있습니다. |
channelCountMode
| "explicit"
| channelCountMode 제약 조건이 있습니다 |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
ScriptProcessorNode는
다음 값 중 하나여야 하는 bufferSize로
생성됩니다: 256,
512, 1024, 2048, 4096, 8192, 16384. 이 값은
audioprocess
이벤트가 얼마나 자주 디스패치되는지와
각 호출에서 처리해야 하는 샘플 프레임 수를 제어합니다. audioprocess
이벤트는 ScriptProcessorNode에
하나 이상의 입력 또는 출력이 연결된 경우에만
디스패치됩니다. 더 작은 bufferSize
값은
더 낮은(더 나은) 지연 시간을 만듭니다. 더 큰 값은
오디오 끊김과 글리치를 방지하는 데 필요합니다. 이 값은
createScriptProcessor()의
bufferSize 인수가 전달되지 않았거나 0으로 설정된 경우
구현에서 선택합니다.
numberOfInputChannels
및 numberOfOutputChannels는
입력 및 출력 채널 수를 결정합니다. numberOfInputChannels와
numberOfOutputChannels가
둘 다 0인 것은 유효하지 않습니다.
[Exposed =Window ]interface ScriptProcessorNode :AudioNode {attribute EventHandler onaudioprocess ;readonly attribute long bufferSize ; };
1.29.1. 속성
bufferSize, 유형은 long, 읽기 전용-
audioprocess가 발생할 때마다 처리해야 하는 버퍼의 크기(샘플 프레임 단위)입니다. 유효한 값은 (256, 512, 1024, 2048, 4096, 8192, 16384)입니다. onaudioprocess, 유형은 EventHandler-
ScriptProcessorNode노드 유형에 디스패치되는audioprocess이벤트 유형에 대한 이벤트 핸들러를 설정하는 데 사용하는 속성입니다. 이벤트 핸들러에 디스패치되는 이벤트는AudioProcessingEvent인터페이스를 사용합니다.
1.30.
StereoPannerNode
인터페이스
이 인터페이스는 저비용 패닝 알고리즘을 사용하여 들어오는 오디오 스트림을 스테레오 이미지에 배치하는 처리 노드를 나타냅니다. 이 패닝 효과는 스테레오 스트림에서 오디오 구성 요소를 배치할 때 일반적으로 사용됩니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | channelCount 제약 조건이 있습니다 |
channelCountMode
| "clamped-max"
| channelCountMode 제약 조건이 있습니다 |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 아니요 |
이 노드의 입력은 스테레오(2채널)이며 늘릴 수 없습니다. 채널 수가 더 적거나 많은 노드에서 오는 연결은 적절하게 업 믹싱 또는 다운 믹싱됩니다.
이 노드의 출력은 스테레오(2채널)로 고정되며 구성할 수 없습니다.
[Exposed =Window ]interface StereoPannerNode :AudioNode {constructor (BaseAudioContext ,context optional StereoPannerOptions = {});options readonly attribute AudioParam pan ; };
1.30.1. 생성자
StereoPannerNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.StereoPannerNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 StereoPannerNode가 연관될BaseAudioContext입니다.optionsStereoPannerOptions✘ ✔ 이 StereoPannerNode의 선택적 초기 매개변수 값입니다.
1.30.2. 속성
pan, 유형은 AudioParam, 읽기 전용-
출력의 스테레오 이미지에서 입력의 위치입니다. -1은 완전한 왼쪽을, +1은 완전한 오른쪽을 나타냅니다.
매개변수 값 참고 defaultValue0 minValue-1 maxValue1 automationRate" a-rate"
1.30.3.
StereoPannerOptions
이는 StereoPannerNode를
생성할 때 사용할 옵션을 지정합니다.
모든 멤버는 선택 사항이며, 지정하지 않으면
노드를 생성할 때 일반적인 기본값을 사용합니다.
dictionary StereoPannerOptions :AudioNodeOptions {float pan = 0; };
1.30.3.1.
StereoPannerOptions
딕셔너리 멤버
pan, 유형은 float, 기본값은0-
panAudioParam의 초기값입니다.
1.30.4. 채널 제한
처리가 위의 정의에 의해 제한되므로
StereoPannerNode는
최대 2채널의 오디오만 믹싱하고 정확히 2채널을
생성하도록 제한됩니다. ChannelSplitterNode,
GainNode 및/또는
기타 노드로 구성된 하위 그래프를 통한 중간 처리,
그리고 ChannelMergerNode를
통한 재결합을 사용하여 임의의
패닝 및 믹싱 방식을 구현할 수 있습니다.
1.31.
WaveShaperNode
인터페이스
WaveShaperNode는
비선형 왜곡 효과를 구현하는
AudioNode
프로세서입니다.
비선형 웨이브셰이핑 왜곡은 미묘한 비선형 워밍 효과와 더 분명한 왜곡 효과 모두에 일반적으로 사용됩니다. 임의의 비선형 셰이핑 곡선을 지정할 수 있습니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 경우에 따라 있음 | oversample
속성이 "2x"
또는 "4x"로
설정된 경우에만 테일 타임이 있습니다.
이 테일 타임의 실제 지속 시간은
구현에 따라 달라집니다.
|
출력의 채널 수는 항상 입력의 채널 수와 같습니다.
enum {OverSampleType "none" ,"2x" ,"4x" };
| 열거형 값 | 설명 |
|---|---|
"none"
| 오버샘플링하지 않음 |
"2x"
| 두 배로 오버샘플링 |
"4x"
| 네 배로 오버샘플링 |
[Exposed =Window ]interface WaveShaperNode :AudioNode {constructor (BaseAudioContext ,context optional WaveShaperOptions = {});options attribute Float32Array ?curve ;attribute OverSampleType oversample ; };
1.31.1. 생성자
WaveShaperNode(context, options)-
생성자가
BaseAudioContextc와 옵션 객체 option으로 호출되면 사용자 에이전트는 context와 options를 인수로 사용하여 this AudioNode를 반드시 초기화해야 합니다.또한
[[curve set]]을 이WaveShaperNode의 내부 슬롯으로 둡니다. 이 슬롯을false로 초기화합니다.options가 주어지고curve를 지정하면[[curve set]]을true로 설정합니다.WaveShaperNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 WaveShaperNode가 연관될BaseAudioContext입니다.optionsWaveShaperOptions✘ ✔ 이 WaveShaperNode의 선택적 초기 매개변수 값입니다.
1.31.2. 속성
curve, 유형은 Float32Array, 널 허용-
웨이브셰이핑 효과에 사용하는 셰이핑 곡선입니다. 입력 신호는 명목상 [-1, 1] 범위 내에 있습니다. 이 범위의 각 입력 샘플은 셰이핑 곡선의 인덱스로 사용되며, 배열의 항목 수가 홀수이면 신호 레벨 0이 곡선 배열의 중앙 값에 대응하고, 배열의 항목 수가 짝수이면 가장 중앙에 있는 두 값 사이를 보간합니다. -1보다 작은 모든 샘플 값은 곡선 배열의 첫 번째 값에 대응합니다. +1보다 큰 모든 샘플 값은 곡선 배열의 마지막 값에 대응합니다.
구현은 곡선에서 인접한 지점 사이를 반드시 선형 보간해야 합니다. 처음에 curve 속성은 null이며, 이는 WaveShaperNode가 입력을 수정하지 않고 출력으로 전달함을 의미합니다.
곡선 값은 [-1; 1] 범위에 동일한 간격으로 배치됩니다. 즉
curve의 값 개수가 짝수이면 신호가 0일 때의 값이 없으며,curve의 값 개수가 홀수이면 신호가 0일 때의 값이 있습니다. 출력은 다음 알고리즘으로 결정됩니다.-
\(x\)를 입력 샘플, \(y\)를 노드의 대응하는 출력, \(c_k\)를
curve의 \(k\)번째 요소, \(N\)을curve의 길이로 둡니다. -
다음과 같이 둡니다
$$ \begin{align*} v &= \frac{N-1}{2}(x + 1) \\ k &= \lfloor v \rfloor \\ f &= v - k \end{align*} $$ -
그러면
$$
    \begin{align*}
    y &=
        \begin{cases}
        c_0 & v \lt 0 \\
        c_{N-1} & v \ge N - 1 \\
        (1-f)\,c_k + fc_{k+1} & \mathrm{otherwise}
        \end{cases}
    \end{align*}
$$
이 속성에
length가 2보다 작은Float32Array를 설정하면InvalidStateError를 반드시 발생시켜야 합니다.이 속성이 설정되면
WaveShaperNode가 곡선의 내부 복사본을 생성합니다. 따라서 이후 속성을 설정하는 데 사용한 배열의 내용을 수정해도 아무런 효과가 없습니다.curve속성을 설정하려면 다음 단계를 실행합니다:-
new curve를
Float32Array또는null인curve에 할당할 값으로 둡니다. . -
new curve가
null이 아니고[[curve set]]이 true이면InvalidStateError를 발생시키고 이 단계를 중단합니다. -
new curve가
null이 아니면[[curve set]]을 true로 설정합니다. -
new curve를
curve속성에 할당합니다.
참고: 입력 값 0에 대해 0이 아닌 출력 값을 생성하는 곡선을 사용하면 이 노드에 입력이 연결되어 있지 않더라도 이 노드가 DC 신호를 생성합니다. 이는 노드가 다운스트림 노드에서 연결 해제될 때까지 계속됩니다.
-
oversample, 유형은 OverSampleType-
셰이핑 곡선을 적용할 때 사용할 오버샘플링 유형(있는 경우)을 지정합니다. 기본값은 "
none"이며, 이는 곡선을 입력 샘플에 직접 적용한다는 의미입니다. "2x" 또는 "4x" 값은 일부 앨리어싱을 피함으로써 처리 품질을 향상시킬 수 있으며, "4x" 값이 가장 높은 품질을 제공합니다. 일부 애플리케이션에서는 매우 정밀한 셰이핑 곡선을 얻기 위해 오버샘플링을 사용하지 않는 편이 더 좋습니다."2x" 또는 "4x" 값은 다음 단계를 반드시 수행해야 함을 의미합니다:-
입력 샘플을
AudioContext의 샘플 레이트의 2배 또는 4배로 업샘플링합니다. 따라서 각 렌더 퀀텀마다 2x인 경우 두 배, 4x인 경우 네 배의 샘플을 생성합니다. -
셰이핑 곡선을 적용합니다.
-
결과를
AudioContext의 샘플 레이트로 다시 다운샘플링합니다. 따라서 앞서 처리한 샘플에서 최종 결과로 렌더 퀀텀 하나 분량의 샘플을 생성합니다.
정확한 업샘플링 및 다운샘플링 필터는 지정되지 않으며, 음질(낮은 앨리어싱 등), 낮은 지연 시간 또는 성능에 맞게 조정할 수 있습니다.
참고: 오버샘플링을 사용하면 업샘플링 및 다운샘플링 필터 때문에 어느 정도의 오디오 처리 지연 시간이 발생합니다. 이 지연 시간의 양은 구현마다 다를 수 있습니다.
-
1.31.3.
WaveShaperOptions
이는 WaveShaperNode를
생성하기 위한 옵션을 지정합니다.
모든 멤버는 선택 사항이며, 지정하지 않으면
노드를 생성할 때 일반적인 기본값을 사용합니다.
dictionary WaveShaperOptions :AudioNodeOptions {sequence <float >curve ;OverSampleType oversample = "none"; };
1.31.3.1.
WaveShaperOptions
딕셔너리 멤버
curve, 유형은 sequence<float>-
웨이브셰이핑 효과의 셰이핑 곡선입니다.
oversample, 유형은 OverSampleType, 기본값은"none"-
셰이핑 곡선에 사용할 오버샘플링 유형입니다.
1.32.
AudioWorklet
인터페이스
[Exposed =Window ,SecureContext ]interface AudioWorklet :Worklet {readonly attribute MessagePort port ; };
1.32.1. 속성
port, 유형은 MessagePort, 읽기 전용-
MessagePort로,AudioWorkletGlobalScope의 포트에 연결되어 있습니다.참고: 이
port의"message"이벤트에 이벤트 리스너를 등록한 작성자는 리소스를 수집할 수 있도록MessageChannel의 어느 한쪽 끝(AudioWorklet또는AudioWorkletGlobalScope쪽)에close를 호출해야 합니다.
1.32.2. 개념
AudioWorklet
객체를 통해 개발자는 렌더링 스레드에서
오디오를 처리하기 위한 스크립트
(JavaScript 또는 WebAssembly 코드 등)를 제공하여 사용자 정의 AudioNode를
지원할 수 있습니다. 이
처리 메커니즘은 오디오 그래프의 다른 내장 AudioNode와
스크립트 코드가 동기적으로 실행되도록 보장합니다.
이 메커니즘을 구현하려면 연관된 객체 쌍인
AudioWorkletNode와
AudioWorkletProcessor를
반드시 정의해야 합니다.
전자는 다른 AudioNode
객체와 유사하게 메인 전역 스코프의 인터페이스를 나타내고,
후자는 AudioWorkletGlobalScope라는
특수 스코프 내에서 내부 오디오 처리를 구현합니다.
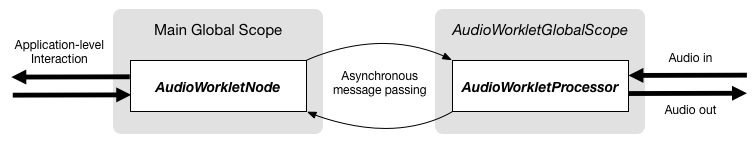
AudioWorkletNode
및
AudioWorkletProcessor
각 BaseAudioContext에는
정확히 하나의 AudioWorklet이
있습니다.
AudioWorklet의
worklet 전역 스코프 유형은
AudioWorkletGlobalScope입니다.
AudioWorklet의
worklet 대상 유형은
"audioworklet"입니다.
addModule(moduleUrl)
메서드를 통해 스크립트를 가져오면 AudioWorkletGlobalScope에
AudioWorkletProcessor의
클래스 정의를 등록합니다.
가져온 클래스 생성자와 생성자에서 만든 활성 인스턴스를 위한
두 개의 내부 저장 영역이 있습니다.
AudioWorklet에는
하나의 내부 슬롯이 있습니다:
-
노드 이름에서 매개변수 설명자로의 맵은 노드 이름에서 프로세서 생성자로의 맵과 동일한 문자열 키 집합을 포함하고, 대응하는 parameterDescriptors 값과 연관된 맵입니다. 이 내부 저장소는 렌더링 스레드에서
registerProcessor()메서드를 호출한 결과로 채워집니다. 컨텍스트의audioWorklet에서addModule()이 반환한 프로미스가 해결되기 전에 이 채우기 작업은 반드시 완료됩니다.
// bypass-processor.js 스크립트 파일, AudioWorkletGlobalScope에서 실행됩니다 class BypassProcessorextends AudioWorkletProcessor{ process( inputs, outputs) { // 단일 입력, 단일 채널입니다. const input= inputs[ 0 ]; const output= outputs[ 0 ]; output[ 0 ]. set( input[ 0 ]); // 활성 입력이 있는 동안에만 처리합니다. return false ; } }; registerProcessor( 'bypass-processor' , BypassProcessor);
// 메인 전역 스코프 const context= new AudioContext(); context. audioWorklet. addModule( 'bypass-processor.js' ). then(() => { const bypassNode= new AudioWorkletNode( context, 'bypass-processor' ); });
메인 전역 스코프에서 AudioWorkletNode를
인스턴스화할 때 대응하는 AudioWorkletProcessor도
AudioWorkletGlobalScope에서
생성됩니다. 이 두 객체는
§ 2 처리 모델에서 설명한
비동기 메시지 전달을 통해 통신합니다.
1.32.3.
AudioWorkletGlobalScope
인터페이스
이 특수 실행 컨텍스트는 오디오 렌더링
스레드에서
스크립트를 사용하여 오디오 데이터를 직접 생성, 처리 및 분석할 수 있도록 설계되었습니다.
사용자 제공 스크립트 코드는 이 스코프에서 평가되어 하나 이상의
AudioWorkletProcessor
하위 클래스를 정의하며, 이는 다시 메인 스코프의 AudioWorkletNode와
1:1로 연관된 AudioWorkletProcessor를
인스턴스화하는 데 사용됩니다.
하나 이상의 AudioWorkletNode를
포함하는 각 AudioContext마다
정확히 하나의 AudioWorkletGlobalScope가
존재합니다.
가져온 스크립트의 실행은 [HTML]에 정의된 대로 UA가
수행합니다.
[HTML]에 지정된 기본 동작을
재정의하여, AudioWorkletGlobalScope는
사용자 에이전트가 임의로 종료해서는 안 됩니다.
AudioWorkletGlobalScope에는
다음과 같은 내부 슬롯이 있습니다:
-
노드 이름에서 프로세서 생성자로의 맵은 프로세서 이름 →
AudioWorkletProcessorConstructor인스턴스의 키-값 쌍을 저장하는 맵입니다. 처음에는 이 맵이 비어 있으며registerProcessor()메서드가 호출될 때 채워집니다. -
대기 중인 프로세서 생성 데이터는 대응하는
AudioWorkletProcessor를 인스턴스화하기 위해AudioWorkletNode생성자가 생성한 임시 데이터를 저장합니다. 대기 중인 프로세서 생성 데이터에는 다음 항목이 포함됩니다:-
노드 참조는 처음에는 비어 있습니다. 이 저장소는
AudioWorkletNode생성자에서 전송된AudioWorkletNode참조를 위한 것입니다. -
전송된 포트는 처음에는 비어 있습니다. 이 저장소는
AudioWorkletNode생성자에서 전송된 역직렬화된MessagePort를 위한 것입니다.
-
참고: AudioWorkletGlobalScope에는
이러한 인스턴스가 공유할 다른 데이터와 코드도 포함될 수 있습니다.
예를 들어 여러 프로세서가 웨이브테이블이나
임펄스 응답을 정의하는 ArrayBuffer를 공유할 수 있습니다.
참고: AudioWorkletGlobalScope는
하나의 BaseAudioContext와
연관되며, 해당 컨텍스트의 단일 오디오 렌더링 스레드와도
연관됩니다. 이는 동시 스레드에서 실행되는 전역 스코프 코드에
데이터 경쟁이 발생하는 것을 방지합니다.
callback =AudioWorkletProcessorConstructor AudioWorkletProcessor (object ); [options Global =(Worklet ,AudioWorklet ),Exposed =AudioWorklet ]interface AudioWorkletGlobalScope :WorkletGlobalScope {undefined registerProcessor (DOMString name ,AudioWorkletProcessorConstructor processorCtor );readonly attribute unsigned long long currentFrame ;readonly attribute double currentTime ;readonly attribute float sampleRate ;readonly attribute unsigned long renderQuantumSize ;readonly attribute MessagePort port ; };
1.32.3.1. 속성
currentFrame, 유형은 unsigned long long, 읽기 전용-
현재 처리 중인 오디오 블록의 현재 프레임입니다. 이는
BaseAudioContext의 내부 슬롯[[current frame]]의 값과 반드시 같아야 합니다. currentTime, 유형은 double, 읽기 전용-
현재 처리 중인 오디오 블록의 컨텍스트 시간입니다. 이는
BaseAudioContext의currentTime속성 값과 반드시 같아야 합니다. sampleRate, 유형은 float, 읽기 전용-
연관된
BaseAudioContext의 샘플 레이트입니다. renderQuantumSize, 유형은 unsigned long, 읽기 전용-
연관된
BaseAudioContext의 비공개 슬롯 렌더 퀀텀 크기의 값입니다. port, 유형은 MessagePort, 읽기 전용-
MessagePort로,AudioWorklet의 포트에 연결되어 있습니다.참고: 이
port의"message"이벤트에 이벤트 리스너를 등록한 작성자는 리소스를 수집할 수 있도록MessageChannel의 어느 한쪽 끝 (AudioWorklet또는AudioWorkletGlobalScope쪽)에close를 호출해야 합니다.
1.32.3.2. 메서드
registerProcessor(name, processorCtor)-
AudioWorkletProcessor에서 파생된 클래스 생성자를 등록합니다.registerProcessor(name, processorCtor)메서드가 호출되면 다음 단계를 실행합니다. 어떤 단계에서든 예외가 발생하면 나머지 단계를 중단합니다.-
name이 빈 문자열이면
NotSupportedError를 발생시킵니다. -
name이 이미 노드 이름에서 프로세서 생성자로의 맵에 키로 존재하면
NotSupportedError를 발생시킵니다. -
IsConstructor(argument=processorCtor)의 결과가false이면TypeError를 발생시킵니다. -
prototype을Get(O=processorCtor, P="prototype")의 결과로 둡니다. -
Type(argument=prototype)의 결과가Object가 아니면TypeError를 발생시킵니다. -
parameterDescriptorsValue를
Get(O=processorCtor, P="parameterDescriptors")의 결과로 둡니다. -
parameterDescriptorsValue가
undefined가 아니면 다음 단계를 실행합니다:-
parameterDescriptorSequence를 parameterDescriptorsValue에서
sequence<AudioParamDescriptor>유형의 IDL 값으로 변환한 결과로 둡니다. -
paramNames를 빈 Array로 둡니다.
-
parameterDescriptorSequence의 각
descriptor에 대해:
-
paramName을 descriptor의
name멤버 값으로 둡니다. paramNames가 이미 paramName 값을 포함하고 있으면NotSupportedError를 발생시킵니다. -
paramName을 paramNames 배열에 추가합니다.
-
defaultValue를 descriptor의
defaultValue멤버 값으로 둡니다. -
minValue를 descriptor의
minValue멤버 값으로 둡니다. -
maxValue를 descriptor의
maxValue멤버 값으로 둡니다. -
표현식 minValue <= defaultValue <= maxValue가 false이면
InvalidStateError를 발생시킵니다.
-
-
-
키-값 쌍 name → processorCtor를 연관된
AudioWorkletGlobalScope의 노드 이름에서 프로세서 생성자로의 맵에 추가합니다. -
미디어 요소 태스크를 큐에 넣어 키-값 쌍 name → parameterDescriptorSequence를 연관된
BaseAudioContext의 노드 이름에서 매개변수 설명자로의 맵에 추가합니다.
참고: 클래스 생성자는 한 번만 조회해야 하므로 등록 후 동적으로 변경될 기회가 없습니다.
AudioWorkletGlobalScope.registerProcessor(name, processorCtor) 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 nameDOMString✘ ✘ 등록할 클래스 생성자를 나타내는 문자열 키입니다. 이 키는 AudioWorkletNode를 생성하는 동안AudioWorkletProcessor의 생성자를 조회하는 데 사용됩니다.processorCtorAudioWorkletProcessorConstructor✘ ✘ AudioWorkletProcessor에서 확장된 클래스 생성자입니다.반환 유형:undefined -
1.32.3.3.
AudioWorkletProcessor의
인스턴스화
AudioWorkletNode
생성이 끝나면
스레드 간 전송을 위해 구조체
프로세서
생성 데이터가 준비됩니다. 이
구조체에는
다음 항목이 포함됩니다:
-
name은 노드 이름에서 프로세서 생성자로의 맵에서 조회할
DOMString입니다. -
node는 생성된
AudioWorkletNode에 대한 참조입니다. -
options는
AudioWorkletNode의constructor에 제공된 직렬화된AudioWorkletNodeOptions입니다. -
port는
AudioWorkletNode의port와 쌍을 이루는 직렬화된MessagePort입니다.
전송된 데이터가 AudioWorkletGlobalScope에
도착하면 렌더링 스레드가
아래 알고리즘을 호출합니다:
-
constructionData를 제어 스레드에서 전송된 프로세서 생성 데이터로 둡니다.
-
processorName, nodeReference 및 serializedPort를 각각 constructionData의 name, node, 및 port로 둡니다.
-
serializedOptions를 constructionData의 options로 둡니다.
-
deserializedPort를 StructuredDeserialize(serializedPort, 현재 Realm)의 결과로 둡니다.
-
deserializedOptions를 StructuredDeserialize(serializedOptions, 현재 Realm)의 결과로 둡니다.
-
processorCtor를
AudioWorkletGlobalScope의 노드 이름에서 프로세서 생성자로의 맵에서 processorName을 조회한 결과로 둡니다. -
nodeReference와 deserializedPort를 각각 이
AudioWorkletGlobalScope의 대기 중인 프로세서 생성 데이터의 노드 참조와 전송된 포트에 저장합니다. -
processorCtor에서 deserializedOptions을 인수로 사용하여 콜백 함수를 생성합니다. 콜백에서 예외가 발생하면 제어 스레드에 태스크를 큐에 넣어 nodeReference에서
ErrorEvent를 사용하여processorerror라는 이벤트를 발생시킵니다. -
대기 중인 프로세서 생성 데이터 슬롯을 비웁니다.
1.32.4.
AudioWorkletNode
인터페이스
이 인터페이스는 제어 스레드에
존재하는 사용자 정의 AudioNode를
나타냅니다. 사용자는 BaseAudioContext에서
AudioWorkletNode를
생성할 수 있으며, 이러한 노드는 다른 내장 AudioNode와
연결하여 오디오 그래프를 구성할 수 있습니다.
| 속성 | 값 | 참고 |
|---|---|---|
numberOfInputs
| 1 | |
numberOfOutputs
| 1 | |
channelCount
| 2 | |
channelCountMode
| "max"
| |
channelInterpretation
| "speakers"
| |
| 테일 타임 | 참고 참조 | 모든 테일 타임은 노드 자체에서 처리합니다 |
모든 AudioWorkletProcessor에는
처음에 true인 연관된 활성
소스 플래그가 있습니다. 이 플래그로 인해
연결된 입력이 없어도 노드는 메모리에 유지되고 오디오 처리를
수행합니다.
AudioWorkletNode에서
게시하는 모든 태스크는 연관된 BaseAudioContext의
태스크 큐에 게시됩니다.
[Exposed =Window ]interface {AudioParamMap readonly maplike <DOMString ,AudioParam >; };
이 인터페이스에는 readonly maplike에서 제공되는
"entries", "forEach", "get", "has", "keys",
"values", @@iterator 메서드와 "size" getter가 있습니다.
[Exposed =Window ,SecureContext ]interface AudioWorkletNode :AudioNode {constructor (BaseAudioContext ,context DOMString ,name optional AudioWorkletNodeOptions = {});options readonly attribute AudioParamMap parameters ;readonly attribute MessagePort port ;attribute EventHandler onprocessorerror ; };
1.32.4.1. 생성자
AudioWorkletNode(context, name, options)-
AudioWorkletNode.constructor() 메서드의 인수. 매개변수 유형 널 허용 선택 사항 설명 contextBaseAudioContext✘ ✘ 이 새로운 AudioWorkletNode가 연관될BaseAudioContext입니다.nameDOMString✘ ✘ BaseAudioContext의 노드 이름에서 매개변수 설명자로의 맵에 대한 키인 문자열입니다.optionsAudioWorkletNodeOptions✘ ✔ 이 AudioWorkletNode의 선택적 초기 매개변수 값입니다.생성자가 호출되면 사용자 에이전트는 제어 스레드에서 다음 단계를 반드시 실행해야 합니다:
AudioWorkletNode생성자가 context, nodeName, options로 호출되면:-
nodeName이
BaseAudioContext의 노드 이름에서 매개변수 설명자로의 맵에 키로 존재하지 않으면InvalidStateError예외를 발생시키고 이 단계를 중단합니다. -
node를 this 값으로 둡니다.
-
context와 options를 인수로 사용하여 node AudioNode를 초기화합니다.
-
options를 사용하여 node의 입력, 출력 및 출력 채널을 구성합니다. 예외가 발생하면 나머지 단계를 중단합니다.
-
messageChannel을 새
MessageChannel로 둡니다. -
nodePort를 messageChannel의
port1속성 값으로 둡니다. -
processorPortOnThisSide를 messageChannel의
port2속성 값으로 둡니다. -
serializedProcessorPort를 StructuredSerializeWithTransfer(processorPortOnThisSide, « processorPortOnThisSide »)의 결과로 둡니다.
-
options 딕셔너리를 optionsObject로 변환합니다.
-
serializedOptions를 StructuredSerialize(optionsObject)의 결과로 둡니다.
-
node의
port를 nodePort로 설정합니다. -
parameterDescriptors를 노드 이름에서 매개변수 설명자로의 맵에서 nodeName을 조회한 결과로 둡니다:
-
audioParamMap을 새
AudioParamMap객체로 둡니다. -
parameterDescriptors의 각 descriptor에 대해:
-
paramName을 descriptor의
name멤버 값으로 둡니다. -
audioParam을
automationRate,defaultValue,minValue, 및maxValue가 descriptor의 대응하는 멤버 값과 같은 값을 갖는 새AudioParam인스턴스로 둡니다. -
키-값 쌍 paramName → audioParam을 audioParamMap의 항목에 추가합니다.
-
-
options에
parameterData가 있으면 다음 단계를 실행합니다:-
parameterData를
parameterData의 값으로 둡니다. -
parameterData의 각 paramName → paramValue에 대해:
-
audioParamMap에 키 paramName을 가진 맵 항목이 존재하면 audioParamInMap을 해당 항목으로 둡니다.
-
audioParamInMap의
value속성을 paramValue로 설정합니다.
-
-
-
node의
parameters를 audioParamMap으로 설정합니다.
-
-
nodeName, node, serializedOptions, 및 serializedProcessorPort로 구성된 프로세서 생성 데이터를 사용하여 대응하는
AudioWorkletProcessor의constructor를 호출하도록 제어 메시지를 큐에 넣습니다.
-
1.32.4.2. 속성
onprocessorerror, 유형은 EventHandler-
프로세서의
constructor,process메서드, 또는 사용자 정의 클래스 메서드에서 처리되지 않은 예외가 발생하면 프로세서는 미디어 요소 태스크를 큐에 넣어 연관된AudioWorkletNode에서ErrorEvent를 사용하여processorerror라는 이벤트를 발생시킵니다.ErrorEvent는 제어 스레드에서 해당message,filename,lineno,colno속성과 함께 적절히 생성되고 초기화됩니다.처리되지 않은 예외가 한 번 발생하면 프로세서는 수명 전체에 걸쳐 무음을 출력한다는 점에 유의하십시오.
parameters, 유형은 AudioParamMap, 읽기 전용-
parameters속성은 연관된 이름을 가진AudioParam객체의 컬렉션입니다. 이 maplike 객체는 인스턴스화 시AudioWorkletProcessor클래스 생성자에 있는AudioParamDescriptor목록으로 채워집니다. port, 유형은 MessagePort, 읽기 전용-
모든
AudioWorkletNode에는MessagePort인 연관된port가 있습니다. 이는 대응하는AudioWorkletProcessor객체의 포트에 연결되어AudioWorkletNode와 그AudioWorkletProcessor사이의 양방향 통신을 허용합니다.참고: 이
port의"message"이벤트에 이벤트 리스너를 등록한 작성자는 리소스를 수집할 수 있도록MessageChannel의 어느 한쪽 끝(AudioWorkletProcessor또는AudioWorkletNode쪽)에close를 호출해야 합니다.
1.32.4.3.
AudioWorkletNodeOptions
AudioWorkletNodeOptions
딕셔너리는 AudioWorkletNode
인스턴스의 속성을 초기화하는 데 사용할 수 있습니다.
dictionary AudioWorkletNodeOptions :AudioNodeOptions {unsigned long numberOfInputs = 1;unsigned long numberOfOutputs = 1;sequence <unsigned long >outputChannelCount ;record <DOMString ,double >parameterData ;object processorOptions ; };
1.32.4.3.1.
AudioWorkletNodeOptions
딕셔너리 멤버
numberOfInputs, 유형은 unsigned long, 기본값은1-
이는
AudioNode의numberOfInputs속성 값을 초기화하는 데 사용됩니다. numberOfOutputs, 유형은 unsigned long, 기본값은1-
이는
AudioNode의numberOfOutputs속성 값을 초기화하는 데 사용됩니다. outputChannelCount, 유형은sequence<unsigned long>-
이 배열은 각 출력의 채널 수를 구성하는 데 사용됩니다.
parameterData, 유형은 record<DOMString, double>-
이는
AudioWorkletNode에서 일치하는 이름을 가진AudioParam의 초기value를 설정하는 데 사용되는 사용자 정의 키-값 쌍의 목록입니다. processorOptions, 유형은 object-
이는
AudioWorkletNode와 연관된AudioWorkletProcessor인스턴스의 사용자 정의 속성을 초기화하는 데 사용할 수 있는 모든 사용자 정의 데이터를 보관합니다.
1.32.4.3.2.
AudioWorkletNodeOptions를
사용한 채널 구성
다음 알고리즘은 AudioWorkletNodeOptions를
사용하여 다양한 채널 구성을
구성하는 방법을 설명합니다.
-
node를 이 알고리즘에 주어진
AudioWorkletNode인스턴스로 둡니다. -
numberOfInputs와numberOfOutputs가 둘 다 0이면NotSupportedError를 발생시키고 나머지 단계를 중단합니다. -
outputChannelCount가 존재하면,-
outputChannelCount의 값 중 하나라도 0이거나 구현의 최대 채널 수보다 크면NotSupportedError를 발생시키고 나머지 단계를 중단합니다. -
outputChannelCount의 길이가numberOfOutputs와 같지 않으면IndexSizeError를 발생시키고 나머지 단계를 중단합니다. -
numberOfInputs와numberOfOutputs가 둘 다 1이면, node 출력의 채널 수를outputChannelCount의 하나의 값으로 설정합니다. -
그렇지 않으면 node의 k번째 출력의 채널 수를
outputChannelCount시퀀스의 k번째 요소로 설정하고 반환합니다.
-
-
outputChannelCount가 존재하지 않으면,-
numberOfInputs와numberOfOutputs가 둘 다 1이면, node 출력의 초기 채널 수를 1로 설정하고 반환합니다.참고: 이 경우 출력의 채널 수는 런타임에 입력과
channelCountMode를 기반으로 computedNumberOfChannels로 동적으로 변경됩니다. -
그렇지 않으면 node의 각 출력의 채널 수를 1로 설정하고 반환합니다.
-
1.32.5.
AudioWorkletProcessor
인터페이스
이 인터페이스는 오디오 렌더링 스레드에서
실행되는 오디오 처리 코드를 나타냅니다.
이는 AudioWorkletGlobalScope에
존재하며, 클래스 정의가 실제 오디오 처리를 구현합니다.
AudioWorkletProcessor의
생성은 AudioWorkletNode
생성의 결과로만 이루어질 수 있다는 점에 유의하십시오.
[Exposed =AudioWorklet ]interface AudioWorkletProcessor {constructor ();readonly attribute MessagePort port ; };callback AudioWorkletProcessCallback =boolean (FrozenArray <FrozenArray <Float32Array >>,inputs FrozenArray <FrozenArray <Float32Array >>,outputs object );parameters
AudioWorkletProcessor에는
두 개의 내부 슬롯이 있습니다:
[[node reference]]-
연관된
AudioWorkletNode에 대한 참조입니다. [[callable process]]-
process()가 호출 가능한 유효한 함수인지 여부를 나타내는 boolean 플래그입니다.
1.32.5.1. 생성자
AudioWorkletProcessor()-
AudioWorkletProcessor의 생성자가 호출되면 렌더링 스레드에서 다음 단계를 실행합니다.-
nodeReference를 현재
AudioWorkletGlobalScope의 대기 중인 프로세서 생성 데이터에서 노드 참조를 조회한 결과로 둡니다. 슬롯이 비어 있으면TypeError예외를 발생시킵니다. -
processor를 this 값으로 둡니다.
-
processor의
[[node reference]]를 nodeReference로 설정합니다. -
processor의
[[callable process]]를true로 설정합니다. -
deserializedPort를 대기 중인 프로세서 생성 데이터에서 전송된 포트를 조회한 결과로 둡니다.
-
processor의
port를 deserializedPort로 설정합니다. -
대기 중인 프로세서 생성 데이터 슬롯을 비웁니다.
-
1.32.5.2. 속성
port, 유형은 MessagePort, 읽기 전용-
모든
AudioWorkletProcessor에는MessagePort인 연관된port가 있습니다. 이는 대응하는AudioWorkletNode객체의 포트에 연결되어AudioWorkletNode와 그AudioWorkletProcessor사이의 양방향 통신을 허용합니다.참고: 이
port의"message"이벤트에 이벤트 리스너를 등록한 작성자는 리소스를 수집할 수 있도록MessageChannel의 어느 한쪽 끝(AudioWorkletProcessor또는AudioWorkletNode쪽)에close를 호출해야 합니다.
1.32.5.3.
콜백 AudioWorkletProcessCallback
사용자는 AudioWorkletProcessor를
확장하여 사용자 정의 오디오 프로세서를 정의할 수 있습니다.
하위 클래스는 오디오 처리
알고리즘을 구현하는
process()라는
이름의 AudioWorkletProcessCallback을
반드시 정의해야 하며, AudioParamDescriptor의
iterable인
parameterDescriptors라는
정적 속성을 가질 수 있습니다.
process() 콜백 함수는 그래프를 렌더링할 때 지정된 대로 처리됩니다.
AudioWorkletProcessor와
연관된 AudioWorkletNode의
수명을 제어합니다.
이 수명 정책은 다음을 포함하여 내장 노드에서 볼 수 있는 다양한 방식을 지원할 수 있습니다:
-
입력을 변환하며, 연결된 입력 및/또는 스크립트 참조가 존재하는 동안에만 활성 상태인 노드입니다. 이러한 노드는 process()에서
false를 반환해야 하며, 이를 통해 연결된 입력의 존재 여부가AudioWorkletNode가 활성 처리 중인지 여부를 결정할 수 있습니다. -
입력을 변환하지만 입력이 연결 해제된 후에도 테일 타임 동안 활성 상태를 유지하는 노드입니다. 이 경우 process()는
inputs에 채널이 0개인 것으로 확인된 후에도 일정 시간 동안true를 반환해야 합니다. 전역 스코프의currentTime에서 현재 시간을 가져와 이 테일 타임 구간의 시작과 끝을 측정하거나, 프로세서의 내부 상태에 따라 이 구간을 동적으로 계산할 수 있습니다. -
일반적으로 수명을 가지며 출력의 소스로 동작하는 노드입니다. 이러한 노드는 더 이상 출력을 생성하지 않는 시점까지 process()에서
true를 반환해야 합니다.
앞선 정의는 process()의
구현에서 반환값을 제공하지 않는 경우
false를 반환하는 것과 동일한 효과가 있음을 의미합니다
(유효 반환값은 falsy 값인 undefined이기
때문입니다).
이는 활성 입력이 있을 때만 활성 상태인
모든 AudioWorkletProcessor에
합리적인 동작입니다.
아래 예제는 AudioParam을
AudioWorkletProcessor에서
정의하고 사용하는 방법을 보여 줍니다.
class MyProcessorextends AudioWorkletProcessor{ static get parameterDescriptors() { return [{ name: 'myParam' , defaultValue: 0.5 , minValue: 0 , maxValue: 1 , automationRate: "k-rate" }]; } process( inputs, outputs, parameters) { // 첫 번째 입력과 출력을 가져옵니다. const input= inputs[ 0 ]; const output= outputs[ 0 ]; const myParam= parameters. myParam; // 단일 입력 및 출력을 위한 간단한 증폭기입니다. 다음에 유의하십시오. // automationRate는 "k-rate"이므로 각 렌더 퀀텀마다 인덱스 [0]에 // 하나의 값만 있습니다. for ( let channel= 0 ; channel< output. length; ++ channel) { for ( let i= 0 ; i< output[ channel]. length; ++ i) { output[ channel][ i] = input[ channel][ i] * myParam[ 0 ]; } } } }
1.32.5.3.1.
콜백 AudioWorkletProcessCallback
매개변수
다음은 AudioWorkletProcessCallback
함수의 매개변수를 설명합니다.
일반적으로 inputs와
outputs
배열은 메모리 할당이 발생하지 않도록
호출 간에 재사용됩니다. 그러나 입력 또는
출력의 채널 수가 변경되는 등 토폴로지가 변경되면
새 배열이 다시 할당됩니다. 또한 inputs
또는
outputs
배열의 어느 부분이든 전송되면
새 배열이 다시 할당됩니다.
inputs, 유형은FrozenArray<FrozenArray<Float32Array>>-
사용자 에이전트가 제공하는 들어오는 연결의 입력 오디오 버퍼입니다.
inputs[n][m]은 \(n\)번째 입력의 \(m\)번째 채널에 대한 오디오 샘플의Float32Array입니다. 입력 수는 생성 시 고정되지만 채널 수는 computedNumberOfChannels를 기반으로 동적으로 변경될 수 있습니다.현재 렌더 퀀텀에서
AudioWorkletNode의 \(n\)번째 입력에 연결된 활성 처리 중인AudioNode가 없으면inputs[n]의 내용은 빈 배열이며, 이는 입력 채널이 0개임을 나타냅니다. 이것은inputs[n]의 요소 수가 0이 될 수 있는 유일한 경우입니다. outputs, 유형은FrozenArray<FrozenArray<Float32Array>>-
사용자 에이전트가 소비할 출력 오디오 버퍼입니다.
outputs[n][m]은 \(n\)번째 출력의 \(m\)번째 채널에 대한 오디오 샘플을 포함하는Float32Array객체입니다. 각Float32Array는 0으로 채워집니다. 출력의 채널 수는 노드가 단일 출력을 가질 때만 computedNumberOfChannels와 일치합니다. parameters, 유형은object-
name → parameterValues의 순서 있는 맵입니다.
parameters["name"]은 nameAudioParam의 자동화 값을 가진FrozenArray<Float32Array>인 parameterValues를 반환합니다.각 배열에는 렌더 퀀텀의 모든 프레임에 대한 매개변수의 computedValue가 포함됩니다. 그러나 이 렌더 퀀텀 동안 자동화가 예약되어 있지 않으면 배열의 길이는 1일 수 있으며, 그 배열 요소는 렌더 퀀텀에 대한
AudioParam의 상수 값일 수 있습니다.이 객체는 다음 단계에 따라 동결됩니다
-
parameter를 이름과 매개변수 값의 순서 있는 맵으로 둡니다.
-
SetIntegrityLevel(parameter, frozen)
알고리즘에서 계산한 이 동결된 순서 있는 맵은
parameters인수에 전달됩니다.참고: 이는 객체를 수정할 수 없으므로 배열 길이가 변경되지 않는 한 연속된 호출에서 동일한 객체를 사용할 수 있음을 의미합니다.
-
1.32.5.4.
AudioParamDescriptor
AudioParamDescriptor
딕셔너리는 AudioWorkletNode에서
사용되는 AudioParam
객체의 속성을 지정하는 데 사용됩니다.
dictionary AudioParamDescriptor {required DOMString name ;float defaultValue = 0;float minValue = -3.4028235e38;float maxValue = 3.4028235e38;AutomationRate automationRate = "a-rate"; };
1.32.5.4.1.
AudioParamDescriptor
딕셔너리 멤버
이 멤버의 값에는 제약 조건이 있습니다. 제약 조건은 AudioParamDescriptor를 처리하는 알고리즘을 참조하십시오.
automationRate, 유형은 AutomationRate, 기본값은"a-rate"-
기본 자동화 속도를 나타냅니다.
defaultValue, 유형은 float, 기본값은0-
매개변수의 기본값을 나타냅니다.
maxValue, 유형은 float, 기본값은3.4028235e38-
최댓값을 나타냅니다.
minValue, 유형은 float, 기본값은-3.4028235e38-
최솟값을 나타냅니다.
name, 유형은 DOMString-
매개변수의 이름을 나타냅니다.
1.32.6. AudioWorklet 이벤트 순서
다음 그림은 AudioWorklet과
관련하여 발생하는 이상화된 이벤트 순서를 보여 줍니다:
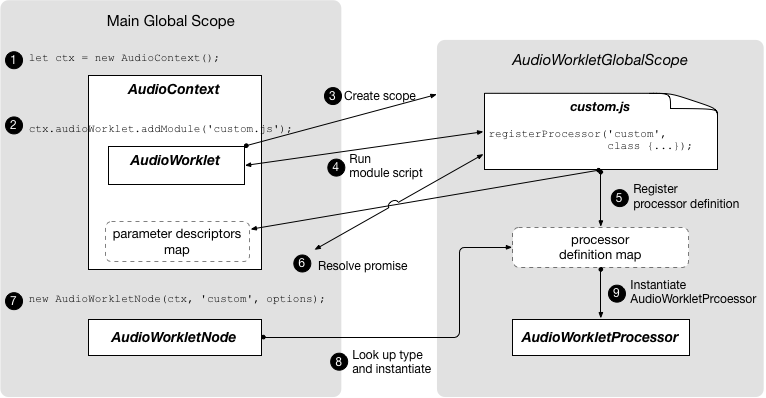
AudioWorklet
순서
다이어그램에 표시된 단계는 AudioContext와
연관된 AudioWorkletGlobalScope의
생성에 이어 AudioWorkletNode와
연관된 AudioWorkletProcessor가
생성되는 가능한 이벤트 순서 중 하나입니다.
-
AudioContext가 생성됩니다. -
메인 스코프에서
context.audioWorklet에 스크립트 모듈을 추가하도록 요청합니다. -
아직 존재하지 않으므로 컨텍스트와 연관된 새
AudioWorkletGlobalScope가 생성됩니다. 이는AudioWorkletProcessor클래스 정의가 평가되는 전역 스코프입니다. (이후 호출에서는 이전에 생성된 이 스코프가 사용됩니다.) -
가져온 스크립트가 새로 생성된 전역 스코프에서 실행됩니다.
-
가져온 스크립트를 실행하는 과정에서
AudioWorkletProcessor가AudioWorkletGlobalScope내의 키(위 다이어그램에서는"custom") 아래에 등록됩니다. 이로써 전역 스코프와AudioContext모두의 맵이 채워집니다. -
addModule()호출의 프로미스가 해결됩니다. -
메인 스코프에서 사용자가 지정한 키와 옵션 딕셔너리를 사용하여
AudioWorkletNode를 생성합니다. -
노드를 생성하는 과정에서 이 키를 사용하여 인스턴스화할 올바른
AudioWorkletProcessor하위 클래스를 조회합니다. -
AudioWorkletProcessor하위 클래스의 인스턴스는 동일한 옵션 딕셔너리의 구조화된 복제본으로 인스턴스화됩니다. 이 인스턴스는 이전에 생성된AudioWorkletNode와 쌍을 이룹니다.
1.32.7. AudioWorklet 예제
1.32.7.1. BitCrusher 노드
비트크러싱은 샘플 값을 양자화하여(더 낮은 비트 심도를
시뮬레이션) 오디오 스트림의 품질을 낮추는 동시에
시간 해상도를 양자화하여(더 낮은 샘플 레이트를 시뮬레이션)
품질을 낮추는 메커니즘입니다. 이 예제는 AudioWorkletProcessor
내부에서
AudioParam을
사용하는 방법을 보여 줍니다(이 경우
a-rate로 처리됨).
const context= new AudioContext(); context. audioWorklet. addModule( 'bitcrusher.js' ). then(() => { const osc= new OscillatorNode( context); const amp= new GainNode( context); // worklet 노드를 생성합니다. 'BitCrusher'는 // bitcrusher.js를 가져올 때 이전에 등록한 // AudioWorkletProcessor를 식별합니다. 옵션은 대응하는 // 이름의 AudioParam을 자동으로 초기화합니다. const bitcrusher= new AudioWorkletNode( context, 'bitcrusher' , { parameterData: { bitDepth: 8 } }); osc. connect( bitcrusher). connect( amp). connect( context. destination); osc. start(); });
class Bitcrusherextends AudioWorkletProcessor{ static get parameterDescriptors() { return [{ name: 'bitDepth' , defaultValue: 12 , minValue: 1 , maxValue: 16 }, { name: 'frequencyReduction' , defaultValue: 0.5 , minValue: 0 , maxValue: 1 }]; } constructor () { super (); this . _phase= 0 ; this . _lastSampleValue= 0 ; } process( inputs, outputs, parameters) { const input= inputs[ 0 ]; const output= outputs[ 0 ]; const bitDepth= parameters. bitDepth; const frequencyReduction= parameters. frequencyReduction; if ( bitDepth. length> 1 ) { for ( let channel= 0 ; channel< output. length; ++ channel) { for ( let i= 0 ; i< output[ channel]. length; ++ i) { let step= Math. pow( 0.5 , bitDepth[ i]); // Use modulo for indexing to handle the case where // the length of the frequencyReduction array is 1. this . _phase+= frequencyReduction[ i% frequencyReduction. length]; if ( this . _phase>= 1.0 ) { this . _phase-= 1.0 ; this . _lastSampleValue= step* Math. floor( input[ channel][ i] / step+ 0.5 ); } output[ channel][ i] = this . _lastSampleValue; } } } else { // Because we know bitDepth is constant for this call, // we can lift the computation of step outside the loop, // saving many operations. const step= Math. pow( 0.5 , bitDepth[ 0 ]); for ( let channel= 0 ; channel< output. length; ++ channel) { for ( let i= 0 ; i< output[ channel]. length; ++ i) { this . _phase+= frequencyReduction[ i% frequencyReduction. length]; if ( this . _phase>= 1.0 ) { this . _phase-= 1.0 ; this . _lastSampleValue= step* Math. floor( input[ channel][ i] / step+ 0.5 ); } output[ channel][ i] = this . _lastSampleValue; } } } // No need to return a value; this node's lifetime is dependent only on its // input connections. } }; registerProcessor( 'bitcrusher' , Bitcrusher);
참고: AudioWorkletProcessor
클래스 정의에서 작성자가 제공한 생성자가 this가 아닌
명시적 반환값을 가지거나 super()를 올바르게 호출하지 않으면
InvalidStateError가
발생합니다.
1.32.7.2. VU 미터 노드
이 간단한 음압 레벨 미터 예제는 네이티브 AudioNode처럼
동작하며 생성자 옵션을 받고
AudioWorkletNode와
AudioWorkletProcessor
사이의 스레드 간 통신(비동기)을 캡슐화하는
AudioWorkletNode
하위 클래스를 만드는 방법을 추가로 보여 줍니다.
이 노드는 출력을 사용하지 않습니다.
/* vumeter-node.js: 메인 전역 스코프 */ export default class VUMeterNodeextends AudioWorkletNode{ constructor ( context, updateIntervalInMS) { super ( context, 'vumeter' , { numberOfInputs: 1 , numberOfOutputs: 0 , channelCount: 1 , processorOptions: { updateIntervalInMS: updateIntervalInMS|| 16.67 } }); // AudioWorkletNode의 상태 this . _updateIntervalInMS= updateIntervalInMS; this . _volume= 0 ; // AudioWorkletProcessor에서 업데이트된 값을 처리합니다 this . port. onmessage= event=> { if ( event. data. volume) this . _volume= event. data. volume; } this . port. start(); } get updateInterval() { return this . _updateIntervalInMS; } set updateInterval( updateIntervalInMS) { this . _updateIntervalInMS= updateIntervalInMS; this . port. postMessage({ updateIntervalInMS: updateIntervalInMS}); } draw() { // 음량 값을 기반으로 VU 미터를 그립니다 // |this._updateIntervalInMS|밀리초마다. } };
/* vumeter-processor.js: AudioWorkletGlobalScope */ const SMOOTHING_FACTOR= 0.9 ; const MINIMUM_VALUE= 0.00001 ; registerProcessor( 'vumeter' , class extends AudioWorkletProcessor{ constructor ( options) { super (); this . _volume= 0 ; this . _updateIntervalInMS= options. processorOptions. updateIntervalInMS; this . _nextUpdateFrame= this . _updateIntervalInMS; this . port. onmessage= event=> { if ( event. data. updateIntervalInMS) this . _updateIntervalInMS= event. data. updateIntervalInMS; } } get intervalInFrames() { return this . _updateIntervalInMS/ 1000 * sampleRate; } process( inputs, outputs, parameters) { const input= inputs[ 0 ]; // 입력은 모노로 다운 믹싱됩니다. 그러나 입력이 연결되지 않은 경우에는 // 0개의 채널이 전달된다는 점에 유의하십시오. if ( input. length> 0 ) { const samples= input[ 0 ]; let sum= 0 ; let rms= 0 ; // 제곱합을 계산합니다. for ( let i= 0 ; i< samples. length; ++ i) sum+= samples[ i] * samples[ i]; // RMS 레벨을 계산하고 음량을 업데이트합니다. rms= Math. sqrt( sum/ samples. length); this . _volume= Math. max( rms, this . _volume* SMOOTHING_FACTOR); // 음량 속성을 업데이트하고 메인 스레드와 동기화합니다. this . _nextUpdateFrame-= samples. length; if ( this . _nextUpdateFrame< 0 ) { this . _nextUpdateFrame+= this . intervalInFrames; this . port. postMessage({ volume: this . _volume}); } } // 음량이 임계값보다 높으면 처리를 계속하여 // 입력 연결이 해제되어도 미터가 즉시 // 평활화된 값의 계산을 중지하지 않도록 합니다. return this . _volume>= MINIMUM_VALUE; } });
/* index.js: 메인 전역 스코프, 진입점 */ import VUMeterNodefrom './vumeter-node.js' ; const context= new AudioContext(); context. audioWorklet. addModule( 'vumeter-processor.js' ). then(() => { const oscillator= new OscillatorNode( context); const vuMeterNode= new VUMeterNode( context, 25 ); oscillator. connect( vuMeterNode); oscillator. start(); function drawMeter() { vuMeterNode. draw(); requestAnimationFrame( drawMeter); } drawMeter(); });
1.33.
AudioPlaybackStats
인터페이스
AudioContext를
통해 재생되는 오디오의 언더런 및 지연 시간 통계를 제공합니다.
오디오가 재생 장치에 제때 전달되지 않으면 오디오 언더런이 발생합니다. 이는 재생 신호에 불연속을 일으켜 흔히 "글리치"라고 하는 들리는 "클릭" 소리를 발생시킵니다. 이러한 글리치는 사용자 경험에 좋지 않으므로, 글리치가 발생하면 애플리케이션이 이를 감지하고 재생을 개선하기 위한 조치를 취할 수 있으면 유용합니다.
AudioPlaybackStats는
오디오 통계 보고를 위한 전용 객체입니다.
이는 AudioContext의
AudioDestinationNode와
연관된 오디오 출력 장치를 통한 재생 경로의
오디오 언더런 및 재생 지연 시간 통계를 보고합니다. 이를 통해
애플리케이션은 다음과 같은 이유로 발생할 수 있는
언더런을 측정할 수 있습니다:
-
오디오 그래프가 시스템이 제시간에 오디오를 생성하기에는 너무 복잡하여 언더런이 발생합니다.
-
외부 문제로 인해 언더런이 발생합니다. 이러한 문제의 예는 다음과 같습니다:
-
동일한 재생 장치로 오디오를 재생하는 다른 프로그램이 오작동하고 있습니다.
-
전체 시스템의 CPU가 과부하 상태입니다.
-
열 스로틀링으로 인해 시스템이 과부하 상태입니다.
-
-
언더런 프레임은 출력 장치가 재생한 오디오 프레임 중
AudioContext가 제공하지 않은 프레임입니다. 이는 재생 경로가 출력 장치에 오디오 프레임을 제때 제공하지 못했을 때 발생하며, 이 경우에도 장치는 무언가를 재생해야 합니다.참고: 언더런 프레임은 일반적으로 무음입니다.
-
언더런 이벤트는 연속된 일련의 언더런 프레임의 재생입니다. 언더런 이벤트의 지속 시간은 일련의 언더런 프레임의 총 지속 시간입니다.
[Exposed =Window ,SecureContext ]interface AudioPlaybackStats {readonly attribute double underrunDuration ;readonly attribute unsigned long underrunEvents ;readonly attribute double totalDuration ;readonly attribute double averageLatency ;readonly attribute double minimumLatency ;readonly attribute double maximumLatency ;undefined resetLatency (); [Default ]object (); };toJSON
각 AudioContext에는
정확히 하나의 AudioPlaybackStats가
있습니다.
AudioPlaybackStats에는
다음 내부 슬롯이 있습니다:
[[audio context]]-
이
AudioPlaybackStats인스턴스와 연관된AudioContext입니다. 생성 시 소유하는AudioContext로 초기화됩니다. [[underrun duration]]-
마지막 통계 업데이트 시점까지
[[audio context]]재생에서 발생한 모든 언더런 이벤트의 총 지속 시간을 나타내는 double입니다. 0으로 초기화됩니다. [[underrun events]]-
마지막 통계 업데이트 시점까지
[[audio context]]재생에서 발생한 언더런 이벤트의 총 개수를 나타내는 int입니다. 0으로 초기화됩니다. [[total duration]]-
마지막 통계 업데이트 시점까지
[[audio context]]재생의 모든 프레임에 대한 총 지속 시간(초)을 나타내는 double이며,[[underrun duration]]+currentTime [[average latency]]-
현재 추적 중인 구간동안[[audio context]]의 평균 오디오 출력 지연 시간을 나타내는 double입니다. [[minimum latency]]-
현재 추적 중인 구간동안[[audio context]]의 최소 오디오 출력 지연 시간을 나타내는 double입니다. 0으로 초기화됩니다. [[maximum latency]]-
현재 추적 중인 구간동안[[audio context]]의 최대 오디오 출력 지연 시간을 나타내는 double입니다. 0으로 초기화됩니다. [[latency reset time]]-
지연 시간 통계가 마지막으로 재설정된 시간을 나타내는 double입니다. 이는
currentTime의 시계 도메인에 있습니다. 0으로 초기화됩니다.currently tracked interval은[[latency reset time]]부터 현재currentTime까지의 구간입니다.
1.33.1. 속성
참고: 이러한 속성은 초당 한 번만 그리고 특정 조건에서만 업데이트됩니다. 자세한 내용은 § 1.33.3 통계 업데이트 및 § 1.33.4.2 완화 조치를 참조하십시오.
underrunDuration, 유형은 double, 읽기 전용-
[[underrun duration]]내부 슬롯의 값을 반환합니다.참고: 이 메트릭은
totalDuration과 함께 사용하여AudioContext가 제공하지 않은 재생 미디어의 비율을 계산할 수 있습니다.
underrunEvents, 유형은 unsigned long, 읽기 전용-
[[underrun events]]내부 슬롯의 값을 반환합니다.
totalDuration, 유형은 double, 읽기 전용-
[[total duration]]내부 슬롯의 값을 반환합니다.
averageLatency, 유형은 double, 읽기 전용-
[[average latency]]내부 슬롯의 값을 반환합니다.
minimumLatency, 유형은 double, 읽기 전용-
[[minimum latency]]내부 슬롯의 값을 반환합니다.
maximumLatency, 유형은 double, 읽기 전용-
[[maximum latency]]내부 슬롯의 값을 반환합니다.
1.33.2. 메서드
resetLatency()-
지연 시간 통계를 추적하는 구간의 시작을 현재 시간으로 설정합니다.
resetLatency가 호출되면 다음 단계를 실행합니다:-
[[latency reset time]]을currentTime으로 설정합니다. -
currentLatency를
[[audio context]]가 마지막으로 재생한 프레임의 재생 지연 시간으로, 아직 재생된 프레임이 없으면 0으로 둡니다. -
[[average latency]]를 currentLatency로 설정합니다. -
[[minimum latency]]를 currentLatency로 설정합니다. -
[[maximum latency]]를 currentLatency로 설정합니다.
-
1.33.3. 통계 업데이트
-
[[audio context]]가 실행 중이 아니면 이 단계를 중단합니다. -
canUpdate를 false로 둡니다.
-
document를 현재 this의 관련 전역 객체의 연결된 Document로 둡니다. document가 완전히 활성 상태이고 document의 가시성 상태가
"visible"이면 canUpdate를 true로 설정합니다. -
permission을 "microphone" 접근과 연관된 권한의 권한 상태로 둡니다. permission이 "granted"이면 canUpdate를 true로 설정합니다.
-
canUpdate가 false이면 이 단계를 중단합니다.
-
[[underrun duration]]을 생성 이후[[audio context]]재생에서 발생한 모든 언더런 이벤트의 총 지속 시간(초)으로 설정합니다. -
[[underrun events]]를 생성 이후[[audio context]]재생에서 발생한 언더런 이벤트의 총 개수로 설정합니다. -
[[total duration]]을[[underrun duration]]+[[audio context]].currentTime으로 설정합니다. -
[[average latency]]를현재 추적 중인 구간동안[[audio context]]재생의 평균 재생 지연 시간(초)으로 설정합니다. -
[[minimum latency]]를현재 추적 중인 구간동안[[audio context]]재생의 최소 재생 지연 시간(초)으로 설정합니다. -
[[maximum latency]]를현재 추적 중인 구간동안[[audio context]]재생의 최대 재생 지연 시간(초)으로 설정합니다.
1.33.4.
AudioPlaybackStats의
개인정보 보호 고려 사항
1.33.4.1. 위험
오디오 언더런 정보는 협력하는 두 사이트 사이에서 교차 사이트 은닉 채널을 형성하는 데 사용될 수 있습니다. 한 사이트는 의도적으로 오디오 글리치를 발생시켜 (예를 들어 CPU 사용량을 매우 높게 하여) 정보를 전송하고, 다른 사이트는 이러한 글리치를 감지할 수 있습니다.참고: 이 은닉 채널은 특정 시스템 특성에 따라 달라집니다. 일반적으로 공유된 직렬화 지점(OS 또는 브라우저 오디오 믹서 등)과 해당 지점에서 사실상 동기적인 콜백이 필요하며, 부하 급증을 평탄화할 중간 버퍼링이 없어야 합니다.
1.33.4.2. 완화 조치
이러한 은닉 채널의 사용을 억제하기 위해 API는 다음 완화 조치를 구현합니다.-
API가 반환하는 값은 초당 한 번보다 자주 업데이트해서는 안 됩니다.
-
API는 다음 조건 중 하나 이상을 충족하는 사이트로 반드시 제한해야 합니다:
-
사이트가 getUserMedia 권한을 얻었습니다.
참고: 그 이유는 사이트가 getUserMedia 권한을 얻었다면 마이크를 사용하여 글리치 정보를 수신하거나 효율적으로 통신할 수 있으므로
AudioPlaybackStats가 제공하는 정보에 대한 접근이 불필요해지기 때문입니다. 이러한 방법에는 마이크 신호의 공백을 통해 글리치를 감지하거나 사람이 들을 수 없는 사인파를 사용하여 통신하는 것이 포함됩니다. 마이크 접근이 이 측면에서 더 안전해진다면 이 조건을 재검토해야 합니다. -
문서가 완전히 활성 상태이고 해당 가시성 상태가
"visible"입니다.참고: 협력하는 어느 사이트도 마이크 권한이 없다고 가정하면, 이 기준은 은닉 신호를 수신하는 사이트가 반드시 표시되어 있어야 함을 보장하여 은닉 채널을 사용할 수 있는 조건을 제한합니다. 사이트가 표시되지 않은 동안에는 은닉 채널을 사용하여 서로 통신할 수 없게 합니다.
-
2. 처리 모델
2.1. 배경
이 절은 비규범적입니다.
낮은 지연 시간이 필요한 실시간 오디오 시스템은 흔히 콜백 함수를 사용하여 구현됩니다. 운영 체제는 재생이 중단되지 않도록 추가 오디오를 계산해야 할 때 프로그램을 다시 호출합니다. 이러한 콜백은 이상적으로 우선순위가 높은 스레드(흔히 시스템에서 가장 높은 우선순위)에서 호출됩니다. 이는 오디오를 처리하는 프로그램이 이 콜백에서만 코드를 실행한다는 의미입니다. 스레드 경계를 넘거나 렌더링 스레드와 콜백 사이에 버퍼링을 추가하면 자연스럽게 지연 시간이 늘어나거나 시스템의 글리치 내성이 낮아집니다.
이러한 이유로 웹 플랫폼에서 비동기 연산을 실행하는 전통적인 방법인 이벤트 루프는 여기에서 작동하지 않습니다. 스레드가 계속 실행되는 것이 아니기 때문입니다. 또한 기존 실행 컨텍스트(Window 및 Worker)에서는 불필요하고 잠재적으로 차단을 일으킬 수 있는 많은 연산을 사용할 수 있는데, 허용 가능한 수준의 성능을 달성하기 위해서는 바람직하지 않습니다.
또한 Worker 모델에서는 스크립트 실행 컨텍스트마다
전용 스레드를 생성해야 하지만, 모든 AudioNode는
일반적으로 동일한 실행 컨텍스트를 공유합니다.
참고: 이 절은 최종 결과가 어떻게 보여야 하는지를 지정하며, 어떻게 구현해야 하는지를 지정하지는 않습니다. 특히 구현자는 메시지 큐를 사용하는 대신 메모리 연산의 순서가 변경되지 않는 한 스레드 간에 공유되는 메모리를 사용할 수 있습니다.
2.2. 제어 스레드 및 렌더링 스레드
Web Audio API는 제어 스레드와 렌더링 스레드를 사용하여 반드시 구현해야 합니다.
제어 스레드는
AudioContext가
인스턴스화되고 작성자가 오디오 그래프를
조작하는 스레드, 즉 BaseAudioContext에
대한 연산이 호출되는 스레드입니다. 렌더링
스레드는 제어 스레드의 호출에
반응하여
실제 오디오 출력을 계산하는 스레드입니다. AudioContext의
오디오를 계산하는 경우 실시간 콜백 기반 오디오 스레드일 수 있고,
OfflineAudioContext의
오디오를 계산하는 경우 일반 스레드일 수 있습니다.
제어 스레드는 [HTML]에 설명된 전통적인 이벤트 루프를 사용합니다.
렌더링 스레드는 오디오 그래프 렌더링 절에 설명된 특수 렌더링 루프를 사용합니다
제어 스레드에서 렌더링 스레드로의 통신은 제어 메시지 전달을 사용하여 수행됩니다. 반대 방향의 통신은 일반 이벤트 루프 태스크를 사용하여 수행됩니다.
각 AudioContext에는
렌더링 스레드에서 실행되는
연산인 제어 메시지의 목록인 단일
제어
메시지 큐가 있습니다.
제어
메시지를 큐에 넣는 것은
메시지를 BaseAudioContext의
제어 메시지 큐 끝에
추가하는 것을 의미합니다.
참고: 예를 들어
AudioBufferSourceNode
source에서 start()를 성공적으로 호출하면
연관된 BaseAudioContext의
제어 메시지
큐에 제어
메시지가 추가됩니다.
제어 메시지는 제어 메시지 큐에서 삽입 시간 순으로 정렬됩니다. 따라서 가장 오래된 메시지는 제어 메시지 큐의 맨 앞에 있는 메시지입니다.
2.3. 비동기 작업
AudioNode에서
메서드를 호출하는 것은 사실상 비동기이며,
동기 부분과 비동기 부분의 두 단계로 반드시 수행해야 합니다.
각 메서드의 실행 일부는 제어 스레드에서
(예: 유효하지 않은 매개변수의 경우 예외 발생)
이루어지고, 일부는 렌더링
스레드에서(예: AudioParam의
값을 변경)
이루어집니다.
AudioNode 및
BaseAudioContext의
각 작업 설명에서 동기 절은 ⌛로 표시됩니다. 그 밖의 모든
작업은
병렬로 실행되며, 이는 [HTML]에 설명되어
있습니다.
동기 절은 제어 스레드에서 실행되며 즉시 수행됩니다. 실패하면 메서드 실행이 중단되고 예외가 발생할 수 있습니다. 성공하면 렌더링 스레드에서 실행할 연산을 인코딩한 제어 메시지가 이 렌더링 스레드의 제어 메시지 큐에 추가됩니다.
동기 절과 비동기 절은 다른 이벤트에 대해 반드시 동일한 순서를 가져야 합니다. 각각 동기 및 비동기 절 ASync와 AAsync, 그리고 BSync와 BAsync를 갖는 두 연산 A와 B가 주어졌을 때, A가 B보다 먼저 발생하면 ASync가 BSync보다 먼저 발생하고, AAsync가 BAsync보다 먼저 발생합니다. 즉 동기 절과 비동기 절의 순서를 변경할 수 없습니다.
2.4. 지원되는 샘플 레이트
구현은 3000 Hz 이상 768000 Hz 이하의 샘플 레이트를
반드시 지원해야 합니다. 이 범위를 벗어나는 샘플 레이트가 지정되면
NotSupportedError를
반드시 발생시켜야 합니다.
2.5. 지원되는 렌더 퀀텀 크기
구현은 1 샘플 프레임에서 컨텍스트 샘플 레이트의 6배까지의
[[render quantum size]]를
포함하여 반드시 지원해야 하며, 컨텍스트
샘플 레이트의 6배가 정수가 아니면 가장 가까운 정수로 내림합니다.
이 범위를 벗어나는 [[render quantum size]]가
지정되면 NotSupportedError를
반드시 발생시켜야 합니다.
ScriptProcessorNode
인터페이스를 최대 버퍼 크기 16384 및 지원되는 최소 샘플 레이트
3000 Hz에서 사용하는 애플리케이션을 지원하기 위해 선택되었습니다.
컨텍스트 샘플 레이트가 3000 Hz이면 지원되는 범위는 [1,
18000]입니다. 샘플 레이트가 높을수록 상한도 높아집니다.
2.6. 오디오 그래프 렌더링
오디오 그래프 렌더링은 샘플 프레임 블록 단위로 수행되며, 각
블록의 크기는 BaseAudioContext의
수명 동안 일정하게 유지됩니다. 블록의
샘플 프레임 수를 렌더 퀀텀
크기라고 하며, 블록
자체를 렌더
퀀텀이라고 합니다. 기본값은 128이며
renderSizeHint를
설정하여 구성할 수 있습니다.
주어진 스레드에서 원자적으로 발생하는 연산은 다른 스레드에서 다른 원자적 연산이 실행되고 있지 않을 때만 실행할 수 있습니다.
제어 메시지
큐
Q를 가진 BaseAudioContext
G에서 오디오 블록을 렌더링하는 알고리즘은 여러 단계로 구성되며
그래프 렌더링 알고리즘에서 더 자세히
설명합니다.
AudioContext
렌더링 스레드는
일정한 간격으로 주기적으로 호출되는
시스템 수준
오디오 콜백에 의해 구동됩니다. 각 호출에는 다음
시스템 수준
오디오 콜백이 도착하기 전에
제시간에 계산해야 하는 가변적인 샘플 프레임 수인
시스템 수준 오디오 콜백 버퍼
크기가 있습니다.
부하 값은
각 시스템
수준 오디오
콜백에 대해 계산되며, 해당 실행 시간을
시스템 수준
오디오 콜백 버퍼 크기를 sampleRate로
나눈 값으로 나누어 계산합니다.
이상적으로 부하 값은 1.0보다 작으며, 이는 오디오를 재생하는 데 걸린 시간보다 오디오를 렌더링하는 데 더 적은 시간이 걸렸음을 의미합니다. 이 부하 값이 1.0보다 크면 오디오 버퍼 언더런이 발생합니다. 즉 시스템이 실시간으로 충분히 빠르게 오디오를 렌더링하지 못한 것입니다.
시스템 수준
오디오 콜백과 부하
값 개념은 OfflineAudioContext에는
적용되지 않는다는 점에 유의하십시오.
오디오 콜백은 제어 메시지 큐에도 태스크로 큐에 들어갑니다.
UA는
요청된 버퍼 크기를 채워 이러한 태스크를 충족하도록 렌더 퀀텀을 처리하기 위해
다음 알고리즘을 반드시 수행해야 합니다. 제어 메시지
큐와 함께 각 AudioContext에는
제어 스레드에서 렌더링 스레드로 게시되는 태스크를 위한 일반
태스크
큐가 있으며, 이를 해당 연관된 태스크 큐라고 합니다.
렌더 퀀텀을 처리한 후에는 AudioWorkletProcessor의
process 메서드 실행 중 큐에 들어갔을 수 있는 마이크로태스크를
실행하기 위해 추가 마이크로태스크 체크포인트를 수행합니다.
AudioWorkletNode에서
게시된 모든 태스크는 연관된 BaseAudioContext의
연관된 태스크 큐에 게시됩니다.
-
BaseAudioContext의 내부 슬롯[[current frame]]을 0으로 설정합니다. 또한currentTime을 0으로 설정합니다.
-
render result를
false로 둡니다. -
제어 메시지 큐를 처리합니다.
-
Qrendering을 빈 제어 메시지 큐로 둡니다. Qrendering을 현재 제어 메시지 큐와 원자적으로 교환합니다.
-
Qrendering에 메시지가 있는 동안 다음 단계를 실행합니다:
-
Qrendering의 가장 오래된 메시지의 비동기 절을 실행합니다.
-
Qrendering의 가장 오래된 메시지를 제거합니다.
-
-
-
BaseAudioContext의 연관된 태스크 큐를 처리합니다.-
task queue를
BaseAudioContext의 연관된 태스크 큐로 둡니다. -
task count를 task queue에 있는 태스크 수로 둡니다
-
task count가 0이 아닌 동안 다음 단계를 실행합니다:
-
oldest task를 task queue의 첫 번째 실행 가능한 태스크로 두고 task queue에서 제거합니다.
-
렌더링 루프의 현재 실행 중인 태스크를 oldest task로 설정합니다.
-
oldest task의 단계를 수행합니다.
-
렌더링 루프의 현재 실행 중인 태스크를 다시
null로 설정합니다. -
task count를 1 감소시킵니다
-
마이크로태스크 체크포인트를 수행합니다.
-
-
-
렌더 퀀텀을 처리합니다.
-
BaseAudioContext의[[rendering thread state]]가running이 아니면 false를 반환합니다. -
BaseAudioContext의 처리할AudioNode를 정렬합니다.-
ordered node list를 빈
AudioNode및AudioListener목록으로 둡니다. 이 정렬 알고리즘이 종료되면 정렬된AudioNode목록과AudioListener를 포함하게 됩니다. -
nodes를 이
BaseAudioContext가 생성했으며 여전히 살아 있는 모든 노드의 집합으로 둡니다. -
AudioListener를 nodes에 추가합니다. -
cycle breakers를 빈
DelayNode집합으로 둡니다. 이는 사이클의 일부인 모든DelayNode를 포함하게 됩니다. -
nodes의 각
AudioNodenode에 대해:-
node가 사이클의 일부인
DelayNode이면 이를 cycle breakers에 추가하고 nodes에서 제거합니다.
-
-
cycle breakers의 각
DelayNodedelay에 대해:-
delayWriter와 delayReader를 각각 delay에 대한 DelayWriter와 DelayReader로 둡니다. delayWriter와 delayReader를 nodes에 추가합니다. delay를 모든 입력과 출력에서 연결 해제합니다.
참고: 이는 사이클을 끊습니다.
DelayNode가 사이클에 있으면 딜레이 라인은 사이클에 있을 때 하나의 렌더 퀀텀보다 작을 수 없으므로 양쪽 끝을 별도로 고려할 수 있습니다.
-
-
nodes에 사이클이 포함되어 있으면 이 사이클의 일부인 모든
AudioNode를 음소거하고 nodes에서 제거합니다. -
nodes의 모든 요소를 표시되지 않은 것으로 간주합니다. nodes에 표시되지 않은 요소가 있는 동안:
-
nodes에서 요소 node를 선택합니다.
-
node를 방문합니다.
-
-
ordered node list의 순서를 뒤집습니다.
-
-
이 블록에 대한
AudioListener의AudioParam의 값을 계산합니다. -
ordered node list의 각
AudioNode에 대해:-
이
AudioNode의 각AudioParam에 대해 다음 단계를 실행합니다:-
이
AudioParam에 연결된AudioNode가 있으면 이AudioParam에 연결된 모든AudioNode가 읽을 수 있게 만든 버퍼를 합산하고, 결과 버퍼를 모노 채널로 다운 믹싱한 다음, 이 버퍼를 입력 AudioParam 버퍼라고 합니다. -
이 블록에 대한 이
AudioParam의 값을 계산합니다. -
§ 1.6.3 값 계산에 따라 이
AudioParam의[[current value]]슬롯을 설정하도록 제어 메시지를 큐에 넣습니다.
-
-
이
AudioNode의 입력에 연결된AudioNode가 있으면 이AudioNode에 연결된 모든AudioNode가 읽을 수 있게 만든 버퍼를 합산합니다. 결과 버퍼를 입력 버퍼라고 합니다. 이AudioNode의 입력 채널 수와 일치하도록 업 믹싱 또는 다운 믹싱합니다. -
이
AudioNode가 소스 노드이면 오디오 블록을 계산하고 읽을 수 있게 만듭니다. -
이
AudioNode가AudioWorkletNode이면 다음 하위 단계를 실행합니다:-
processor를
AudioWorkletNode의 연관된AudioWorkletProcessor인스턴스로 둡니다. -
O를 processor에 대응하는 ECMAScript 객체로 둡니다.
-
processCallback을 초기화되지 않은 변수로 둡니다.
-
completion을 초기화되지 않은 변수로 둡니다.
-
스크립트 실행을 준비합니다. 이때 현재 설정 객체를 사용합니다.
-
콜백 실행을 준비합니다. 이때 현재 설정 객체를 사용합니다.
-
getResult를 Get(O, "process")로 둡니다.
-
getResult가 갑작스러운 완료이면 completion을 getResult로 설정하고 반환이라고 표시된 단계로 이동합니다.
-
processCallback을 getResult.[[Value]]로 설정합니다.
-
! IsCallable(processCallback)이
false이면:-
completion을 새 Completion {[[Type]]: throw, [[Value]]: 새로 생성된 TypeError 객체, [[Target]]: empty}로 설정합니다.
-
반환이라고 표시된 단계로 이동합니다.
-
-
[[callable process]]를true로 설정합니다. -
다음 하위 단계를 수행합니다:
-
args를
inputs,outputs, 및parameters로 구성된 Web IDL 인수 목록으로 둡니다. -
esArgs를 args를 ECMAScript 인수 목록으로 변환한 결과로 둡니다.
-
callResult를 Call(processCallback, O, esArgs)로 둡니다. 이 연산은 esArgs를 사용하여 오디오 블록을 계산합니다. 함수 호출에 성공하면
outputs를 통해 전달된Float32Array요소의 복사본을 포함하는 버퍼가 읽을 수 있게 됩니다. 이 호출 내에서 해결된 모든Promise는AudioWorkletGlobalScope의 마이크로태스크 큐에 추가됩니다. -
callResult가 갑작스러운 완료이면 completion을 callResult로 설정하고 반환이라고 표시된 단계로 이동합니다.
-
processor의 활성 소스 플래그를 ToBoolean(callResult.[[Value]])로 설정합니다.
-
-
반환: 이 시점에서 completion은 ECMAScript 완료 값으로 설정됩니다.
-
콜백 실행 후 정리합니다. 이때 현재 설정 객체를 사용합니다.
-
스크립트 실행 후 정리합니다. 이때 현재 설정 객체를 사용합니다.
-
completion이 갑작스러운 완료이면:
-
[[callable process]]를false로 설정합니다. -
processor의 활성 소스 플래그를
false로 설정합니다. -
태스크를 큐에 넣어 제어 스레드에서 연관된
AudioWorkletNode에ErrorEvent를 사용하여processorerror라는 이벤트를 발생시킵니다.
-
-
-
-
그렇지 않으면 입력 버퍼를 처리하고 결과 버퍼를 읽을 수 있게 만듭니다.
-
-
다음 단계를 원자적으로 수행합니다:
-
[[current frame]]을 렌더 퀀텀 크기만큼 증가시킵니다. -
currentTime을[[current frame]]을sampleRate로 나눈 값으로 설정합니다.
-
-
render result를
true로 설정합니다.
-
-
render result를 반환합니다.
AudioNode를
음소거한다는 것은
이 오디오 블록을 렌더링하는 동안 해당
출력이 반드시 무음이어야 함을 의미합니다.
AudioNode에서
버퍼를
읽을 수 있게 만든다는 것은
이 AudioNode에
연결된 다른 AudioNode가
해당 버퍼에서 안전하게 읽을 수 있는 상태로 만드는 것을
의미합니다.
참고: 예를 들어 구현은 새 버퍼를 할당하거나, 이제 사용하지 않는 기존 버퍼를 재사용하는 더 정교한 메커니즘을 선택할 수 있습니다.
AudioNode의
입력을 기록한다는 것은
이 AudioNode의
입력 데이터를 나중에 사용하기 위해
복사하는 것을 의미합니다.
오디오
블록을 계산한다는 것은
이 AudioNode에
대한 알고리즘을 실행하여
[[render quantum size]]
샘플 프레임을 생성하는 것을 의미합니다.
입력
버퍼를 처리한다는 것은
AudioNode에
대한 알고리즘을 실행하면서
입력
버퍼와 이
AudioNode의
AudioParam
값을
이 알고리즘의 입력으로 사용하는 것을 의미합니다.
2.7. AudioContext에서의
중단 처리
중단은 사용자 에이전트가
AudioContext의
오디오 재생을 중지해야 할 때 생성하는 이벤트입니다.
예를 들어 다른 애플리케이션이 오디오 출력 하드웨어에 대한
독점 접근을 요청하면 사용자 에이전트가 중단을 생성할 수 있습니다.
중단이 발생하면
사용자 에이전트는 AudioContext를
중단하기 위한 제어 메시지를 큐에 넣어야 합니다.
제어 메시지를 실행하여
AudioContext를
                중단
-
context의
[[rendering thread state]]가closed또는interrupted이면 이 단계를 중단합니다. -
context의
[[rendering thread state]]가running이면:-
시스템 리소스 해제를 시도합니다.
-
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
context의
[[control thread state]]를interrupted로 설정합니다. -
context의
[[state before interruption]]슬롯을 "running"으로 설정합니다. -
context에서
statechange라는 이벤트를 발생시킵니다.
-
-
-
context의
[[rendering thread state]]가suspended이면:-
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
context의
[[control thread state]]를interrupted로 설정합니다. -
context의
[[state before interruption]]슬롯을 "suspended"로 설정합니다.
-
-
-
context의
[[rendering thread state]]를interrupted로 설정합니다.
참고: AudioContext가
suspended이면
개인정보 보호를 위해 statechange
이벤트를 발생시키지 않습니다. 이는 예를 들어 전화가 걸려오거나 화면이
잠길 때 사용자 활동을 과도하게 노출하지 않기 위한 것입니다.
중단이 끝나면
사용자 에이전트는 end the
하기 위한 제어 메시지를 큐에
넣어야 합니다.AudioContext
interruption
AudioContext
context의
중단을 끝내기 위한
제어 메시지를
실행한다는 것은 렌더링
스레드에서 다음 단계를 실행하는 것을 의미합니다:
-
context의
[[rendering thread state]]가interrupted가 아니면 이 단계를 중단합니다. -
context의
[[state before interruption]]가 "running"이면:-
시스템 리소스 획득을 시도합니다.
-
AudioContext의[[rendering thread state]]를 "running"으로 설정합니다. -
오디오 그래프 렌더링을 시작합니다.
-
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
AudioContext의state속성이 아직 "running"이 아니면:-
context의
[[control thread state]]를 "running"으로 설정합니다. -
context에서
statechange라는 이벤트를 발생시킵니다.
-
-
-
-
context의
[[state before interruption]]가 "suspended"이면-
AudioContext의[[rendering thread state]]를suspended로 설정합니다. -
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
context의
[[control thread state]]를suspended로 설정합니다.
-
-
-
context의
[[state before interruption]]을null로 설정합니다.
2.8.
AudioContext에서
시스템 오디오 리소스 오류 처리
오디오 시스템 리소스 오류가 발생하면 AudioContext
audioContext는 렌더링 스레드에서 다음 단계를 수행합니다.
-
audioContext의
[[rendering thread state]]가running또는interrupted이면:-
시스템 리소스 해제를 시도합니다.
-
audioContext의
[[rendering thread state]]를suspended로 설정합니다. -
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
audioContext에서
error라는 이벤트를 발생시킵니다. -
audioContext의
[[suspended by user]]를false로 설정합니다. -
audioContext의
[[control thread state]]를suspended로 설정합니다. -
audioContext에서
statechange라는 이벤트를 발생시킵니다.
-
-
이 단계를 중단합니다.
-
-
audioContext의
[[rendering thread state]]가suspended이면:-
다음 단계를 실행하도록 미디어 요소 태스크를 큐에 넣습니다:
-
audioContext에서
error라는 이벤트를 발생시킵니다.
-
-
참고: 시스템 오디오 리소스 오류의 예로는
AudioContext가
활성 렌더링 중일 때 외부 또는 무선 오디오 장치의 연결이
끊어지는 경우가 있습니다.
2.9. 문서 언로드
BaseAudioContext를
사용하는 문서에는 추가 문서 언로드
정리 단계가 정의됩니다:
-
관련 전역 객체가 문서의 연결된 Window와 동일한 각
AudioContext및OfflineAudioContext에 대해[[pending promises]]의 모든 프로미스를InvalidStateError로 거부합니다. -
모든
decoding thread를 중지합니다. -
AudioContext또는OfflineAudioContext를close()하기 위한 제어 메시지를 큐에 넣습니다.
3. 동적 수명
3.1. 배경
참고: AudioContext와
AudioNode의
수명 특성에 대한 규범적 설명은
AudioContext 수명 및
AudioNode 수명에 설명되어 있습니다.
이 절은 비규범적입니다.
정적 라우팅 구성을 생성할 수 있는 것 외에도, 수명이 제한된 동적으로 할당된 보이스에 대해 사용자 정의 효과 라우팅을 수행할 수 있어야 합니다. 이 설명을 위해 이러한 수명이 짧은 보이스를 "노트"라고 하겠습니다. 많은 오디오 애플리케이션에서 노트라는 개념을 사용하며, 예로는 드럼 머신, 시퀀서 및 게임 플레이에 따라 다수의 원샷 사운드를 트리거하는 3D 게임이 있습니다.
전통적인 소프트웨어 신시사이저에서는 사용 가능한 리소스 풀에서 노트를 동적으로 할당하고 해제합니다. MIDI note-on 메시지를 받으면 노트를 할당합니다. 루프되지 않는 경우 샘플 데이터 끝에 도달했거나, 엔벌로프의 sustain 단계가 0에 도달했거나, MIDI note-off 메시지로 엔벌로프가 release 단계에 들어가 노트의 재생이 끝나면 이를 해제합니다. MIDI note-off의 경우 노트는 즉시 해제되지 않고 release 엔벌로프 단계가 완료될 때에만 해제됩니다. 어느 시점이든 많은 수의 노트가 재생될 수 있지만 새로운 노트가 라우팅 그래프에 추가되고 오래된 노트가 해제되므로 노트 집합은 계속해서 변경됩니다.
오디오 시스템은 개별 "노트" 이벤트에 대한
라우팅 그래프의 일부를 자동으로 해체합니다. "노트"는
다른 처리 노드에 직접 연결할 수 있는 AudioBufferSourceNode로
나타냅니다. 노트의 재생이 끝나면 컨텍스트가 자동으로
AudioBufferSourceNode에
대한 참조를 해제하며, 그 결과 연결된 모든 노드에 대한
참조도 해제되고 같은 방식으로 계속됩니다. 노드는 그래프에서 자동으로
연결 해제되며 더 이상 참조가 없으면 삭제됩니다. 수명이 길고
동적 보이스 간에 공유되는 그래프의 노드는 명시적으로 관리할 수 있습니다.
복잡하게 들릴 수 있지만 추가 처리가 필요 없이 이 모든 과정이
자동으로 수행됩니다.
3.2. 예제
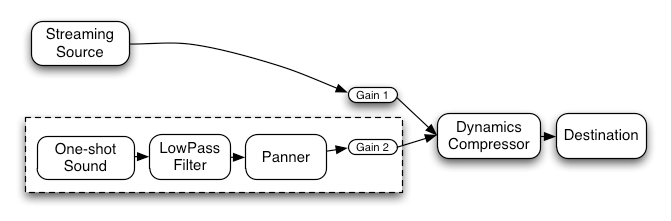
로우패스 필터, 패너 및 두 번째 게인 노드는 원샷 사운드에서 직접 연결됩니다. 따라서 재생이 끝나면 컨텍스트가 이들을 자동으로 해제합니다(점선 안의 모든 항목). 원샷 사운드와 연결된 노드에 더 이상 참조가 없으면 그래프에서 즉시 제거되고 삭제됩니다. 스트리밍 소스는 전역 참조를 가지며 명시적으로 연결 해제할 때까지 연결된 상태를 유지합니다. JavaScript에서는 다음과 같이 보일 수 있습니다:
let context= 0 ; let compressor= 0 ; let gainNode1= 0 ; let streamingAudioSource= 0 ; // 라우팅 그래프의 "수명이 긴" 부분을 초기 설정합니다 function setupAudioContext() { context= new AudioContext(); compressor= context. createDynamicsCompressor(); gainNode1= context. createGain(); // 스트리밍 오디오 소스를 생성합니다. const audioElement= document. getElementById( 'audioTagID' ); streamingAudioSource= context. createMediaElementSource( audioElement); streamingAudioSource. connect( gainNode1); gainNode1. connect( compressor); compressor. connect( context. destination); } // 나중에 사용자 동작(일반적으로 마우스 또는 키 이벤트)에 응답하여 // 원샷 사운드를 재생할 수 있습니다. function playSound() { const oneShotSound= context. createBufferSource(); oneShotSound. buffer= dogBarkingBuffer; // 필터, 패너 및 게인 노드를 생성합니다. const lowpass= context. createBiquadFilter(); const panner= context. createPanner(); const gainNode2= context. createGain(); // 연결합니다 oneShotSound. connect( lowpass); lowpass. connect( panner); panner. connect( gainNode2); gainNode2. connect( compressor); // 지금부터 0.75초 후에 재생합니다(즉시 재생하려면 0을 전달합니다) oneShotSound. start( context. currentTime+ 0.75 ); }
4. 채널 업 믹싱 및 다운 믹싱
이 절은 규범적입니다.
AudioNode 입력에는 연결된 모든 채널을 결합하기 위한 믹싱
규칙이 있습니다. 간단한 예로 입력이
모노 출력과 스테레오 출력에 연결되어 있으면 모노 연결은
일반적으로 스테레오로 업 믹싱된 뒤 스테레오 연결과 합산됩니다.
물론 모든 AudioNode의
모든 입력에 대한 정확한 믹싱
규칙을 정의하는 것이 중요합니다.
모든 입력의 기본 믹싱 규칙은 특히 매우 흔한 모노 및 스테레오
스트림의 경우 세부 사항을 크게 걱정하지 않아도
"그냥 작동"하도록 선택되었습니다. 물론 고급 사용 사례,
특히 다채널의 경우 규칙을 변경할 수 있습니다.
몇 가지 용어를 정의하면 업 믹싱은 더 적은 수의 채널을 가진 스트림을 더 많은 수의 채널을 가진 스트림으로 변환하는 과정을 의미합니다. 다운 믹싱은 더 많은 수의 채널을 가진 스트림을 더 적은 수의 채널을 가진 스트림으로 변환하는 과정을 의미합니다.
AudioNode
입력은 이 입력에 연결된 모든 출력을
믹싱해야 합니다. 이 과정의 일부로 특정 시점에서 입력의 실제
채널 수를 나타내는 내부 값 computedNumberOfChannels를 계산합니다.
AudioNode의
각 입력에 대해 구현은 다음을
반드시 수행해야 합니다:
-
computedNumberOfChannels를 계산합니다.
-
입력에 대한 각 연결에 대해:
-
노드의
channelInterpretation속성이 지정하는ChannelInterpretation값에 따라 연결을 computedNumberOfChannels로 업 믹싱하거나 다운 믹싱합니다. -
다른 연결의 모든 믹싱된 스트림과 함께 믹싱합니다. 이는 각 연결에 대해 1단계에서 업 믹싱 또는 다운 믹싱된 대응 채널을 단순히 합산하는 것입니다.
-
4.1. 스피커 채널 레이아웃
channelInterpretation이
"speakers"이면
특정 채널 레이아웃에 대해
업 믹싱과
다운 믹싱이 정의됩니다.
모노(1채널), 스테레오(2채널), 쿼드(4채널) 및 5.1(6채널)은 반드시 지원해야 합니다. 이 명세의 향후 버전에서는 다른 채널 레이아웃도 지원할 수 있습니다.
4.2. 채널 순서
채널 순서는 다음 표로 정의됩니다. 개별 다채널 형식은 모든 중간 채널을 지원하지 않을 수 있습니다. 구현은 존재하지 않는 채널을 건너뛰면서 아래에 정의된 순서로 제공되는 채널을 반드시 제시해야 합니다.
| 순서 | 레이블 | 모노 | 스테레오 | 쿼드 | 5.1 |
|---|---|---|---|---|---|
| 0 | SPEAKER_FRONT_LEFT | 0 | 0 | 0 | 0 |
| 1 | SPEAKER_FRONT_RIGHT | 1 | 1 | 1 | |
| 2 | SPEAKER_FRONT_CENTER | 2 | |||
| 3 | SPEAKER_LOW_FREQUENCY | 3 | |||
| 4 | SPEAKER_BACK_LEFT | 2 | 4 | ||
| 5 | SPEAKER_BACK_RIGHT | 3 | 5 | ||
| 6 | SPEAKER_FRONT_LEFT_OF_CENTER | ||||
| 7 | SPEAKER_FRONT_RIGHT_OF_CENTER | ||||
| 8 | SPEAKER_BACK_CENTER | ||||
| 9 | SPEAKER_SIDE_LEFT | ||||
| 10 | SPEAKER_SIDE_RIGHT | ||||
| 11 | SPEAKER_TOP_CENTER | ||||
| 12 | SPEAKER_TOP_FRONT_LEFT | ||||
| 13 | SPEAKER_TOP_FRONT_CENTER | ||||
| 14 | SPEAKER_TOP_FRONT_RIGHT | ||||
| 15 | SPEAKER_TOP_BACK_LEFT | ||||
| 16 | SPEAKER_TOP_BACK_CENTER | ||||
| 17 | SPEAKER_TOP_BACK_RIGHT |
4.3. 테일 타임이 입력 및 출력 채널 수에 미치는 영향
AudioNode에
0이 아닌 테일 타임이 있고
출력 채널 수가 입력 채널 수에 따라 달라지는 경우,
입력 채널 수가 변경될 때 AudioNode의
테일 타임을 반드시 고려해야 합니다.
입력 채널 수가 감소하면 더 많은 채널 수로 받은 입력이 더 이상 출력에 영향을 주지 않는 시점에 출력 채널 수의 변경이 반드시 발생해야 합니다.
입력 채널 수가 증가하면 동작은
AudioNode
유형에 따라 달라집니다:
-
DelayNode또는DynamicsCompressorNode의 경우 더 많은 채널 수로 받은 입력이 출력에 영향을 주기 시작할 때 출력 채널 수가 반드시 증가해야 합니다. -
테일 타임이 있는 다른
AudioNode의 경우 출력 채널 수가 즉시 증가해야 합니다.참고:
ConvolverNode의 경우 이는 임펄스 응답이 모노인 경우에만 적용됩니다. 그렇지 않으면ConvolverNode는 입력 채널 수와 관계없이 항상 스테레오 신호를 출력합니다.
참고: 직관적으로 이는 처리의 일부로 스테레오 정보가 손실되지 않도록 합니다. 서로 다른 채널 수를 가진 여러 입력 렌더 퀀텀이 하나의 출력 렌더 퀀텀에 기여하면 출력 렌더 퀀텀의 채널 수는 입력 렌더 퀀텀의 입력 채널 수의 상위 집합입니다.
4.4. 스피커 레이아웃 업 믹싱
모노 업 믹싱:

    1 -> 2 : 모노에서 스테레오로 업 믹싱
        output.L = input;
        output.R = input;

    1 -> 4 : 모노에서 쿼드로 업 믹싱
        output.L = input;
        output.R = input;
        output.SL = 0;
        output.SR = 0;

    1 -> 5.1 : 모노에서 5.1로 업 믹싱
        output.L = 0;
        output.R = 0;
        output.C = input; // 중앙 채널에 배치
        output.LFE = 0;
        output.SL = 0;
        output.SR = 0;

스테레오 업 믹싱:

    2 -> 4 : 스테레오에서 쿼드로 업 믹싱
        output.L = input.L;
        output.R = input.R;
        output.SL = 0;
        output.SR = 0;

    2 -> 5.1 : 스테레오에서 5.1로 업 믹싱
        output.L = input.L;
        output.R = input.R;
        output.C = 0;
        output.LFE = 0;
        output.SL = 0;
        output.SR = 0;

쿼드 업 믹싱:

    4 -> 5.1 : 쿼드에서 5.1로 업 믹싱
        output.L = input.L;
        output.R = input.R;
        output.C = 0;
        output.LFE = 0;
        output.SL = input.SL;
        output.SR = input.SR;
4.5. 스피커 레이아웃 다운 믹싱
예를 들어 5.1 소스 자료를 처리하지만 스테레오로 재생하는 경우 다운 믹싱이 필요합니다.
모노 다운 믹싱:

    2 -> 1 : 스테레오에서 모노로
        output = 0.5 * (input.L + input.R);

    4 -> 1 : 쿼드에서 모노로
        output = 0.25 * (input.L + input.R + input.SL + input.SR);

    5.1 -> 1 : 5.1에서 모노로
        output = sqrt(0.5) * (input.L + input.R) + input.C + 0.5 * (input.SL + input.SR)

스테레오 다운 믹싱:

    4 -> 2 : 쿼드에서 스테레오로
        output.L = 0.5 * (input.L + input.SL);
        output.R = 0.5 * (input.R + input.SR);

    5.1 -> 2 : 5.1에서 스테레오로
        output.L = L + sqrt(0.5) * (input.C + input.SL)
        output.R = R + sqrt(0.5) * (input.C + input.SR)

쿼드 다운 믹싱:

    5.1 -> 4 : 5.1에서 쿼드로
        output.L = L + sqrt(0.5) * input.C
        output.R = R + sqrt(0.5) * input.C
        output.SL = input.SL
        output.SR = input.SR
4.6. 채널 규칙 예제
// 게인 노드를 명시적인 2채널(스테레오)로 설정합니다. gain. channelCount= 2 ; gain. channelCountMode= "explicit" ; gain. channelInterpretation= "speakers" ; // 두 개의 스테레오 출력 버스를 사용하는 DJ 앱을 위해 "하드웨어 출력"을 4채널로 설정합니다. context. destination. channelCount= 4 ; context. destination. channelCountMode= "explicit" ; context. destination. channelInterpretation= "discrete" ; // 사용자 정의 다채널 스피커 배열을 위해 "하드웨어 출력"을 8채널로 설정합니다 // 사용자 정의 행렬 믹싱을 사용합니다. context. destination. channelCount= 8 ; context. destination. channelCountMode= "explicit" ; context. destination. channelInterpretation= "discrete" ; // HTMLAudioElement를 재생하도록 "하드웨어 출력"을 5.1로 설정합니다. context. destination. channelCount= 6 ; context. destination. channelCountMode= "explicit" ; context. destination. channelInterpretation= "speakers" ; // 명시적으로 모노로 다운 믹싱합니다. gain. channelCount= 1 ; gain. channelCountMode= "explicit" ; gain. channelInterpretation= "speakers" ;
5. 오디오 신호 값
5.1. 오디오 샘플 형식
선형 펄스 코드 변조(선형 PCM)는 오디오 값을 일정한 간격으로 샘플링하고, 연속된 두 값 사이의 양자화 레벨이 선형적으로 균일한 형식을 설명합니다.
이 명세에서 신호 값이 스크립트에 노출될 때마다
선형 32비트 부동소수점 펄스 코드 변조 형식(선형 32비트 float
PCM)이며, 흔히 Float32Array
객체 형태입니다.
5.2. 렌더링
모든 오디오 그래프의 대상 노드에서 모든 오디오 신호의 범위는
명목상 [-1, 1]입니다. 이 범위를 벗어나는 신호 값이나
NaN, 양의 무한대 또는 음의 무한대 값의 오디오 렌더링은
이 명세에서 정의하지 않습니다.
6. 공간화/패닝
6.1. 배경
현대 3D 게임의 일반적인 기능 요구 사항은 3D 공간에서 여러 오디오 소스를 동적으로 공간화하고 이동할 수 있는 기능입니다. 예를 들어 OpenAL에는 이 기능이 있습니다.
PannerNode를
사용하면 오디오 스트림을 AudioListener를
기준으로 공간화하거나 공간에 배치할 수 있습니다.
BaseAudioContext에는
단일 AudioListener가
포함됩니다. 패너와 리스너 모두 오른손 데카르트 좌표계를
사용하는 3D 공간의 위치를 가집니다. 좌표계에서 사용하는 단위는
정의되지 않으며, 이러한 좌표로 계산하는 효과는 미터나 피트와 같은
특정 단위와 독립적이고 불변이므로 정의할 필요도 없습니다.
소스 스트림을 나타내는 PannerNode
객체에는 사운드가 어느 방향으로 투사되는지를 나타내는
방향 벡터가 있습니다. 또한 사운드의 방향성이 얼마나 강한지를
나타내는 사운드 콘이 있습니다. 예를 들어 사운드는
무지향성일 수 있으며, 이 경우 방향과 관계없이 어느 곳에서나 들을 수
있고, 더 방향성이 강하여 리스너를 향할 때만 들릴 수도 있습니다.
사람의 귀를 나타내는 AudioListener
객체에는 사람이 어느 방향을 바라보는지 나타내는
forward 및 up 벡터가 있습니다.
공간화를 위한 좌표계는 아래 다이어그램에 표시되어 있으며,
기본값도 함께 표시됩니다. 더 잘 볼 수 있도록
AudioListener와
PannerNode의
위치는 기본 위치에서 이동되어 있습니다.
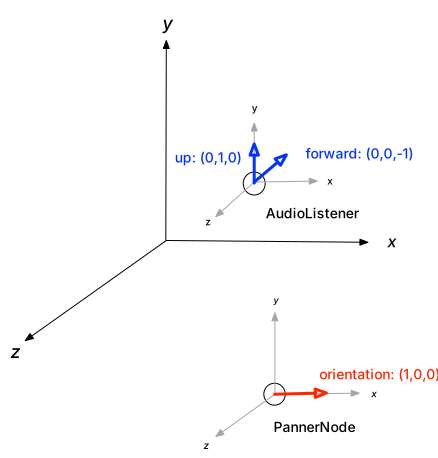
렌더링 중 PannerNode는
방위각과 고도각을 계산합니다. 이러한 값은
공간화 효과를 렌더링하기 위해 구현 내부에서 사용됩니다.
이러한 값이 어떻게 사용되는지에 대한 자세한 내용은
패닝 알고리즘 절을 참조하십시오.
6.2. 방위각 및 고도각
PannerNode의
방위각과 고도각을 계산하려면 다음 알고리즘을
반드시 사용해야 합니다. 구현은 아래의 여러 AudioParam이
"a-rate"인지
"k-rate"인지
적절하게 고려해야 합니다.
// |context|를 BaseAudioContext로, |panner|를 |context|에서 생성된 // PannerNode로 둡니다. // 소스-리스너 벡터를 계산합니다. const listener= context. listener; const sourcePosition= new Vec3( panner. positionX. value, panner. positionY. value, panner. positionZ. value); const listenerPosition= new Vec3( listener. positionX. value, listener. positionY. value, listener. positionZ. value); const sourceListener= sourcePosition. diff( listenerPosition). normalize(); if ( sourceListener. magnitude== 0 ) { // 소스와 리스너가 같은 지점에 있는 퇴화 사례를 처리합니다. azimuth= 0 ; elevation= 0 ; return ; } // 축을 정렬합니다. const listenerForward= new Vec3( listener. forwardX. value, listener. forwardY. value, listener. forwardZ. value); const listenerUp= new Vec3( listener. upX. value, listener. upY. value, listener. upZ. value); const listenerRight= listenerForward. cross( listenerUp); if ( listenerRight. magnitude== 0 ) { // 리스너의 'up'과 'forward' 벡터가 선형 종속인 경우를 처리합니다. // 이 경우 'right'를 결정할 수 없습니다 azimuth= 0 ; elevation= 0 ; return ; } // 리스너의 right와 forward에 직교하는 단위 벡터를 결정합니다 const listenerRightNorm= listenerRight. normalize(); const listenerForwardNorm= listenerForward. normalize(); const up= listenerRightNorm. cross( listenerForwardNorm); const upProjection= sourceListener. dot( up); const projectedSource= sourceListener. diff( up. scale( upProjection)). normalize(); azimuth= 180 * Math. acos( projectedSource. dot( listenerRightNorm)) / Math. PI; // 소스가 리스너의 앞 또는 뒤에 있습니다. const frontBack= projectedSource. dot( listenerForwardNorm); if ( frontBack< 0 ) azimuth= 360 - azimuth; // 방위각을 리스너의 "right" 벡터가 아닌 "forward" 벡터를 기준으로 만듭니다. if (( azimuth>= 0 ) && ( azimuth<= 270 )) azimuth= 90 - azimuth; else azimuth= 450 - azimuth; elevation= 90 - 180 * Math. acos( sourceListener. dot( up)) / Math. PI; if ( elevation> 90 ) elevation= 180 - elevation; else if ( elevation< - 90 ) elevation= - 180 - elevation;
6.3. 패닝 알고리즘
모노-스테레오 및 스테레오-스테레오 패닝을 반드시 지원해야 합니다. 입력에 대한 모든 연결이 모노이면 모노-스테레오 처리를 사용합니다. 그렇지 않으면 스테레오-스테레오 처리를 사용합니다.
6.3.1. PannerNode "equalpower" 패닝
이는 기본적이지만 합리적인 결과를 제공하는 간단하고
비교적 저비용의 알고리즘입니다. PannerNode의
panningModel
속성이 "equalpower"로
설정된 경우 사용되며, 이 경우 고도각
값은 무시됩니다. 이 알고리즘은 automationRate에
지정된 적절한 속도를 사용하여 반드시 구현해야 합니다.
PannerNode의
AudioParam
또는 AudioListener의
AudioParam
중
하나라도 "a-rate"이면
a-rate 처리를 반드시 사용해야 합니다.
-
이
AudioNode가 계산할 각 샘플에 대해:-
azimuth를 방위각 및 고도각 절에서 계산한 값으로 둡니다.
-
먼저 azimuth 값을 다음에 따라 [-90, 90] 범위에 포함되도록 합니다:
// 먼저 방위각을 허용 범위 [-180, 180]으로 제한합니다. azimuth= max( - 180 , azimuth); azimuth= min( 180 , azimuth); // 그런 다음 [-90, 90] 범위로 래핑합니다. if ( azimuth< - 90 ) azimuth= - 180 - azimuth; else if ( azimuth> 90 ) azimuth= 180 - azimuth; -
모노 입력의 경우 정규화된 값 x를 azimuth에서 다음과 같이 계산합니다:
x
= ( azimuth+ 90 ) / 180 ; 또는 스테레오 입력의 경우:
if ( azimuth<= 0 ) { // -90 -> 0 // 방위각 값을 [-90, 0]도에서 [-90, 90] 범위로 변환합니다. x= ( azimuth+ 90 ) / 90 ; } else { // 0 -> 90 // 방위각 값을 [0, 90]도에서 [-90, 90] 범위로 변환합니다. x= azimuth/ 90 ; } -
왼쪽 및 오른쪽 게인 값은 다음과 같이 계산합니다:
gainL
= cos( x* Math. PI/ 2 ); gainR= sin( x* Math. PI/ 2 ); -
모노 입력의 경우 스테레오 출력은 다음과 같이 계산합니다:
outputL
= input* gainL; outputR= input* gainR; 그렇지 않고 스테레오 입력의 경우 출력은 다음과 같이 계산합니다:
if ( azimuth<= 0 ) { outputL= inputL+ inputR* gainL; outputR= inputR* gainR; } else { outputL= inputL* gainL; outputR= inputR+ inputL* gainR; } -
거리는 거리 효과에서, 콘 게인은 사운드 콘에서 설명된 대로 거리 게인과 콘 게인을 적용합니다:
let distance= distance(); let distanceGain= distanceModel( distance); let totalGain= coneGain() * distanceGain(); outputL= totalGain* outputL; outputR= totalGain* outputR;
-
6.3.2. PannerNode "HRTF" 패닝(스테레오 전용)
이를 위해 다양한 방위각과 고도각에서 기록한 HRTF (머리 관련 전달 함수) 임펄스 응답 집합이 필요합니다. 구현에는 고도로 최적화된 컨볼루션 함수가 필요합니다. "equalpower"보다 다소 비용이 많이 들지만 지각적으로 더 공간화된 사운드를 제공합니다.
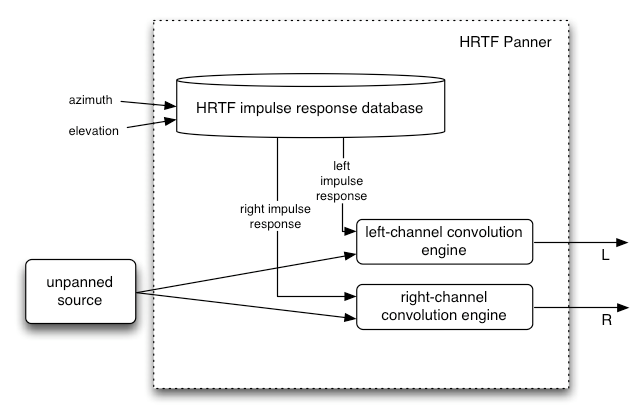
6.3.3. StereoPannerNode 패닝
StereoPannerNode에
대해 다음 알고리즘을
반드시 구현해야 합니다.
-
이
AudioNode가 계산할 각 샘플에 대해-
pan을 이
StereoPannerNode의panAudioParam의 computedValue로 둡니다. -
pan을 [-1, 1]로 제한합니다.
pan
= max( - 1 , pan); pan= min( 1 , pan); -
pan 값을 [0, 1]로 정규화하여 x를 계산합니다. 모노 입력의 경우:
x
= ( pan+ 1 ) / 2 ; 스테레오 입력의 경우:
if ( pan<= 0 ) x= pan+ 1 ; else x= pan; -
왼쪽 및 오른쪽 게인 값은 다음과 같이 계산합니다:
gainL
= cos( x* Math. PI/ 2 ); gainR= sin( x* Math. PI/ 2 ); -
모노 입력의 경우 스테레오 출력은 다음과 같이 계산합니다:
outputL
= input* gainL; outputR= input* gainR; 그렇지 않고 스테레오 입력의 경우 출력은 다음과 같이 계산합니다:
if ( pan<= 0 ) { outputL= inputL+ inputR* gainL; outputR= inputR* gainR; } else { outputL= inputL* gainL; outputR= inputR+ inputL* gainR; }
-
6.4. 거리 효과
더 가까운 사운드는 더 크고, 더 먼 사운드는 더 작습니다.
리스너와의 거리에 따라 사운드의 음량이 정확히 어떻게
변경되는지는 distanceModel
속성에 따라 달라집니다.
오디오 렌더링 중 distance 값은 다음과 같이 패너와 리스너의 위치를 기반으로 계산됩니다:
function distance( panner) { const pannerPosition= new Vec3( panner. positionX. value, panner. positionY. value, panner. positionZ. value); const listener= context. listener; const listenerPosition= new Vec3( listener. positionX. value, listener. positionY. value, listener. positionZ. value); return pannerPosition. diff( listenerPosition). magnitude; }
그 다음 distance는 distanceModel
속성에 따라 달라지는 distanceGain을 계산하는 데 사용됩니다.
각 거리 모델에 대해 이를 계산하는 방법에 대한 자세한 내용은
DistanceModelType
절을 참조하십시오.
PannerNode는
처리의 일부로 입력 오디오 신호를 distanceGain으로
스케일링/곱하여 먼 사운드는 더 작게, 가까운 사운드는 더 크게 만듭니다.
6.5. 사운드 콘
리스너와 각 사운드 소스에는 어느 방향을 바라보는지 설명하는 방향 벡터가 있습니다. 각 사운드 소스의 사운드 투사 특성은 소스의 방향 벡터에 대한 소스/리스너 각도의 함수로 사운드 강도를 설명하는 내부 및 외부 "콘"으로 표현됩니다. 따라서 사운드 소스가 리스너를 직접 향하면 축을 벗어난 방향을 향할 때보다 더 크게 들립니다. 사운드 소스는 무지향성일 수도 있습니다.
다음 다이어그램은 리스너를 기준으로 소스의
콘이 어떤 관계를 가지는지 보여 줍니다. 다이어그램에서
coneInnerAngle
= 50coneOuterAngle
= 120
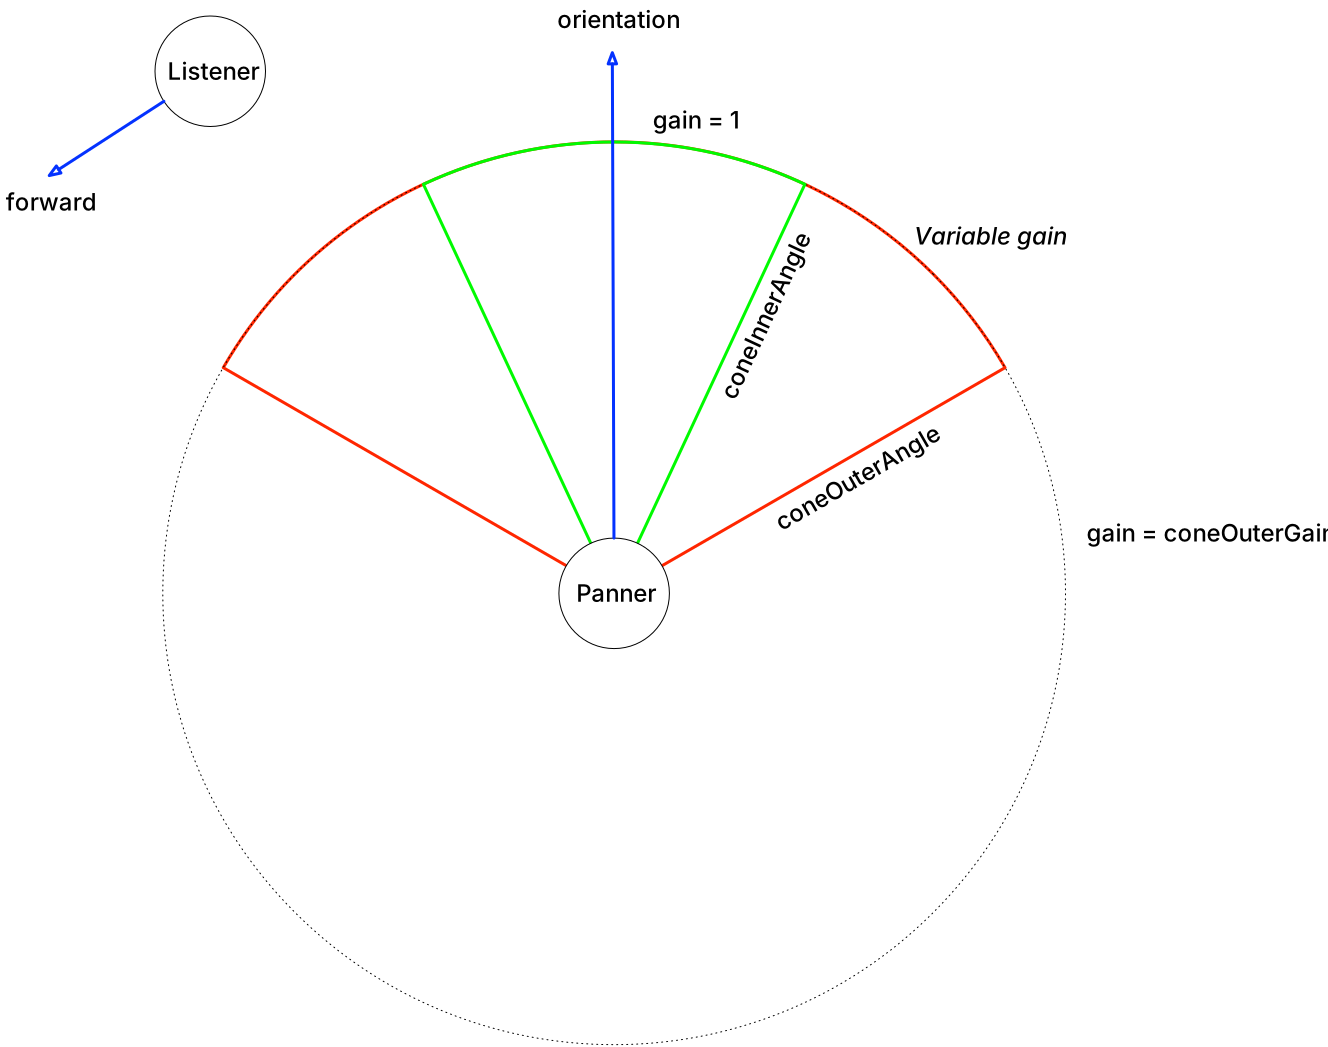
소스(PannerNode)와
리스너가 주어졌을 때 콘 효과로 인한 게인 기여도를 계산하려면
다음 알고리즘을 반드시 사용해야 합니다:
function coneGain() { const sourceOrientation= new Vec3( source. orientationX, source. orientationY, source. orientationZ); if ( sourceOrientation. magnitude== 0 || (( source. coneInnerAngle== 360 ) && ( source. coneOuterAngle== 360 ))) return 1 ; // 콘이 지정되지 않음 - 단위 게인 // 정규화된 소스-리스너 벡터 const sourcePosition= new Vec3( panner. positionX. value, panner. positionY. value, panner. positionZ. value); const listenerPosition= new Vec3( listener. positionX. value, listener. positionY. value, listener. positionZ. value); const sourceToListener= sourcePosition. diff( listenerPosition). normalize(); const normalizedSourceOrientation= sourceOrientation. normalize(); // 소스 방향 벡터와 소스-리스너 벡터 사이의 각도 const angle= 180 * Math. acos( sourceToListener. dot( normalizedSourceOrientation)) / Math. PI; const absAngle= Math. abs( angle); // API는 반각이 아니라 전체 각도이므로 여기서 2로 나눕니다 const absInnerAngle= Math. abs( source. coneInnerAngle) / 2 ; const absOuterAngle= Math. abs( source. coneOuterAngle) / 2 ; let gain= 1 ; if ( absAngle<= absInnerAngle) { // 감쇠 없음 gain= 1 ; } else if ( absAngle>= absOuterAngle) { // 최대 감쇠 gain= source. coneOuterGain; } else { // 내부 콘과 외부 콘 사이 // 내부 -> 외부, x는 0 -> 1로 변합니다 const x= ( absAngle- absInnerAngle) / ( absOuterAngle- absInnerAngle); gain= ( 1 - x) + source. coneOuterGain* x; } return gain; }
7. 성능 고려 사항
7.1. 지연 시간
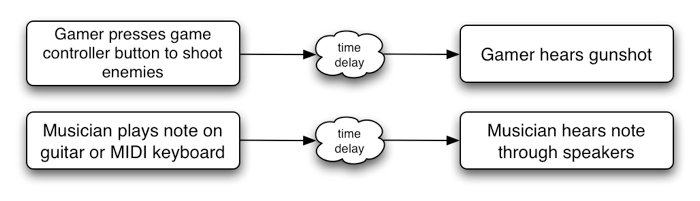
웹 애플리케이션에서는 마우스 및 키보드 이벤트(keydown, mousedown 등)와 사운드가 들리는 시점 사이의 시간 지연이 중요합니다.
이 시간 지연을 지연 시간이라고 하며 여러 요인 (입력 장치 지연 시간, 내부 버퍼링 지연 시간, DSP 처리 지연 시간, 출력 장치 지연 시간, 사용자의 귀와 스피커 사이의 거리 등)에 의해 발생하며 누적됩니다. 지연 시간이 클수록 사용자 경험은 덜 만족스러워집니다. 극단적인 경우에는 음악 제작이나 게임 플레이가 불가능해질 수 있습니다. 중간 정도의 수준에서는 타이밍에 영향을 주고 사운드가 늦게 따라오거나 게임이 반응하지 않는 듯한 인상을 줄 수 있습니다. 음악 애플리케이션에서는 타이밍 문제가 리듬에 영향을 줍니다. 게임에서는 타이밍 문제가 게임 플레이의 정밀도에 영향을 줍니다. 인터랙티브 애플리케이션에서는 일반적으로 매우 낮은 애니메이션 프레임 레이트와 마찬가지로 사용자 경험의 품질을 떨어뜨립니다. 애플리케이션에 따라 합리적인 지연 시간은 3~6밀리초처럼 낮은 값부터 25~50밀리초까지일 수 있습니다.
구현은 일반적으로 전체 지연 시간을 최소화하려고 합니다.
전체 지연 시간을 최소화하는 것과 함께 구현은 일반적으로
AudioContext의
currentTime과
AudioProcessingEvent의
playbackTime 사이의 차이도 최소화하려고 합니다.
ScriptProcessorNode가
사용 중단됨에 따라 이 고려 사항의 중요성은 시간이 지나면서
줄어들 것입니다.
또한 일부 AudioNode는
오디오 그래프의 일부 경로에 지연 시간을 추가할 수 있으며,
특히 다음과 같습니다:
-
AudioWorkletNode는 내부적으로 버퍼링하는 스크립트를 실행하여 신호 경로에 지연을 추가할 수 있습니다. -
DelayNode의 역할은 제어된 지연 시간을 추가하는 것입니다. -
BiquadFilterNode및IIRFilterNode의 필터 설계는 인과적 필터링 과정의 자연스러운 결과로 들어오는 샘플을 지연시킬 수 있습니다. -
ConvolverNode는 임펄스에 따라 컨볼루션 연산의 자연스러운 결과로 들어오는 샘플을 지연시킬 수 있습니다. -
DynamicsCompressorNode에는 신호 경로에 지연을 일으키는 룩어헤드 알고리즘이 있습니다. -
MediaStreamAudioSourceNode,MediaStreamTrackAudioSourceNode및MediaStreamAudioDestinationNode는 구현에 따라 내부적으로 지연을 추가하는 버퍼를 사용할 수 있습니다. -
ScriptProcessorNode는 제어 스레드와 렌더링 스레드 사이에 버퍼를 가질 수 있습니다. -
WaveShaperNode는 오버샘플링할 때 오버샘플링 기법에 따라 신호 경로에 지연을 추가합니다.
7.2. 오디오 버퍼 복사
AudioBuffer에서
콘텐츠 획득
연산을 수행할 때 전체 연산은 일반적으로 채널 데이터를 복사하지 않고
구현할 수 있습니다. 특히 마지막 단계는 다음
getChannelData()
호출 시 지연하여 수행해야 합니다.
이는 사이에 getChannelData()
호출이 없는 연속된 콘텐츠 획득 연산 시퀀스
(예: 동일한 AudioBuffer를
재생하는 여러 AudioBufferSourceNode)를
할당이나 복사 없이 구현할 수 있음을 의미합니다.
구현은 추가 최적화를 수행할 수 있습니다. AudioBuffer에서
getChannelData()가
호출되었고, 새로운 ArrayBuffer가
아직 할당되지 않았지만 AudioBuffer에
대한 이전 콘텐츠 획득 연산을 호출한 모든 주체가
AudioBuffer의
데이터 사용을 중지했다면 원시 데이터 버퍼를 새로운
AudioBuffer에서
사용하도록 재활용하여 채널 데이터의 재할당이나 복사를
방지할 수 있습니다.
7.3. AudioParam 전환
AudioParam의
value
속성을 직접 설정할 때 자동 평활화는 수행되지 않지만,
특정 매개변수의 경우 값을 직접 설정하는 것보다 부드러운
전환이 더 바람직합니다.
낮은 timeConstant와 함께 setTargetAtTime()
메서드를 사용하면 작성자가 부드러운
전환을 수행할 수 있습니다.
7.4. 오디오 글리칭
오디오 글리치는 정상적인 연속 오디오 스트림이 중단되어 큰 클릭음과 팝음을 발생시키는 현상입니다. 이는 멀티미디어 시스템의 치명적인 실패로 간주되며 반드시 피해야 합니다. 적절한 우선순위와 시간 제약을 갖지 못한 스레드로 인한 스케줄링 지연 시간 등 오디오 스트림을 하드웨어에 전달하는 스레드의 문제로 발생할 수 있습니다. 또한 CPU 속도를 고려했을 때 오디오 DSP가 실시간으로 가능한 것보다 더 많은 작업을 수행하려 할 때도 발생할 수 있습니다.
8. 개인정보 보호 고려 사항
자체 검토 설문지: 보안 및 개인정보 보호 § 질문에 따르면:
-
이 명세는 개인 식별 정보와 관련이 있습니까?
Web Audio API를 사용하여 청력 검사를 수행할 수 있으므로 한 사람이 들을 수 있는 주파수 범위(나이가 들수록 감소)를 알아낼 수 있습니다. 그러나 적극적인 참여가 필요하므로 사용자가 인지하고 동의하지 않은 상태에서 이를 수행하기는 어렵습니다.
-
이 명세는 고가치 데이터와 관련이 있습니까?
아니요. 신용카드 정보 등은 Web Audio에서 사용되지 않습니다. Web Audio를 사용하여 음성 데이터를 처리하거나 분석할 수 있어 개인정보 보호 문제가 될 수 있지만, 사용자의 마이크에 대한 접근은
getUserMedia()를 통해 권한을 기반으로 합니다. -
이 명세는 탐색 세션 사이에 지속되는 출처의 새로운 상태를 도입합니까?
아니요. AudioWorklet은 탐색 세션 사이에 지속되지 않습니다.
-
이 명세는 지속되는 교차 출처 상태를 웹에 노출합니까?
예. 지원되는 오디오 샘플 레이트와 출력 장치 채널 수가 노출됩니다.
AudioContext를 참조하십시오. -
이 명세는 출처가 현재 접근할 수 없는 다른 데이터를 노출합니까?
예. 사용 가능한 여러
AudioNode에 대한 다양한 정보를 제공할 때 Web Audio API는AudioNode인터페이스를 사용하는 모든 페이지에 클라이언트의 특징적인 정보 (예: 오디오 하드웨어 샘플 레이트)를 잠재적으로 노출합니다. 또한AnalyserNode또는ScriptProcessorNode인터페이스를 통해 타이밍 정보를 수집할 수 있습니다. 이후 이 정보를 사용하여 클라이언트의 핑거프린트를 생성할 수 있습니다.Princeton CITP의 Web Transparency and Accountability Project 연구에서는
DynamicsCompressorNode와OscillatorNode를 사용하여 클라이언트에서 엔트로피를 수집하고 장치를 핑거프린팅할 수 있음을 보여 주었습니다. 이는 서로 다른 구현 사이의 DSP 아키텍처, 리샘플링 전략 및 반올림 절충에서 발생하는 작고 일반적으로 들리지 않는 차이 때문입니다. 사용된 정확한 컴파일러 플래그와 CPU 아키텍처(ARM 대 x86)도 이 엔트로피에 기여합니다.그러나 실제로는 "플랫폼 Y에서 실행 중인 브라우저 X"와 같이 더 쉬운 방법(User Agent 문자열)으로 이미 쉽게 얻을 수 있는 정보를 추론할 수 있게 해 줄 뿐입니다. 하지만 추가적인 핑거프린팅 가능성을 줄이기 위해 브라우저가 모든 노드의 출력에서 발생할 수 있는 핑거프린팅 문제를 완화하기 위한 조치를 취하도록 요구합니다.
클록 스큐를 통한 핑거프린팅은 Steven J Murdoch와 Sebastian Zander가 설명했습니다.
getOutputTimestamp에서 이를 알아낼 수 있을 가능성이 있습니다. 스큐 기반 핑거프린팅은 Nakibly 등이 HTML에 대해 시연하기도 했습니다. 클록 해상도와 드리프트에 대한 자세한 내용은 High Resolution Time § 10. 개인정보 보호 고려 사항 절을 참조해야 합니다.지연 시간을 통한 핑거프린팅도 가능합니다.
baseLatency와outputLatency에서 이를 추론할 수 있을 가능성이 있습니다. 완화 전략에는 정확한 스큐가 잘못 보고되도록 지터(디더링)와 양자화를 추가하는 것이 포함됩니다. 그러나 대부분의 오디오 시스템은 WebAudio가 생성한 오디오를 다른 오디오나 비디오 소스 또는 시각적 신호(예: 게임, 오디오 녹음 또는 음악 제작 환경)와 동기화하기 위해 낮은 지연 시간을 목표로 한다는 점에 유의하십시오. 과도한 지연 시간은 사용성을 떨어뜨리고 접근성 문제가 될 수 있습니다.AudioContext의 샘플 레이트를 통한 핑거프린팅도 가능합니다. 이를 최소화하기 위해 다음 단계를 수행할 것을 권장합니다:-
44.1 kHz와 48 kHz를 기본 레이트로 허용하며, 시스템은 가장 적합한 것을 선택합니다. (오디오 장치의 네이티브 레이트가 44.1이면 당연히 44.1을 선택하는 식이지만, 시스템은 가장 "호환되는" 레이트를 선택할 수도 있습니다. 예를 들어 시스템이 네이티브로 96kHz이면 44.1kHz가 아니라 48kHz가 선택될 가능성이 높습니다.
-
네이티브 레이트가 다른 장치의 경우 리샘플링된 오디오로 인해 배터리 소모가 추가될 수 있음에도 시스템이 이 두 레이트 중 하나로 리샘플링해야 합니다. (역시 시스템은 가장 호환되는 레이트를 선택합니다. 예를 들어 네이티브 시스템이 16kHz이면 48kHz가 선택될 것으로 예상됩니다.)
-
브라우저가 예를 들어 장치의 브라우저에 플래그를 설정하여 네이티브 레이트 사용을 강제하는 사용자 기능을 제공할 것으로 예상되지만 의무 사항은 아닙니다. 이 설정은 API에 노출되지 않습니다.
-
AudioContext생성자에서 다른 레이트를 명시적으로 요청할 수도 있을 것으로 예상됩니다 (이는 이미 명세에 포함되어 있으며 일반적으로 요청한 sampleRate로 오디오 렌더링을 수행한 다음 장치 출력에 맞게 업샘플링 또는 다운샘플링합니다). 해당 레이트가 네이티브로 지원되면 렌더링을 그대로 전달할 수 있습니다. 이를 통해 앱은 사용자의 개입 없이 더 높은 레이트로 렌더링할 수 있습니다(Web Audio에서는 오디오 출력이 출력 시 다운샘플링되지 않았는지 관찰할 수 없지만). 예를 들어MediaDevices기능을 사용자 개입으로 읽고 더 높은 레이트가 지원된다고 표시된 경우가 해당됩니다.
AudioContext의 렌더 퀀텀 크기를 통한 핑거프린팅은"hardware"힌트를 사용할 때 가능하며, 사용자의 기본 오디오 하드웨어 버퍼 크기에 대한 정보를 노출합니다. 이 위험을 최소화하기 위해renderQuantumSize는AudioContext가"running"상태로 전환될 때까지 0을 반환합니다.AudioContext가"running"상태로 전환되면 실제 렌더 퀀텀 크기를 반환합니다. 실행 중인 AudioContext는AudioWorklet타이밍을 통해 사용자의 오디오 하드웨어 버퍼 크기를 추론하는 데 사용할 수 있으므로 새로운 정보를 노출하지 않습니다.AudioContext의 출력 채널 수를 통한 핑거프린팅도 가능합니다.maxChannelCount를 2(스테레오)로 설정할 것을 권장합니다. 스테레오는 압도적으로 가장 일반적인 채널 수입니다. -
-
이 명세는 출처가 사용자의 위치에 접근할 수 있도록 합니까?
아니요.
-
이 명세는 출처가 사용자 장치의 센서에 접근할 수 있도록 합니까?
직접적으로는 아닙니다. 현재 오디오 입력은 이 문서에 명시되어 있지 않지만, 클라이언트 시스템의 오디오 입력 또는 마이크에 대한 접근이 필요합니다. 이는 적절한 방식으로 사용자에게 권한을 요청해야 하며, 아마도
getUserMedia()API를 통해 이루어질 것입니다.또한 Media Capture and Streams 명세의 보안 및 개인정보 보호 고려 사항에도 유의해야 합니다. 특히 주변 오디오를 분석하거나 고유한 오디오를 재생하면 사용자의 위치를 방 단위까지 식별하거나, 서로 다른 사용자 또는 장치가 동시에 같은 방에 있는지까지 식별할 수 있습니다. 오디오 출력과 오디오 입력 모두에 접근하면 하나의 브라우저에서 서로 분할된 컨텍스트 사이의 통신도 가능해질 수 있습니다.
-
이 명세는 출처가 사용자의 로컬 컴퓨팅 환경의 측면에 접근할 수 있도록 합니까?
직접적으로는 아닙니다. 요청된 모든 샘플 레이트를 지원하며 필요한 경우 업샘플링합니다. Media Capture and Streams를 사용하여 MediaTrackSupportedConstraints로 지원되는 오디오 샘플 레이트를 조사할 수 있습니다. 여기에는 명시적인 사용자 동의가 필요합니다. 이는 소량의 핑거프린팅 정보를 제공합니다. 그러나 실제로 대부분의 소비자 및 프로슈머 장치는 두 가지 표준화된 샘플 레이트 중 하나를 사용합니다. 44.1kHz(CD에서 처음 사용)와 48kHz(DAT에서 처음 사용)입니다. 리소스가 매우 제한된 장치는 음성 품질의 11kHz 샘플 레이트를 지원할 수 있고, 고급 장치는 흔히 88.2, 96 또는 오디오파일용 192kHz 레이트를 지원합니다.
모든 구현이 48kHz와 같이 하나의 일반적으로 지원되는 레이트로 업샘플링하도록 요구하면 특별한 이점 없이 CPU 비용이 증가하고, 고급 장치가 더 낮은 레이트를 사용하도록 요구하면 Web Audio가 전문적인 용도에 부적합하다는 평가를 받을 뿐입니다.
-
이 명세는 임시 식별자를 웹에 노출합니까?
아니요.
-
이 명세는 퍼스트 파티와 서드 파티 컨텍스트에서 동작을 구분합니까?
아니요.
-
이 명세는 사용자 에이전트의 "시크릿" 모드에서 어떻게 동작해야 합니까?
다르게 동작하지 않습니다.
-
이 명세는 사용자의 로컬 장치에 데이터를 영구 저장합니까?
아니요.
-
이 명세에는 "보안 고려 사항" 및 "개인정보 보호 고려 사항" 절이 있습니까?
예(현재 읽고 계신 절입니다).
9. 보안 고려 사항
자체 검토 설문지: 보안 및 개인정보 보호 § 질문에 따르면:
-
이 명세는 새로운 스크립트 실행/로딩 메커니즘을 활성화합니까?
아니요. 이 명세에서는 [HTML] 명세에 정의된 스크립트 실행 방법을 사용합니다.
-
이 명세는 출처가 다른 장치에 접근할 수 있도록 합니까?
일반적으로 다른 네트워크 장치에 대한 접근은 허용하지 않습니다 (고급 녹음 스튜디오의 Dante 네트워크 장치는 예외가 될 수 있지만, 일반적으로 별도의 전용 네트워크를 사용합니다). 그러나 필요에 따라 사용자의 오디오 출력 장치에 접근할 수 있도록 하며, 이러한 장치는 컴퓨터와 분리된 장치일 때도 있습니다.
음성 또는 사운드로 작동하는 장치의 경우 Web Audio API를 사용하여 다른 장치를 제어할 수도 있습니다. 또한 사운드 작동 장치가 초음파에 가까운 주파수에 민감한 경우 이러한 제어가 들리지 않을 수도 있습니다. 이 가능성은 HTML의 <audio> 또는 <video> 요소를 통해서도 존재합니다. 일반적인 오디오 샘플링 레이트에서는 설계상 초음파 정보를 위한 여유가 충분하지 않습니다:
인간 청력의 한계는 일반적으로 20kHz라고 합니다. 44.1kHz 샘플링 레이트의 나이퀴스트 한계는 22.05kHz입니다. 실제 벽돌벽 필터는 물리적으로 구현할 수 없으므로 20kHz와 22.05kHz 사이의 공간은 나이퀴스트 이상의 모든 주파수를 강하게 감쇠하는 급격한 롤오프 필터에 사용됩니다.
48kHz 샘플링 레이트에서도 20kHz~24kHz 대역에는 급격한 감쇠가 존재합니다(다만 통과 대역의 위상 리플 오류를 피하기는 더 쉽습니다).
-
이 명세는 출처가 사용자 에이전트의 네이티브 UI를 어느 정도 제어할 수 있도록 합니까?
UI에 음성 비서나 스크린 리더와 같은 오디오 구성 요소가 있으면 Web Audio API를 사용하여 네이티브 UI의 일부 측면을 모방함으로써 공격을 로컬 시스템 이벤트처럼 보이게 할 수 있습니다. 이 가능성은 HTML의 <audio> 요소를 통해서도 존재합니다.
-
이 명세는 기본 보안 특성을 약화할 수 있도록 합니까?
아니요.
10. 요구 사항 및 사용 사례
[webaudio-usecases]를 참조하십시오.
11. 명세 코드의 공통 정의
이 절에서는 이 명세에서 사용하는 JavaScript 코드가 사용하는 공통 함수와 클래스를 설명합니다.
// 3차원 벡터 클래스입니다. class Vec3{ // 3개의 좌표로 생성합니다. constructor ( x, y, z) { this . x= x; this . y= y; this . z= z; } // 다른 벡터와 내적합니다. dot( v) { return ( this . x* v. x) + ( this . y* v. y) + ( this . z* v. z); } // 다른 벡터와 외적합니다. cross( v) { return new Vec3(( this . y* v. z) - ( this . z* v. y), ( this . z* v. x) - ( this . x* v. z), ( this . x* v. y) - ( this . y* v. x)); } // 다른 벡터와의 차를 구합니다. diff( v) { return new Vec3( this . x- v. x, this . y- v. y, this . z- v. z); } // 이 벡터의 크기를 가져옵니다. get magnitude() { return Math. sqrt( dot( this )); } // 이 벡터에 스칼라를 곱한 복사본을 가져옵니다. scale( s) { return new Vec3( this . x* s, this . y* s, this . z* s); } // 이 벡터의 정규화된 복사본을 가져옵니다. normalize() { const m= magnitude; if ( m== 0 ) { return new Vec3( 0 , 0 , 0 ); } return scale( 1 / m); } }
12. 변경 로그
12.1. 2024년 11월 5일 최초 공개 작업 초안 이후
- PR 2688: 추측성 PR 미리보기 수정
- PR 2686: 개인정보 보호 고려 사항과 보안 고려 사항을 별도 절로 분리
- PR 2679: Slack 등록 링크 추가
- PR 2676: expected-errs.txt 형식 업데이트
- PR 2675: OfflineAudioContext 증분/청크 렌더링
- PR 2667: 렌더 퀀텀 크기 범위 제약 조건 및 renderSizeHint 처리 지정
- PR 2657: 구현이 [3000, 768000] Hz 샘플 레이트 범위를 지원하도록 요구
- PR 2656: expected-errs.txt 수정
- PR 2654: 기본적인 오타 수정
- PR 2633: sink ID에 대한 interrupted 상태 및 오류 처리 추가
- PR 2617: currentTime 문구 수정
13. 감사의 말
이 명세는 W3C Audio Working Group의 공동 작업입니다.
작업 그룹의 현재 및 이전 구성원과 명세 기여자는 다음과 같습니다
(작성 시점 기준, 알파벳순):
Adenot, Paul (Mozilla Foundation) - 명세 공동 편집자;
Akhgari, Ehsan (Mozilla Foundation);
Becker, Steven (Microsoft Corporation);
Berkovitz, Joe (초청 전문가, Noteflight/Hal Leonard 소속) - 2013년 9월부터
2017년 12월까지 WG 공동 의장;
Bossart, Pierre (Intel Corporation);
Borins, Myles (Google, Inc);
Buffa, Michel (NSAU);
Caceres, Marcos (초청 전문가);
Cardoso, Gabriel (INRIA);
Carlson, Eric (Apple, Inc);
Chen, Bin (Baidu, Inc);
Choi, Hongchan (Google, Inc) - 명세 공동 편집자;
Collichio, Lisa (Qualcomm);
Geelnard, Marcus (Opera Software);
Gehring, Todd (Dolby Laboratories);
Goode, Adam (Google, Inc);
Gregan, Matthew (Mozilla Foundation);
Hikawa, Kazuo (AMEI);
Hofmann, Bill (Dolby Laboratories);
Jägenstedt, Philip (Google, Inc);
Jeong, Paul Changjin (HTML5 Converged Technology Forum);
Kalliokoski, Jussi (초청 전문가);
Lee, WonSuk (Electronics and Telecommunications Research Institute);
Kakishita, Masahiro (AMEI);
Kawai, Ryoya (AMEI);
Kostiainen, Anssi (Intel Corporation);
Lilley, Chris (W3C 직원);
Lowis, Chris (초청 전문가) - 2012년 12월부터 2013년 9월까지 WG 공동 의장, British
Broadcasting Corporation 소속;
MacDonald, Alistair (W3C 초청 전문가) — 2011년 3월부터 2012년 7월까지 WG 공동 의장;
Mandyam, Giridhar (Qualcomm Innovation Center, Inc);
Michel, Thierry (W3C/ERCIM);
Nair, Varun (Facebook);
Needham, Chris (British Broadcasting Corporation);
Noble, Jer (Apple, Inc);
O’Callahan, Robert(Mozilla Foundation);
Onumonu, Anthony (British Broadcasting Corporation);
Paradis, Matthew (British Broadcasting Corporation) - 2013년 9월부터 현재까지 WG 공동 의장;
Pozdnyakov, Mikhail (Intel Corporation);
Raman, T.V. (Google, Inc);
Rogers, Chris (Google, Inc);
Schepers, Doug (W3C/MIT);
Schmitz, Alexander (JS Foundation);
Shires, Glen (Google, Inc);
Smith, Jerry (Microsoft Corporation);
Smith, Michael (W3C/Keio);
Thereaux, Olivier (British Broadcasting Corporation);
Toy, Raymond (Google, Inc.) - 2017년 12월부터 현재까지 WG 공동 의장;
Toyoshima, Takashi (Google, Inc);
Troncy, Raphael (Institut Telecom);
Verdie, Jean-Charles (MStar Semiconductor, Inc.);
Wei, James (Intel Corporation);
Weitnauer, Michael (IRT);
Wilson, Chris (Google,Inc);
Zergaoui, Mohamed (INNOVIMAX)